◆ 워크플로 vs 에이전트
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 1.3 구조 패턴 고르기 · D1 설계 17%Select appropriate architectural patterns (workflow, agentic, augmented LLM)
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 1.3① 도구를 부르면 에이전트인가? — 워크플로 vs 에이전트 가르기
한눈에
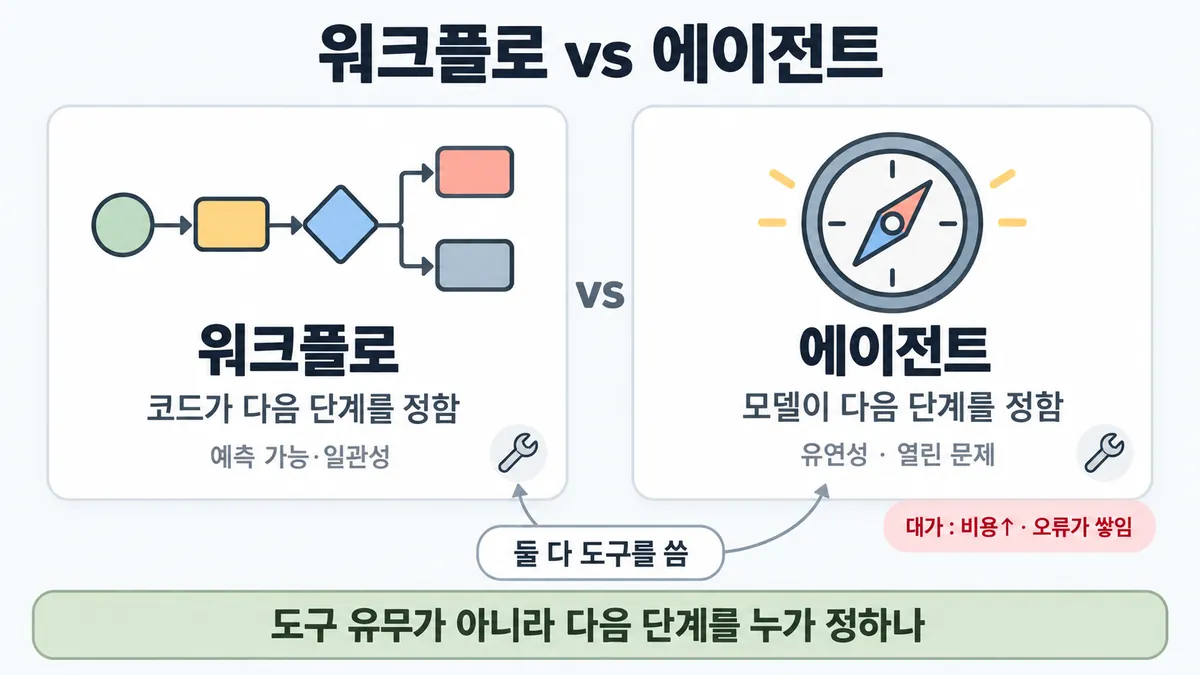
ELI5
요리책을 보고 만들지, 냉장고를 열어 보고 그때그때 정할지 고르는 거예요.
- 만들 음식이 정해져 있으면 요리책 순서대로 하는 게 제일 안전해요.
- 뭐가 들어 있을지 모르는 냉장고면 열어 보고 다음 할 일을 정해야 해요.
- 그때그때 정하면 더 오래 걸리고, 가끔 이상한 음식이 나와요.
- 칼을 몇 개 쓰는지는 상관없어요. 순서를 누가 정하는지가 중요해요.
개념 설명
원리
가르는 축은 하나다
- 축은 다음 단계를 누가 정하나다. 코드가 미리 정해 두면 워크플로다. 모델이 실행 중에 정하면 에이전트다.
- 도구 호출은 둘 다 한다. 워크플로 안의 각 호출도 검색(retrieval)·도구·메모리가 붙은 LLM(증강 LLM)을 쓴다. 그래서 "도구를 쓴다" 는 가르는 기준이 아니다.
워크플로가 이기는 이유
- 경로가 코드에 있다. 그래서 중간 단계에 코드 검사(gate)를 넣을 수 있다. 매 단계가 무엇을 할지 알아서 평가·테스트가 쉽다.
- 한 호출이 한 가지 일에 집중한다. 그래서 대개 정확도가 오른다.
- 대신 유연성이 없다. 미리 그린 입력·단계 밖의 일은 못 받는다.
에이전트가 이기는 이유
- 필요한 단계 수를 미리 알 수 없는 열린 문제를 푼다. 매 걸음 도구 결과(ground truth)를 보고 다음을 정한다.
- 예상 못 한 상황에서 도구를 뜻밖의 방식으로 묶어 푼다. 필요하면 사용자에게 되묻는다.
- 대신 대가가 있다.
- 비용이 오른다
- 지연(latency)이 늘어난다
- 오류가 쌓인다
- 완료율이 내려간다
- 계측·평가가 어렵다
- 그래서 모델 결정을 어느 정도 믿을 수 있어야 한다. 샌드박스 테스트·가드레일·멈춤 조건도 따라붙는다.
순서
- 더 단순한 것부터 본다. 단일 LLM 호출에 검색·예시를 붙이면 대개 충분하다. 에이전트 시스템을 아예 안 만드는 것도 답이다.
- 복잡도는 결과가 나아진다는 증거가 있을 때만 더한다.
핵심 질문 두 개
- 이 일의 단계를 지금 종이에 다 그릴 수 있나?
- 못 그린다면, 모델이 정한 다음 걸음을 믿고 맡길 만한 안전장치가 있나?
규칙과 판단
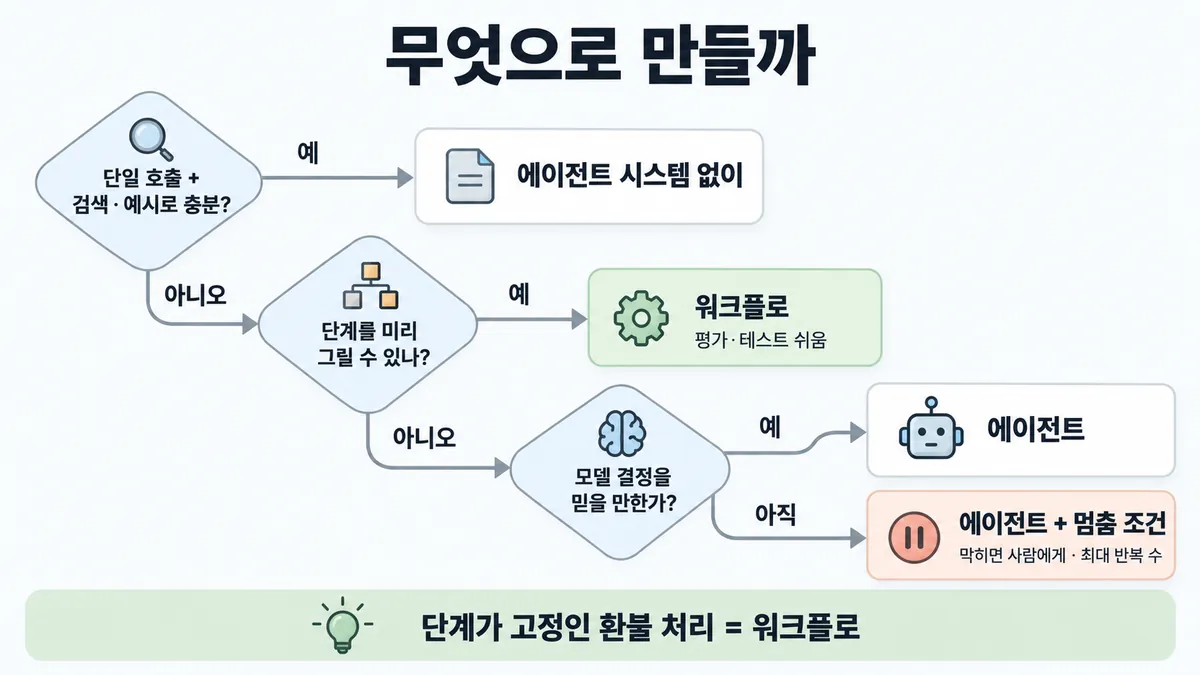
갈림길
더 단순한 걸로 되나 [1.3①] [1.3③]
에이전트 시스템 없이 간다
단일 LLM 호출에 검색(retrieval)·예시를 붙이면 대개 충분하다
다음 물음 — 단계를 미리 그릴 수 있나?
누가 다음 단계를 정하나 [1.3①]
워크플로
미리 정한 코드 경로로 간다. 예측 가능하고 일관된다. 한 단계씩 집중한다. 평가·테스트가 쉽다
에이전트
필요한 단계 수를 예측하기 어렵거나 불가능하다. 고정 경로를 하드코딩하지 못한다. 모델 결정을 어느 정도 믿는다. 샌드박스에서 충분히 테스트하고 가드레일을 둔다
에이전트 + 막히면 사람에게 · 멈춤 조건
에이전트는 비용이 오르고 오류가 쌓일 수 있다. 그래서 샌드박스에서 충분히 테스트하고 가드레일을 둔다. 체크포인트에서나 막히면 사람에게 돌아온다. 멈춤 조건(최대 반복 수)을 둔다
무엇을 포기하나 [1.3①]
유연성
도구를 뜻밖의 방식으로 묶는다. 예상 못 한 상황을 처리한다
비용·오류·평가
비용이 오른다. 오류가 쌓일 수 있다. 과제 완료율이 내려간다. 계측·평가가 어렵다
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 코드 → 모델 → 도구
질문 : 다음 단계는 누가 정할까?
① 워크플로 ✓
- 시작 : 코드 — 쪽지 : 환불 요청 #5521 / 순서: 자격 → 정책 → 처리 → 알림
- 경로 : 코드 → 모델 : 미리 정한 코드 경로로 간다 — 쪽지 : 1단계: 자격 확인 / (순서는 코드가 정함)
- 판정 : 모델 → 코드 — 쪽지 : { 자격: true }
- 검사 : 코드 : 중간 단계에서 코드가 검사(gate)한다 — 쪽지 : gate: 자격 = true / → 2단계 정책 확인
- 끝 : 코드가 다음 단계를 정한다. 예측 가능하고 일관된다
② 에이전트 ✓
- 시작 : 코드 — 말 : “결제가 가끔 두 번 나가요, 원인 찾아 줘”
- 넘김 : 코드 → 모델 : 목표와 도구만 준다 — 쪽지 : 목표 + 도구 목록 / 다음 단계는 모델이
- 결정 : 모델 → 도구 : 모델이 스스로 도구를 정한다 — 쪽지 : search_logs("중복 결제")
- 결과 : 도구 → 모델 : 매 걸음 ground truth(도구 결과)를 받는다 — 쪽지 : 로그 2건: 재시도가 / 결제를 한 번 더 보냄
- 끝 : 필요한 단계 수를 예측하기 어려운 열린 문제다
③ 도구를 부르니 에이전트? ≠
- 시작 : 코드 — 쪽지 : 환불 요청 #5521 / 순서: 자격 → 정책 → 처리 → 알림
- 경로 : 코드 → 모델 : 미리 정한 코드 경로로 간다 — 쪽지 : 3단계: 처리 / (순서는 코드가 정함)
- 호출 : 모델 → 도구 : 도구를 여러 개 부른다 — 쪽지 : cancel_payment(5521) / send_mail(고객)
- 끝 : 도구를 불러도 순서는 코드가 정한다. 기준은 도구 유무가 아니라 다음 단계를 누가 정하나다
규칙 원문 갈림 기준 (갈림길로 그린 규칙)
갈림 기준
기준은 다음 단계를 누가 정하나다. 도구 유무가 아니다
- 워크플로는 LLM·도구를 미리 정한 코드 경로로 엮는다. 그래서 코드가 다음 단계를 정한다. 잘 정의된 일에 예측 가능성과 일관성을 준다
- 에이전트는 LLM 이 스스로 과정과 도구 사용을 정한다. 유연성과 모델 주도 결정이 필요할 때 쓴다
- 에이전트를 쓰는 때는 이렇다
- 필요한 단계 수를 예측하기 어렵거나 불가능하다
- 고정 경로를 하드코딩하지 못한다
- 모델 결정을 어느 정도 믿는다
대가 : 에이전트 시스템은 지연(latency)·비용을 내고 성능을 얻는다. 에이전트는 비용이 오르고 오류가 쌓일 수 있다. 그래서 샌드박스에서 충분히 테스트하고 가드레일을 둔다
- 워크플로는 한 단계씩 집중한다. 그래서 대개 정확도가 오르고, 평가·테스트가 훨씬 쉽다. 에이전트는 과제 완료율이 내려가고, 계측·평가와 동작 예측이 어렵다 (Skilljar)
- 에이전트 운전은 세 가지다
- 매 걸음 환경에서 ground truth(도구 결과·코드 실행)로 진척을 확인한다
- 체크포인트에서나 막히면 사람에게 돌아온다
- 멈춤 조건(최대 반복 수)을 둔다
- 에이전트의 실체는 환경 피드백을 보며 도구를 쓰는 루프의 LLM 이다. 그래서 구현은 대개 단순하다. 도구 세트와 문서가 핵심이다
- 자세한 것은 ■ 도구 설계 에 있다. 루프 제어는 ■ stop_reason 으로 분기 에서 다룬다
- 앱 UX 가 사용자를 정해진 작업 몇 개로 묶으면 워크플로다. 어떤 과제·값이 올지 모르면 에이전트다 (Skilljar)
- 먼저 가장 단순한 해법을 본다. 단일 LLM 호출에 검색·예시를 붙이면 대개 충분하다. 복잡도는 결과가 나아질 때만 더한다 (어디서 멈추나는 1.3③ 쪽)
- 워크플로 안에서 무엇을 고르나는 ■ 워크플로 5패턴 에서 다룬다
- 여러 에이전트로 갈지는 ◆ 단일 vs 멀티 에이전트 에서 다룬다
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
| 단일 호출과 검색·예시로 충분하다 | 에이전트 시스템 없이 간다 | building-effective-agents |
| 단계를 미리 그릴 수 있다 · 잘 정의된 일이다 | 워크플로를 쓴다 | building-effective-agents · Skilljar 287796 |
| 앱 UX 가 사용자를 정해진 작업 몇 개로 묶는다 | 워크플로를 쓴다 | Skilljar 287796 |
| 필요한 단계 수를 예측하기 어렵거나 불가능하다 · 고정 경로를 하드코딩하지 못한다 | 에이전트를 쓴다 | building-effective-agents |
| 어떤 과제·값이 올지 모른다 | 에이전트를 쓴다 | Skilljar 287796 |
| 에이전트를 택했다 | 매 걸음 ground truth 를 확인한다. 체크포인트와 멈춤 조건(최대 반복 수)을 둔다. 샌드박스에서 테스트하고 가드레일을 둔다 | building-effective-agents |
| 둘 다 가능해 보인다 | 되는 곳은 워크플로로 한다. 에이전트는 꼭 필요할 때만 쓴다 | Skilljar 287794 |
| 프레임워크를 쓸지 고민한다 | LLM API 직접부터 시작한다. 쓰면 밑단 코드를 이해한다 | building-effective-agents |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 단계 | 고정이다 (자격 확인, 정책 확인, 처리, 알림) | 워크플로 | 판단 규칙 2 | |
| 단계 | 입력에 따라 수·종류가 바뀐다 (반복 장애 원인 조사) | 에이전트 | 판단 규칙 4 | |
| 도구 수 | 많다 | 가르는 기준이 아니다. 단계를 누가 정하나로 가른다 | building-effective-agents (모든 호출이 증강 LLM) | |
| 요구 | 예측 가능 · 감사 가능 · 일관성 | 워크플로 | building-effective-agents | |
| 요구 | 예상 못 한 요청 처리 · 유연한 사용자 경험 | 에이전트 | Skilljar 287794 | |
| 비용 여유 | 작다 · 호출량이 많다 | 워크플로 쪽이다 (에이전트 토큰은 채팅 대비 약 4배다) | 계산 | 뒤집히는 때 2 |
| 모델 결정 신뢰 | 낮다 · 되돌리기 어려운 동작이 있다 | 에이전트여도 체크포인트·사람 확인을 둔다 | building-effective-agents | |
| 평가 가능성 | 단계별 검사가 필요하다 | 워크플로 (gate) | building-effective-agents |
연습 문제
쇼핑몰 환불 처리는 늘 자격 확인, 정책 확인, 처리, 알림 순서로 간다고정 경로. 단계마다 주문 조회 · 결제 취소 · 메일 발송 도구를 부른다. 팀은 "도구를 여러 개 부르니 에이전트로 만들자"고 한다. 무엇으로 만들어야 하나?
시험 대비
함정
- "도구를 여러 개 부르니 에이전트다" 는 함정이다. 기준은 도구 유무가 아니라 누가 다음 단계를 정하나다. 워크플로 안의 호출도 도구를 쓴다
- 환불 처리(자격 확인, 정책 확인, 처리, 알림)처럼 단계가 고정인 일에 에이전트를 쓰는 것은 함정이다. 고정 경로는 워크플로다
- "고정 스키마 대량 변환에 에이전트를 쓴다" 는 함정이다. 단계가 미리 그려지면 워크플로다
- "강한 모델이니 자율 에이전트가 기본 업그레이드다" 는 함정이다. 복잡도는 결과가 나아질 때만 더한다
- "orchestrator-workers 는 모델이 하위작업을 정하니 에이전트다" 는 함정이다. 공식 분류는 워크플로 패턴이다
- "에이전트는 복잡한 프레임워크부터 시작한다" 는 함정이다. LLM API 직접부터 시작한다. 많은 패턴이 코드 몇 줄이다
- "에이전트면 끝날 때까지 알아서 돈다" 는 함정이다. 멈춤 조건(최대 반복 수)과 체크포인트를 둔다
- "'에이전트' 는 완전 자율만 뜻한다" 는 함정이다. Anthropic 은 둘 다 agentic systems 로 묶고 구조로 구분한다
신호
"Workflows are systems where LLMs and tools are orchestrated through predefined code paths."
"Agents, on the other hand, are systems where LLMs dynamically direct their own processes and tool usage, maintaining control over how they accomplish tasks."
"Agents can be used for open-ended problems where it’s difficult or impossible to predict the required number of steps, and where you can’t hardcode a fixed path."
"Agentic systems often trade latency and cost for better task performance, and you should consider when this tradeoff makes sense."
"workflows offer predictability and consistency for well-defined tasks, whereas agents are the better option when flexibility and model-driven decision-making are needed at scale."
"The autonomous nature of agents means higher costs, and the potential for compounding errors."
"The general recommendation is to always focus on implementing workflows where possible, and only resort to agents when they are truly required." (Skilljar)
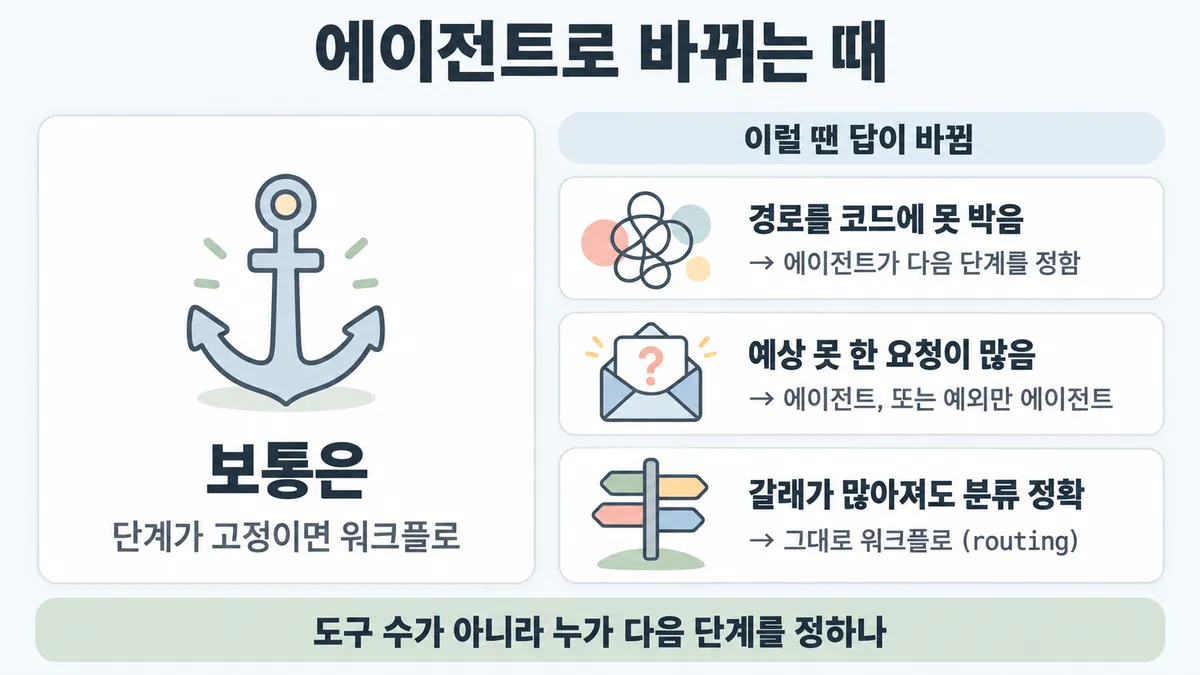
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
1. 단계는 고정인데 갈래가 폭발
- 조건 : 문의 종류가 처음 5가지에서 70가지 넘게 늘었다. 종류마다 필요한 조회·처리 순서가 다르다.
- 판단 : 종류를 정확히 나눌 수 있으면 여전히 워크플로다(routing · 라우팅). 종류를 미리 셀 수 없고 순서를 코드에 박아 둘 수 없게 되면, 공식 조건("can't hardcode a fixed path")이 성립한다. 그러면 에이전트 쪽이다.
- 등급 : 업계 일반 (경계선 숫자는 공식에 없다 · 조건 문장은 확인)
- 근거 : building-effective-agents
2. 비용이 제약이면
- 조건 : 하루 1,200건이다. 채팅형 한 번 처리에 평균 3천 토큰이 든다.
- 계산 : 채팅형은 1,200 × 3천 = 360만 토큰/일이다. 에이전트(채팅 대비 약 4배)는 약 1,440만 토큰/일이다. 늘어난 1,080만 토큰만큼 완료율·품질이 올라야 쓸 만하다.
- 전제 : 4배는 Anthropic 내부 데이터의 "typically" 값이다. 워크플로는 호출 수만큼 늘지만, 여기서는 채팅형과 같다고 둔다. 가격은 뺀다.
- 등급 : 계산
- 근거 : multi-agent-research-system · building-effective-agents
3. 에이전트 조건은 맞지만 믿을 근거가 없음
- 조건 : 원인 조사처럼 단계가 열린 일이다. 그런데 도구에 환불·계정 변경 같은 되돌리기 어려운 동작이 있다.
- 판단 : "에이전트를 쓴다" 는 답은 그대로다. 그 위에 체크포인트(사람 확인)·멈춤 조건·샌드박스가 붙는다. 권한 줄이기는 ■ 최소 권한 에서 다룬다.
- 근거 : building-effective-agents
4. 워크플로가 더 정확하다는데 새 요청엔 약함
- 조건 : 워크플로가 평소 완료율은 높다. 그런데 개발 때 상상 못 한 요청이 자주 들어온다.
- 판단 : 워크플로는 정해진 입력 밖을 못 받는다. 에이전트는 예상 못 한 상황을 다룬다. 새 요청 비중이 크면 에이전트 쪽이다. 하이브리드(평소 경로는 워크플로, 못 받는 것만 에이전트로)도 된다.
- 등급 : (각 성질) · 업계 일반 (하이브리드)
- 근거 : Skilljar 287794 · building-effective-agents
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "도구를 여러 개 부르니 환불도 에이전트로" | 도구가 곧 에이전트라는 인상이 있다 | 단계가 고정이면 워크플로다. 가르는 것은 다음 단계를 누가 정하나다 | building-effective-agents | |
| "고정 스키마 대량 변환에 에이전트" | 대량·자동이라 자율이 맞아 보인다 | 단계가 미리 그려진다. 그래서 워크플로다 | building-effective-agents | |
| "강한 모델이니 자율 에이전트가 기본 업그레이드" | 모델이 좋아졌으니 맡겨도 될 것 같다 | 복잡도는 결과가 나아질 때만 더한다 | building-effective-agents | |
| "orchestrator-workers 는 모델이 나누니 에이전트" | 하위작업을 LLM 이 정한다 | 공식 분류는 워크플로 패턴이다 | building-effective-agents | |
| "에이전트는 프레임워크부터 깐다" | 규모 있어 보인다 | LLM API 직접부터 시작한다. 추상화가 디버깅을 가린다 | building-effective-agents | |
| "에이전트면 끝날 때까지 알아서 돌게 둔다" | 자율이니까 그래 보인다 | 멈춤 조건(최대 반복 수)과 체크포인트를 둔다 | building-effective-agents | |
| "워크플로가 항상 더 싸고 빠르다" | 단계가 적어 보인다 | 워크플로도 호출 수만큼 지연·비용이 든다. 공식은 '예측 가능·일관성' 을 이점으로 든다 | 업계 일반 | building-effective-agents |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 1.3 공식 시험 가이드 v1.0
- building-effective-agents
- Skilljar API 287794
- 287796
- 287803
상태
- 모든 줄을 공식 문서에서 확인
미해결
- building-effective-agents 는 2024-12 글이다. 머리에 "도구 환경이 많이 바뀜, 현행은 Managed Agents 글 참고" 주석이 있다. 정의·판단 문장은 가이드 목표 1.3 과 맞는다. 하지만 현행 글(anthropic.com/engineering/managed-agents)은 받지 않았다.
- 목록 1.3① 의 "새 증거가 다음 결정으로 되돌아올 때만 에이전트" 는 그 문장 그대로는 원문에 없다. 가장 가까운 공식 문장은 매 걸음 환경에서 ground truth 로 진척을 판단한다는 것이다. 카드에는 원문 쪽만 적는다.
- 워크플로 호출량·지연 비교 숫자는 공식에 없다(뒤집히는 때 2 전제).