◆ 코드 vs LLM vs hybrid
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 1.1 업무 문제를 Claude 해법으로 · D1 설계 17%Translate business problems into Claude-based AI solutions
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 1.1① 이 일, LLM 이 꼭 있어야 하나? — 코드 / LLM / 둘을 섞기(하이브리드) 중 어디에 맡기나
- 6.1① "완벽한 계약 검토기를 만들어 달라" — 아키텍트의 첫 행동은? — 해법(모델·프롬프트·에이전트)보다 디스커버리 먼저
한눈에
ELI5
계산기와 친구에게 일을 나눠 맡기는 거예요.
- 덧셈은 계산기가 늘 똑같이, 틀리지 않게 해요.
- "이 편지 화난 거야?" 는 계산기가 못 하고 친구가 알아들어요.
- 둘이 섞인 일은 친구가 읽고, 숫자는 계산기에 넘겨요.
- 계산기로 되는 일에 친구를 부르면 가끔 답이 달라져요.
개념 설명
원리
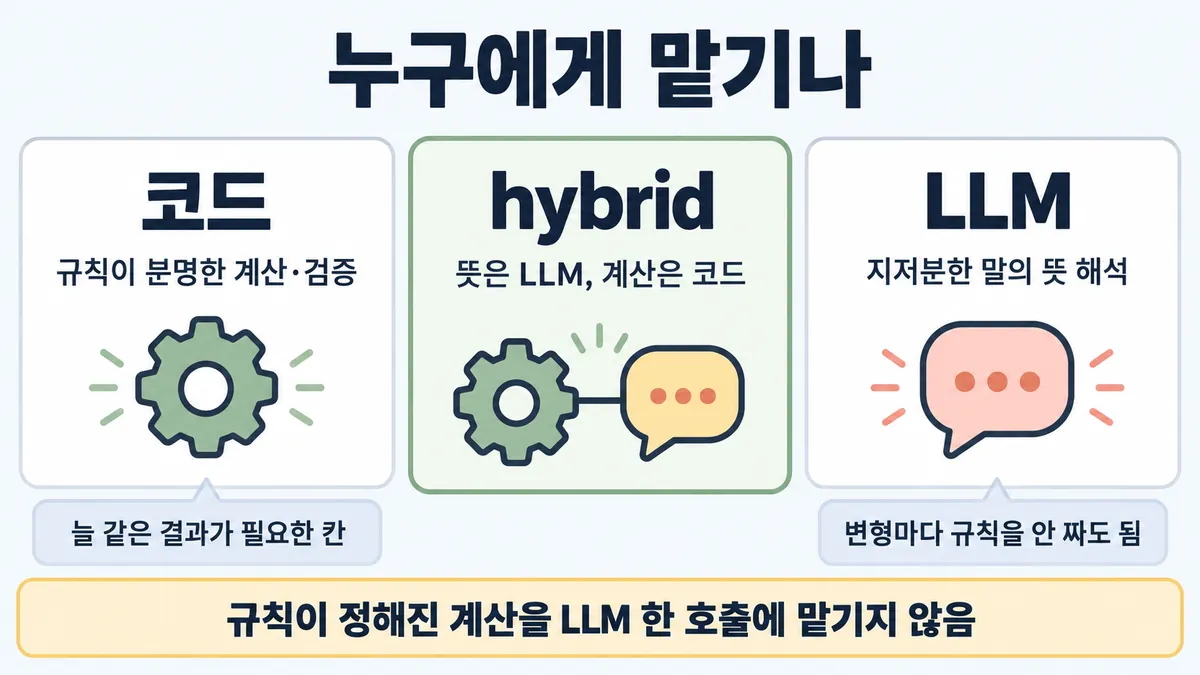
코드가 맡는 일
- 규칙이 분명한 계산, 검증, 정해진 순서는 코드가 맡는다. 코드는 같은 입력이면 늘 같은 결과를 낸다. 공식 문서는 이 성질을 deterministic(결정론적)이라고 부른다.
- 공식 근거는 두 곳이다. Agent Skills 모범 사례는 "결정론적 작업에는 스크립트를 쓰라"고 적는다. 미리 써 둔 스크립트가 모델이 즉석에서 만든 코드보다 믿을 만하다는 뜻이다. programmatic tool calling 글은 "반복·조건·변환·오류 처리를 LLM 추론(reasoning) 속이 아니라 코드에 드러나게 쓰라"고 적는다.
- LLM 은 같은 입력에도 답이 달라질 수 있다. 환불 금액은 틀리면 안 되고 규칙이 분명한 값이다. 이런 값을 LLM 이 만들면, 맞을 때도 왜 맞았는지 보장하지 못한다.
LLM 이 맡는 일
- 사람 말의 뜻을 읽는 일은 LLM 이 맡는다. 이 일을 규칙으로 하려면 말의 변형마다 규칙을 짜야 한다. 공식 고객지원 글은 이 점을 Claude 를 고를 이유로 든다.
- 공식 고객지원 글이 드는 신호는 다섯이다.
- 비슷한 문의가 대량으로 반복된다.
- 여러 자료를 빨리 합쳐야 한다.
- 24시간 응대해야 한다.
- 성수기에 문의가 급증한다.
- 말투가 일관돼야 한다.
hybrid
- 뜻은 LLM 이 읽는다. 계산과 동작은 코드가 한다. building-effective-agents 의 고객지원 예시도 "환불·티켓 갱신 같은 동작은 코드로(programmatically) 처리한다"고 적는다.
- LLM 이 뽑은 값을 코드에 넘길 때는 스키마로 받는다. 자세한 규칙은 ■ input → processing → output → feedback loop · 규칙 ③ 에 있다.
복잡도 사다리
- 가장 단순한 해법부터 시작한다. 에이전트를 아예 안 만드는 것도 답이다.
- 대부분의 일은 검색(retrieval)과 예시를 붙인 LLM 호출 하나로 충분하다. 부족하면 워크플로로 늘린다. 그래도 부족하면 에이전트로 늘린다(1.3 본편).
- 복잡도는 결과가 나아진 것이 보일 때만 늘린다.
핵심 질문
- 이 칸의 답은 규칙이 분명한가, 아니면 뜻을 읽어야 나오는가?
- 이 칸이 틀리면 누가 책임지는가?
- 이 칸은 같은 입력에 같은 답이 필요한가?
규칙과 판단
갈림길
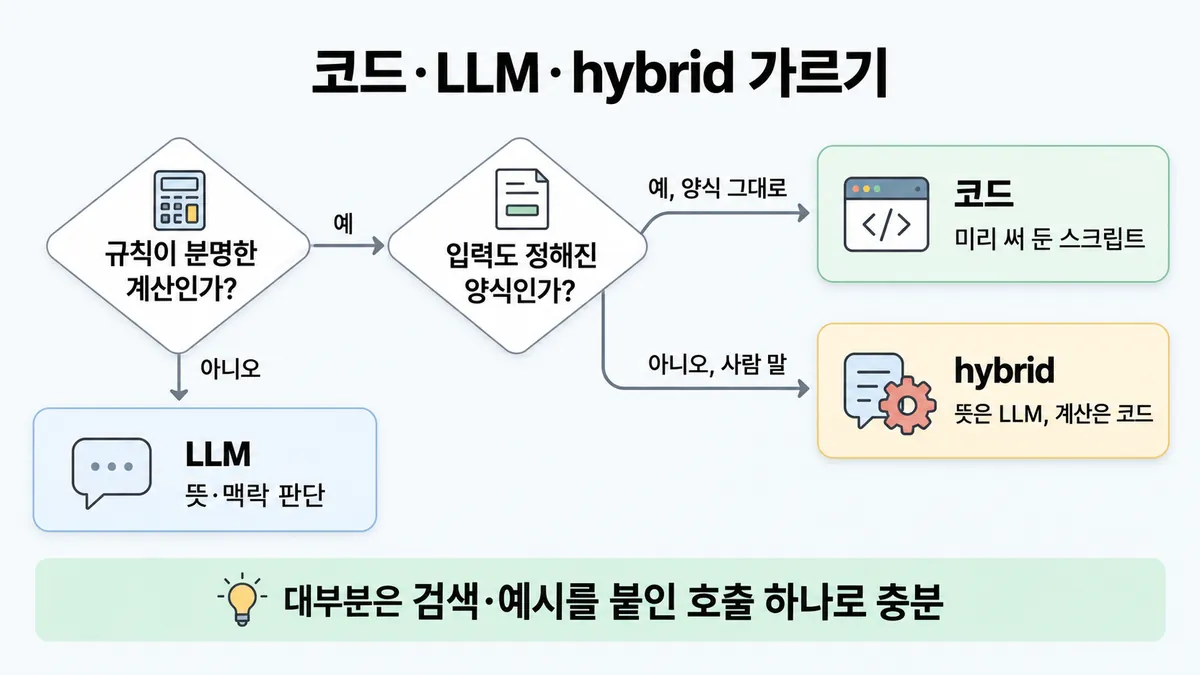
누구에게 맡기나 [1.1①]
코드
반복·조건·데이터 변환·오류 처리는 코드에 드러나게 쓴다. 미리 써 둔 코드는 LLM 이 즉석에서 만든 코드보다 믿을 만하다 (Skills 문맥의 공식 문장이다. 시스템 전체로 넓힌 것은 이 카드의 해석이다)
hybrid
LLM 이 뜻을 읽는다. 코드가 계산한다
LLM
말이 바뀔 때마다 규칙을 새로 짜지 않아도 된다
LLM 을 쓸 만한가 [1.1①]
LLM 을 쓸 만하다
성수기 급증과 일관된 말투도 같은 신호다
코드로 먼저 한다
LLM 을 붙여서 얻는 이득이 적다 업계 일반
얼마나 복잡하게 [1.1①] [1.3]
단일 호출
대부분의 일은 검색(retrieval)과 예시를 붙인 LLM 호출 하나로 충분하다
워크플로를 먼저, 그래도 부족하면 에이전트
자세한 것은 ■ 가장 작은 맞는 형태 에 있다 (1.3 본편)
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 고객 → Claude → 환불 계산 코드 → 고객이 받는 답
규칙 (환불 계산 코드) : 환불 = 단가 × 수량 − 반품 배송비 3,000원
질문 : 누가 금액을 계산해야 할까?
① hybrid ✓
- 시작 : 고객 — 말 : “지난달 산 셔츠 두 장 중 한 장 반품하면 얼마 돌려받아요?”
- 뜻 : 고객 → Claude : 사람 말에서 값을 뽑는다 — 쪽지 : { 상품: "셔츠", 단가: 29000, 반품: 1 }
- 계산 : Claude → 환불 계산 코드 : 규칙대로 계산한다 — 쪽지 : 29,000 × 1 / − 3,000 배송비 / = 26,000
- 답 : 환불 계산 코드 → 고객이 받는 답 — 말 : “26,000원 환불돼요.”
- 끝 : 뜻은 Claude 가 읽는다. 계산은 코드가 한다. 같은 질문에는 늘 26,000원이 나온다
② 계산까지 LLM ≠
- 시작 : 고객 — 말 : “지난달 산 셔츠 두 장 중 한 장 반품하면 얼마 돌려받아요?”
- 한 호출 : 고객 → Claude : 배송비 규칙을 안 보고 계산한다 — 쪽지 : "셔츠 한 장 29,000원이니 29,000원 돌려주면 되겠다"
- 건너뜀 : 환불 계산 코드
- 답 : Claude → 고객이 받는 답 : 규칙대로면 26,000원이다 — 말 : “29,000원 돌려드려요.”
- 끝 : 규칙이 분명한 계산을 LLM 에 맡겼다. 다음번에는 맞을 수도 있고 틀릴 수도 있다
반복
같은 질문 5번 보내 보기
- ① hybrid — 5번 모두 26,000 이다 ✓
- ② 계산까지 LLM — 5번 중 3번만 맞다 ≠
가정② 는 그림용 가정이다. LLM 이 반품 배송비 규칙을 가끔 빠뜨린다고 본다. 실제 측정값이 아니다
규칙 원문 갈림 기준 (갈림길로 그린 규칙)
갈림 기준
기준은 둘이다. 규칙이 분명한가? 입력이 사람 말인가?
- 규칙이 분명한 계산과 검증은 코드가 한다. 미리 써 둔 코드는 LLM 이 즉석에서 만든 코드보다 믿을 만하다 (Agent Skills 모범 사례. Skills 문맥의 문장이다)
- 반복·조건·데이터 변환·오류 처리는 코드에 드러나게 쓴다. LLM 추론(reasoning) 속에 숨기지 않는다 (programmatic tool calling 글)
- 사람 말의 뜻은 LLM 이 읽는다. 그러면 말의 변형마다 규칙을 짜지 않아도 된다
- 뜻 읽기와 계산이 한 일에 섞이면 hybrid 다. LLM 이 뜻을 읽고 코드가 계산한다. 환불·티켓 갱신 같은 동작도 코드(도구)가 한다
- LLM 은 같은 입력에도 답이 달라질 수 있다. 늘 같은 결과가 필요한 칸은 코드가 맡는다
- LLM 이 맞는 신호는 다섯이다
- 비슷한 문의가 대량으로 반복된다
- 여러 자료를 빨리 합쳐야 한다
- 24시간 응대해야 한다
- 성수기에 문의가 급증한다
- 말투가 일관돼야 한다
- 드물고 규칙이 분명한 일은 코드로 먼저 한다 업계 일반
- 분류(라우팅)는 정확하기만 하면 LLM 이 아니어도 된다. 전통 분류 모델과 알고리즘도 공식 선택지다
복잡도 : 가장 단순한 해법부터 시작한다. 필요할 때만 복잡도를 늘린다. 에이전트를 아예 안 만드는 것도 답이다
- 대부분의 일은 검색과 예시를 붙인 LLM 호출 하나로 충분하다. 부족할 때만 워크플로로 늘린다. 그래도 부족하면 에이전트로 늘린다 (1.3 본편)
- 프레임워크는 추상화로 프롬프트와 응답을 가린다. 그래서 디버깅이 어렵다. 먼저 API 를 직접 쓴다
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 등급 | 근거 |
|---|---|---|---|
| 규칙이 분명한 계산·검증이고 입력도 정해진 양식이다 | 코드가 한다 | (Skills 문맥) | agent-skills best-practices "Prefer scripts for deterministic operations" · "More reliable than generated code" |
| 반복·조건·데이터 변환이 섞인 오케스트레이션이다 | 코드에 드러나게 쓴다 | advanced-tool-use "Loops, conditionals, data transformations, and error handling are all explicit in code rather than implicit in Claude's reasoning." | |
| 사람 말의 뜻을 읽어야 하고 변형이 많다 | LLM 이 한다 | customer-support-chat "without … requiring extensive programming of permutations of user utterances" | |
| 뜻 읽기와 규칙 계산이 한 일에 섞여 있다 | hybrid 다. LLM 이 뜻을 읽고 코드가 계산과 동작을 한다 | building-effective-agents "Actions such as issuing refunds or updating tickets can be handled programmatically" | |
| 비슷한 문의가 대량으로 반복된다. 24시간 응대한다. 성수기에 급증한다 | LLM 을 쓸 만하다 | customer-support-chat | |
| 검색과 예시를 붙인 호출 하나로 된다 | 거기서 멈춘다 | building-effective-agents "optimizing single LLM calls with retrieval and in-context examples is usually enough" | |
| 분류(라우팅)를 규칙이나 전통 모델로 정확히 할 수 있다 | LLM 이 아니어도 된다 | building-effective-agents "either by an LLM or a more traditional classification model/algorithm" | |
| 프레임워크부터 깔려고 한다 | 먼저 API 를 직접 쓴다 | building-effective-agents |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 규칙이 분명한가 | 표나 식으로 적혀 있다 | 코드가 한다 | 판단 규칙 1 | |
| 규칙이 분명한가 | 사람마다 판단이 다르다 | LLM 이 한다 | 업계 일반 | — |
| 입력 모양 | 폼이나 코드값이다 | 코드가 한다 | 업계 일반 | — |
| 입력 모양 | 자유 문장이다(메일·채팅) | LLM 이 뜻을 읽고 코드가 처리한다 | 판단 규칙 3·4 | |
| 틀렸을 때 비용 | 돈이나 법적 값이다(환불액·세금) | 계산은 코드가 한다 | 업계 일반 (결정론 근거는 확인) | 판단 규칙 1 |
| 양 | 드물고 규칙이 분명한 일이다 | 코드로 먼저 한다 | 업계 일반 | — |
| 양 | 비슷한 문의가 대량으로 반복된다 | LLM 을 쓸 만하다 | 판단 규칙 5 | |
| 한 호출로 되나 | 된다 | 단일 호출로 멈춘다 | 판단 규칙 6 | |
| 한 호출로 되나 | 안 된다. 단계가 정해져 있다 / 단계를 미리 못 정한다 | 워크플로 / 에이전트 | building-effective-agents (1.3 본편) |
연습 문제
쇼핑몰 고객이 채팅으로 "지난달 산 셔츠 두 장 중 한 장 반품하면 얼마 돌려받아요?" 라고 묻는다사람 말. 환불액은 회사가 정해 둔 반품 규칙으로 계산한다규칙이 분명. Claude 에게 무엇을 맡길까?
시험 대비
함정
- "환불 금액 계산과 문의 뜻 분류를 한 번에 맡기자" 는 함정이다. 환불 금액 계산까지 LLM 한 호출에 맡기게 된다. 규칙이 분명한 일을 답이 달라질 수 있는 쪽에 맡긴 것이다. 계산은 코드가 한다
- "첫날부터 멀티에이전트 프레임워크를 깔자" 는 함정이다. 가장 단순한 해법부터 시작한다. 먼저 API 를 직접 쓴다. 자세한 것은 ◆ 단일 vs 멀티 에이전트 에 있다
- "AI 를 넣어야 발전한다" 는 함정이다. 사용자는 멋진 에이전트가 아니라 늘 되는 제품을 원한다 (Skilljar)
- 반대쪽 함정도 있다. "LLM 은 답이 달라질 수 있으니 사람 말도 키워드·정규식 규칙으로 처리하자" 는 함정이다. 말의 변형마다 규칙을 짜야 한다. 뜻은 LLM 이 읽는다
- "라우팅은 반드시 LLM 이 해야 한다" 는 함정이다. 정확하기만 하면 전통 분류 모델도 된다
신호
"we recommend finding the simplest solution possible, and only increasing complexity when needed. This might mean not building agentic systems at all."
"For many applications, however, optimizing single LLM calls with retrieval and in-context examples is usually enough."
"Prefer scripts for deterministic operations" (Agent Skills 모범 사례)
"Loops, conditionals, data transformations, and error handling are all explicit in code rather than implicit in Claude's reasoning."
"High volume of repetitive queries" · "Claude excels at handling a large number of similar questions efficiently, freeing up human agents for more complex issues."
"without generating canned responses or requiring extensive programming of permutations of user utterances"
"Users probably don't care that you've built a fancy agent - they want a product that works consistently." (Skilljar)
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
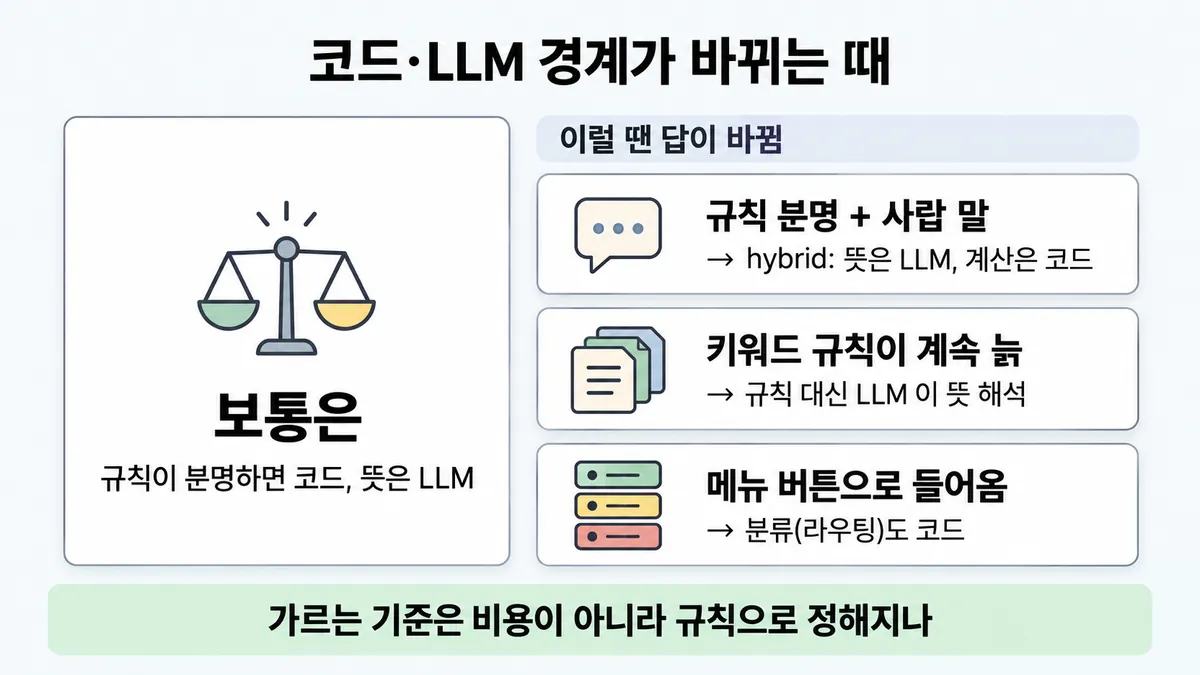
뒤집히는 때
1. 규칙이 분명한데 LLM 이 필요한 때
- 조건 : 환불 규정은 표로 정해져 있다. 그런데 고객은 "지난달 산 두 개 중 하나만 반품하면 얼마 돌려받아요?" 처럼 쓴다.
- 판단 : 규칙이 분명해도 코드만으로는 안 된다. 어느 주문인지, 몇 개인지, 무슨 사유인지 뜻을 읽어야 계산 입력이 생긴다. LLM 이 값을 스키마로 뽑는다. 코드가 계산한다. 이것이 hybrid 다.
- 등급 : (각 부품) · 조합은 업계 일반
- 근거 : customer-support-chat · structured-outputs · agent-skills best-practices
2. 키워드 규칙이 먼저 무너지는 때
- 조건 : 문의 유형 분류를 키워드 규칙 300개로 해 왔다. 새 상품이 나올 때마다 규칙이 늘고 오분류가 쌓인다.
- 판단 : 변형이 끝없는 입력은 규칙 유지비가 LLM 쪽 비용을 넘는다. 뜻 읽기는 LLM 에 맡긴다.
- 등급 : (공식 글이 "변형마다 프로그래밍하지 않아도 된다"를 Claude 를 고를 이유로 든다)
- 근거 : customer-support-chat
3. "LLM 은 비싸니까 코드" 가 이유가 안 되는 때
- 조건 : 문의 분류만 LLM 에 맡긴다. 월 9만 건이다. 건당 입력 600토큰(시스템 프롬프트 포함), 출력 30토큰이다. 모델은 Haiku 4.5 다.
- 계산 : Haiku 4.5 가격은 백만 토큰당 입력 $1, 출력 $5 다. 건당 비용 = 600 × $1/1M + 30 × $5/1M = $0.00075. 월 비용 = 9만 × $0.00075 = $67.5.
- 판단 : 분류 호출 비용은 작다. 코드냐 LLM 이냐는 비용으로 정하지 않는다. 규칙이 분명한가, 늘 같은 답이 필요한가로 정한다.
- 전제 : 캐싱을 안 한다. 재시도가 없다. 가격은 2026-09-28 조회값이다.
- 등급 : 계산
- 근거 : prompt-caching 표(Haiku 4.5 가격)
4. 분류도 LLM 이 아니어도 되는 때
- 조건 : 문의가 앱의 메뉴 버튼(배송 · 환불 · 계정)으로 들어온다.
- 판단 : 입력이 이미 코드값이다. 그러면 라우팅은 코드가 한다. 공식 글도 분류는 LLM 이든 전통 분류 모델·알고리즘이든 정확하면 된다고 적는다.
- 근거 : building-effective-agents
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "환불 금액 계산까지 LLM 한 호출에 맡긴다" | 호출 하나라 단순해 보인다 | 규칙이 분명한 값을 답이 달라질 수 있는 쪽에 맡긴다. 계산은 코드가 한다 | agent-skills best-practices · writing-tools-for-agents | |
| "첫날부터 멀티에이전트 프레임워크" | 규모 있어 보인다 | 가장 단순한 해법부터 시작한다. 먼저 API 를 직접 쓴다 | building-effective-agents | |
| "AI 를 넣어야 발전" | 새 도구가 곧 진보라는 습관 때문이다 | 에이전트를 아예 안 만드는 것도 답이다. 사용자는 늘 되는 제품을 원한다 | building-effective-agents · Skilljar 287794 | |
| "LLM 은 답이 달라질 수 있으니 사람 말도 키워드 규칙으로" (반대 함정) | 늘 같은 답이 안전해 보인다 | 말의 변형마다 규칙을 짜야 한다 | customer-support-chat | |
| "라우팅은 반드시 LLM" | LLM 시스템이라서 그렇게 느낀다 | 정확하면 전통 분류 모델도 공식 선택지다 | building-effective-agents | |
| "비용 줄이려 LLM 을 전부 규칙으로" | LLM 비용이 커 보인다 | 분류 같은 짧은 호출은 비용이 작다. 기준은 규칙이 분명한가와 늘 같은 답이 필요한가다 | 계산 | 뒤집히는 때 3 |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 1.1 공식 시험 가이드 v1.0
- building-effective-agents
- customer-support-chat
- agent-skills best-practices
- advanced-tool-use
- writing-tools-for-agents
- Skilljar API 287794
상태
- 업계 일반 1줄(드문 일은 코드로 먼저)
- '코드 먼저'의 공식 문장은 Skills 와 도구 호출 문맥의 것이다. 시스템 전체로 넓힌 것은 이 카드의 해석이다
미해결
- 목록 1.1① 은 "'LLM 대신 코드'라는 직접 문장을 공식 문서에서 못 찾았다"고 적었다. 이번에도 시스템 설계 차원의 직접 문장은 못 찾았다. 검색어는 "deterministic", "programmatic", "rather than an LLM" 이고, 범위는
raw/official-docs/en-*.md전체다. 가장 가까운 공식 문장은 두 곳에 있다. Skills 문맥(agent-skills best-practices)과 도구 오케스트레이션 문맥(advanced-tool-use)이다. 카드는 이 문장을 시스템 전체로 넓혀 쓴다. 이것은 해석이다. - "드물고 규칙이 분명한 일은 코드로 먼저 한다"는 공식 문장이 없다(업계 일반).
- building-effective-agents 는 2024-12 글이다. 머리에 "도구 환경이 많이 바뀌었다"는 주석이 있다. 단순함부터라는 원칙은 그대로다. 프레임워크 목록은 낡았을 수 있다.