■ max_tokens 와 긴 출력
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 4.5 토큰·지연·비용 최적화 · D4 평가 16%Optimize token usage, latency, and cost-performance trade-offs
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 4.5③ 긴 출력 요청이 SDK 에서 막힌다 / 답이 중간에 잘린다 — max_tokens 설정과 스트리밍·배치 전환
- 3.3① 상담원이 "답 초안이 늦게 뜬다"고 한다 — 모델부터 바꾸나? — 지연 lever 고르기 (스트리밍 · 캐싱 · 출력 길이 · effort · 모델 교체)
- 1.2② 앱은 다음 단계를 무엇으로 아나? — 처리 루프를 무엇으로 제어하나 (stop_reason)
한눈에
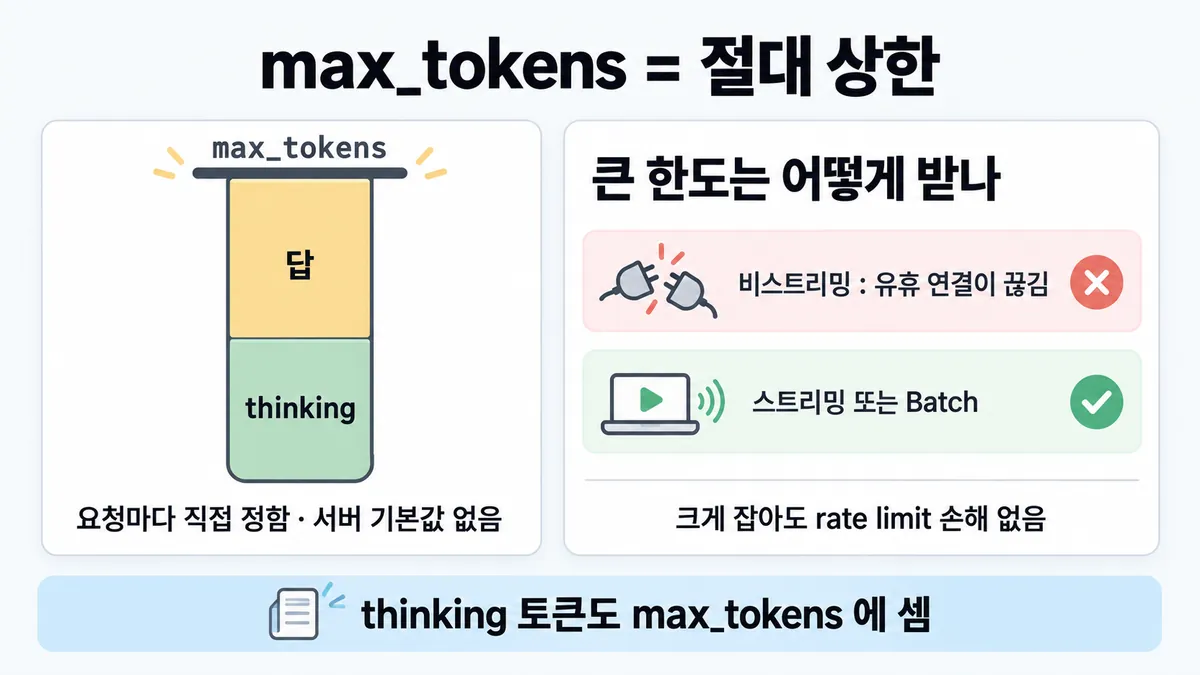
max_tokens 는 멈추기 전에 생성할 최대 토큰 수다(절대 상한). 모델은 그 전에 멈출 수 있다. 이 값은 요청마다 직접 정한다. API 레퍼런스에 optional 표시가 없다(= 필수). 서버 기본값도 없다
thinking(사고) 토큰도 여기에 센다. 그래서 한도는 thinking + 답 전체에 걸린다
크게 잡는 것 자체는 rate limit(속도 제한) 손해가 없다(OTPM 은 실제 생성 토큰만 센다). 문제는 긴 비스트리밍 요청의 연결 끊김이다. 그래서 스트리밍이나 Batch 를 쓴다
비유 로드밸런서 idle timeout 과 같다. 오래 걸리는 응답을 한 번에 받으려 하면 중간 장비가 조용히 끊는다. 그래서 청크로 흘려 받거나(스트리밍), 비동기 잡으로 맡기고 결과를 가지러 간다(Batch)
ELI5
편지지를 몇 장 줄지 정하는 거예요.
- 장수를 너무 적게 주면 편지가 중간에 끊겨요.
- 생각을 적는 메모도 같은 편지지를 써서, 메모가 길면 본문 쓸 자리가 없어요.
- 아주 긴 편지는 우체부가 문 앞에서 오래 못 기다려요. 조금씩 받거나, 나중에 찾으러 가야 해요.
- 이 쪽은 "언제 장수를 늘리고, 언제 받는 방법을 바꾸나"를 모아 둔 곳이에요.
개념 설명
원리
상한이지 목표가 아니다
max_tokens는 "여기까지만" 이라는 절대 상한이다. 모델은 할 말이 끝나면 먼저 멈춘다.- thinking(사고) 토큰과 답 텍스트가 한 예산을 같이 쓴다. thinking 이 길면 답이 못 나온다.
- 상한을 크게 잡는 것 자체는 rate limit(속도 제한)에 손해가 없다(OTPM 은 실제 생성 토큰만 센다).
긴 요청은 받는 방법이 문제다
- 오래 걸리는 비스트리밍 요청은 중간 네트워크가 유휴 연결로 보고 끊을 수 있다.
- 그래서 SDK 는 10분을 넘을 것 같은 비스트리밍 요청을 보내기 전에 막는다.
- 스트리밍은 연결을 계속 살려 둔다. Batch 는 연결을 끊고 나중에 결과를 가지러 간다.
잘림은 오류가 아니다
- 한도에 닿으면 HTTP 200 과
stop_reason: "max_tokens"가 온다. 앱이 이 값을 봐야 잘린 것을 알 수 있다. - 처리 방법은 셋이다.
- 한도를 올린다
- 이어서 생성한다
- 불완전하다는 안내를 붙인다
- 구조화 출력은 잘리면 스키마가 깨질 수 있다.
핵심 질문 두 개
- 이 요청의 전체 출력(thinking + 답)이 한도 안에 들어가나?
- 다 만드는 데 오래 걸리면, 연결을 살려 둘 건가(스트리밍)? 나중에 가지러 갈 건가(Batch)?
규칙과 판단
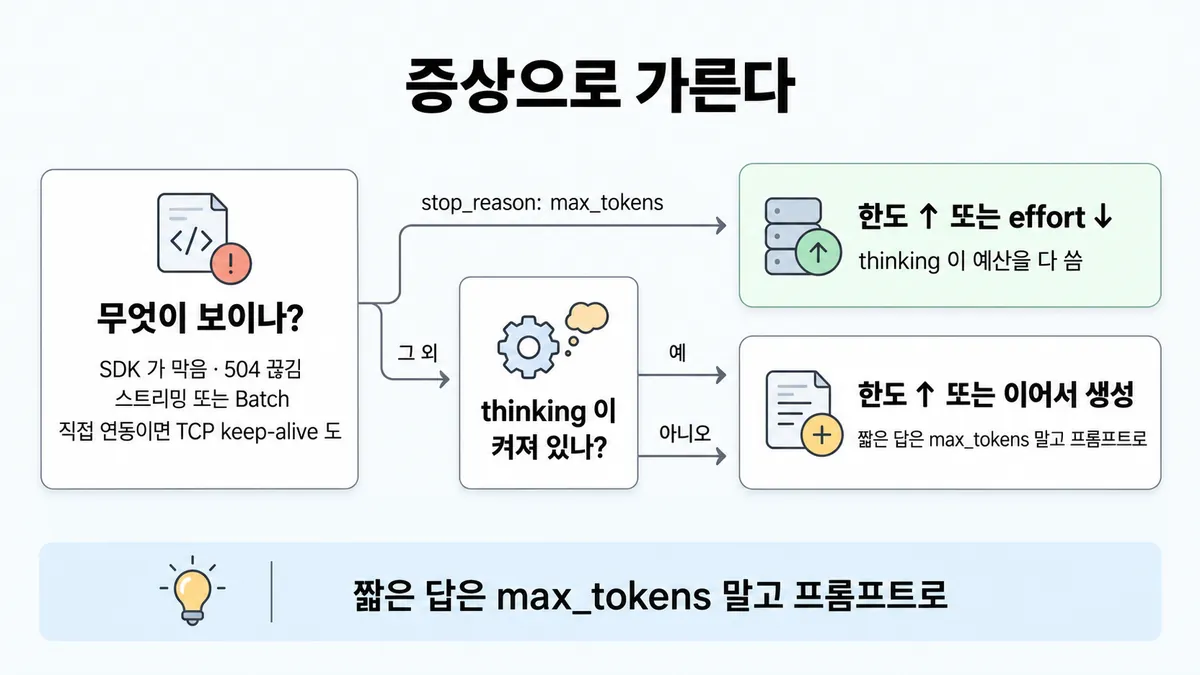
갈림길
②③ 증상으로 [4.5③]
스트리밍 또는 Batch
SDK 는 비스트리밍 요청이 10분 타임아웃을 넘을 것으로 예상되면 막는다. 이벤트 처리가 필요 없으면 .stream() + .get_final_message() 로 완전한 Message 를 받는다
스트리밍 · Batch · keep-alive
일부 네트워크는 유휴 연결을 끊는다. Batch 는 결과를 폴링하므로 끊기지 않는 연결이 필요 없다
stop_reason: "max_tokens"
한도를 올리거나 effort 를 낮춘다
thinking 토큰도 max_tokens 에 센다. 그래서 긴 thinking 이 답 전에 예산을 다 쓴다
한도를 올리거나 이어서 생성한다
잘린 답에는 불완전하다는 안내를 붙인다. 구조화 출력이면 스키마가 안 맞을 수 있다. 그때는 더 높은 max_tokens 로 재시도한다
④⑤ 얼마로 잡나 [4.5③] [2.1②]
크게 잡는다 · Opus 5·4.8·4.7 은 64k 에서 시작한다
높은 effort 에서는 크게 잡는다(thinking + 답 전체의 엄격한 한도다). Opus 5·4.8·4.7 을 xhigh·max 로 돌리면 64k 에서 시작해 조정한다. 이 값은 권장 출발점이지 기본값이 아니다
context window 끝까지 둔다
model_context_window_exceeded 로 멈추게 둔다
Batch 300k 베타를 쓴다
output-300k-2026-03-24 베타를 쓴다. 한 건이 1시간 넘게 걸릴 수 있다. 자세한 것은 ◆ Batch API vs 동기 호출 에 있다
프롬프트로 짧게 요청한다
max_tokens 는 상한이라 넘으면 자를 뿐이다. 길이는 "짧게 답해" 로 요청한다. thinking 토큰도 max_tokens 에 센다. 자세한 것은 ■ 지연 줄이기 lever 에 있다
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 앱 (SDK) → 네트워크 → 모델
규칙 (모델) : thinking 토큰도 max_tokens 에 센다
질문 : 긴 답은 어떻게 받아야 끊기지 않을까?
① 큰 한도 + 비스트리밍 ≠
- 시작 : 앱 (SDK) — 쪽지 : "문의 3개월 치로 / 긴 보고서 써 줘"
- 요청 : 앱 (SDK) → 네트워크 : 큰 한도를 비스트리밍으로 보낸다 — 쪽지 : max_tokens : 100000 / 스트리밍 : 안 씀
- 끊김 : 네트워크 : 유휴 연결을 끊는다 — 쪽지 : 오래 조용한 연결 / → 응답 없이 끊김
- 끝 : 그래서 SDK 는 비스트리밍 요청이 10분 타임아웃을 넘을 것으로 예상되면 막는다. 스트리밍이나 Batch 를 쓴다
② 스트리밍으로 받기 ✓
- 시작 : 앱 (SDK) — 쪽지 : "문의 3개월 치로 / 긴 보고서 써 줘"
- 요청 : 앱 (SDK) → 네트워크 :
.stream()으로 연결을 유지한다 — 쪽지 :.stream(…)/ max_tokens : 100000 - 전달 : 네트워크 → 모델 : 스트리밍으로 주고받는다 — 쪽지 : 이벤트가 계속 흐름 / 연결이 조용하지 않음
- 응답 : 모델 → 앱 (SDK) : 이벤트를 모아 완전한
Message로 받는다 — 쪽지 :.get_final_message()/ → 완전한Message - 끝 : 이벤트 처리가 필요 없어도 SDK 가 스트림을 모아 완전한
Message로 준다
③ thinking 이 한도를 다 쓴다 ≠
- 시작 : 앱 (SDK) — 쪽지 : 문의 : "셔츠 교환 되나요?" / → 라벨 하나로 분류
- 요청 : 앱 (SDK) → 모델 : 한도는 작고 thinking 은 켜져 있다 — 쪽지 : max_tokens : 300 / thinking : 켜짐
- thinking : 모델 : thinking 토큰도 한도에 센다 — 쪽지 : thinking 이 300 토큰을 / 다 씀 / 라벨 쓸 자리 없음
- 응답 : 모델 → 앱 (SDK) : 텍스트가 잘리거나 없다 — 쪽지 : stop_reason : / "max_tokens" / text : (없음)
- 끝 : 한도를 올리거나 effort 를 낮춘다
나머지 규칙
-
정의 : 멈추기 전에 생성할 최대 토큰 수다. 모델은 그 전에 멈출 수 있다 [4.5③]
- 모델마다 최댓값이 다르다. Opus 5.5·Fable 5.1·Opus 5·Sonnet 5 는 128k 다(2026-09-28 조회). Opus 5.5·Fable 5.1 은 시험 뒤에 나왔다
- API 레퍼런스에 optional 표시가 없다(= 필수). 서버 기본값도 없다
0으로 두면 응답 없이 캐시만 워밍한다
-
답을 짧게 하려면 :
max_tokens는 상한이라 넘으면 자를 뿐이다. 길이는 "짧게 답해" 로 요청한다. effort 는 thinking 양이지 답 길이가 아니다 (■ 지연 줄이기 lever)
규칙 원문 ②③④⑤ (갈림길로 그린 규칙)
-
긴 요청 : 큰
max_tokens를 스트리밍이나 Batch 없이 쓰지 않는다 [4.5③]- 일부 네트워크는 유휴 연결을 끊는다. 그러면 응답 없이 실패하거나 타임아웃이 난다. Batch 는 결과를 폴링하므로 끊기지 않는 연결이 필요 없다
- SDK 는 비스트리밍 요청이 10분 타임아웃을 넘을 것으로 예상되면 막는다. SDK 는 TCP keep-alive 도 설정한다
- 이벤트를 하나씩 처리할 필요가 없으면 SDK 가 스트림을 대신 모아 준다. 결과는 비스트리밍과 같은 완전한
Message다(.get_final_message()·.finalMessage()) - 504
timeout_error가 나면 긴 요청은 스트리밍으로 보낸다. 직접 연동이면 TCP keep-alive 를 쓴다
-
잘림 :
stop_reason: "max_tokens"가 오면 한도를 올리거나 이어서 생성한다. 잘린 답에는 불완전하다는 안내를 붙인다 (처리 전체 = ■ stop_reason 으로 분기) [4.5③]- thinking 토큰도
max_tokens에 센다. 그래서 긴 thinking 이 답 전에 예산을 다 써서 텍스트가 잘리거나 없다. 그때는 한도를 올리거나 effort 를 낮춘다 - 구조화 출력이 잘리면 스키마가 안 맞을 수 있다. 그때는 더 높은
max_tokens로 재시도한다
- thinking 토큰도
-
얼마로 : 높은 effort 에서는 크게 잡는다(thinking + 답 전체의 엄격한 한도다). Opus 5·4.8·4.7 을 xhigh·max 로 돌리면 64k 에서 시작해 조정한다. 이 값은 권장 출발점이지 기본값이 아니다 [4.5③] [2.1②]
- 크게 잡아도 rate limit 손해가 없다. OTPM 은 실제 생성 토큰만 센다.
max_tokens는 계산에 안 들어간다 (■ rate limit) - 입력 크기를 몰라도 한도를 최대로 둔다. 그리고
model_context_window_exceeded로 멈추게 둔다
- 크게 잡아도 rate limit 손해가 없다. OTPM 은 실제 생성 토큰만 센다.
-
표준 상한 128k 를 넘는 한 턴 : Batch 에서
output-300k-2026-03-24베타를 쓰면 300k 까지 된다(Opus 5.5·5·4.8·4.7·4.6, Sonnet 5·4.6). 한 건이 1시간 넘게 걸릴 수 있다. 그래서 24시간 창 안에서 계획한다. 자세한 것은 ◆ Batch API vs 동기 호출 에 있다max_tokens: 0(캐시 워밍)은 배치 안에서 안 된다
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
큰 max_ 요청이다 | 스트리밍이나 Batch 로 보낸다 | errors "Avoid setting a large max_ value without using the streaming Messages API or Message Batches API" |
| 비스트리밍이 10분을 넘을 것으로 예상된다 | SDK 가 막는다. 스트리밍으로 보낸다 | errors · streaming(큰 max_ 면 SDK 가 스트리밍을 요구한다) |
| 이벤트를 하나씩 처리할 필요가 없다 | .stream() 으로 보내고 최종 메시지를 받는다 | streaming · errors |
504 timeout_ 가 난다 | 긴 요청은 스트리밍으로 보낸다 | errors |
| 연결이 불안한 네트워크이고 결과를 나중에 받아도 된다 | Batch 로 보내고 폴링한다 | errors |
stop_ 가 온다 | 한도를 올리거나 이어서 생성한다. 불완전하다는 안내를 붙인다 | handling-stop-reasons |
thinking 이 켜졌고 max_ 로 멈췄다. 텍스트가 잘리거나 없다 | 한도를 올리거나 effort 를 낮춘다 | thinking-troubleshooting "thinking tokens count toward max_" |
| 구조화 출력이 잘렸다 | 더 높은 max_ 로 재시도한다 | structured-outputs |
| Opus 5·4.8·4.7 을 xhigh·max 로 돌린다 | 64k 에서 시작해 조정한다 | effort "Starting at 64k tokens and tuning from there is a reasonable default." |
| 높은 effort 다(Fable 5.1 · Opus 5.5) | 크게 잡는다. thinking + 답 전체에 걸리는 엄격한 한도다 | effort |
| 입력 크기를 모르고 최대로 받고 싶다 | 창 끝까지 두고 model_ 로 멈추게 한다 | handling-stop-reasons |
| 한 턴에 128k 넘게 필요하다 | Batch 와 output- 베타를 쓴다 | batch-processing |
| 한도를 크게 잡으면 rate limit 이 걱정된다 | 손해가 없다 | rate-limits |
상황 변수
| 변수 | 값 | 답 쪽 | 근거 |
|---|---|---|---|
| 호출 방식 | 비스트리밍이고 생성이 길다 | SDK 가 막는다. 스트리밍으로 보낸다 | 판단 규칙 2 |
| 호출 방식 | Batch 다 | 연결 끊김 걱정이 없다. 결과를 폴링한다. 완료 시각 약속은 없다 | errors · ◆ Batch API vs 동기 호출 |
| thinking | 켜져 있다(Sonnet 5 는 기본으로 adaptive thinking 이 켜져 있다. Opus 5.5 는 끌 수 없다) | 한도를 thinking 분량까지 크게 잡는다 | 릴리스 노트 · effort |
| effort | xhigh·max 다 | 64k 에서 시작한다(Opus 5·4.8·4.7) | 판단 규칙 9 |
| 출력 길이 | 128k 를 넘는다 | Batch 300k 베타를 쓰거나 이어서 생성한다 | 판단 규칙 12 · handling-stop-reasons |
| 사람이 기다리나 | 예 | Batch 는 빠진다. 스트리밍으로 보낸다 | ◆ Batch API vs 동기 호출 |
| 출력 형식 | JSON 스키마다 | 잘리면 스키마가 깨진다. 재시도한다 | 판단 규칙 8 |
| 답 길이를 줄이고 싶나 | 예 | 프롬프트로 "짧게" 를 요청한다. 한도는 넘치면 자르기만 한다 | reduce-latency · messages-create |
연습 문제
고객 문의 한 줄을 라벨 하나로 분류하는데 max_tokens 를 300 으로 두었다. 요청은 thinking 을 켠 채로thinking 켜짐 보낸다. 가끔 응답에 라벨이 없고 stop_reason: "max_tokens" 가 찍힌다잘림. 팀원은 모델이 라벨을 빠뜨리는 버그라며 모델을 바꾸자고 한다. 무엇을 고칠까?
시험 대비
함정
- "max_tokens 기본값은 비스트리밍 16,000 · 스트리밍 64,000 · 분류 256 이다" 는 함정이다. 서버 기본값은 없다. 요청마다 정한다. 64k 는 Opus xhigh·max 의 권장 출발점이다
- "16,000 을 넘으면 스트리밍으로 보낸다" 는 함정이다. SDK 기준은 토큰 수가 아니라 예상 시간 10분이다
- "타임아웃이 나면 타임아웃 값만 늘린다" 는 함정이다. 공식 처방은 스트리밍·Batch·keep-alive 다
- "max_tokens 를 크게 잡으면 OTPM 을 더 먹는다" 는 함정이다. OTPM 은 실제 생성 토큰만 센다. 손해가 없다
- effort 를 올렸더니 답이 잘렸다고 모델 탓을 하는 것은 함정이다. thinking 토큰도
max_tokens에 센다 - 잘린 JSON 을 파서에서 억지로 고치는 것은 함정이다.
stop_reason을 보고 더 높은max_tokens로 재시도한다 - "max_tokens 를 낮추면 답이 알아서 짧고 완결되게 나온다" 는 함정이다. 넘으면 잘릴 뿐이다. 짧게 하려면 프롬프트로 요청한다
신호
"The SDKs validate that your non-streaming Messages API requests are not expected to exceed a 10-minute timeout."
"Avoid setting a large max_tokens value without using the streaming Messages API or Message Batches API"
"This happens because thinking tokens count toward max_tokens, so a long thinking pass can consume the budget before the text response completes."
"Starting at 64k tokens and tuning from there is a reasonable default."
"The max_tokens parameter does not factor into OTPM rate limit calculations, so there is no rate limit downside to setting a higher max_tokens value."
"Note that our models may stop *before* reaching this maximum."
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
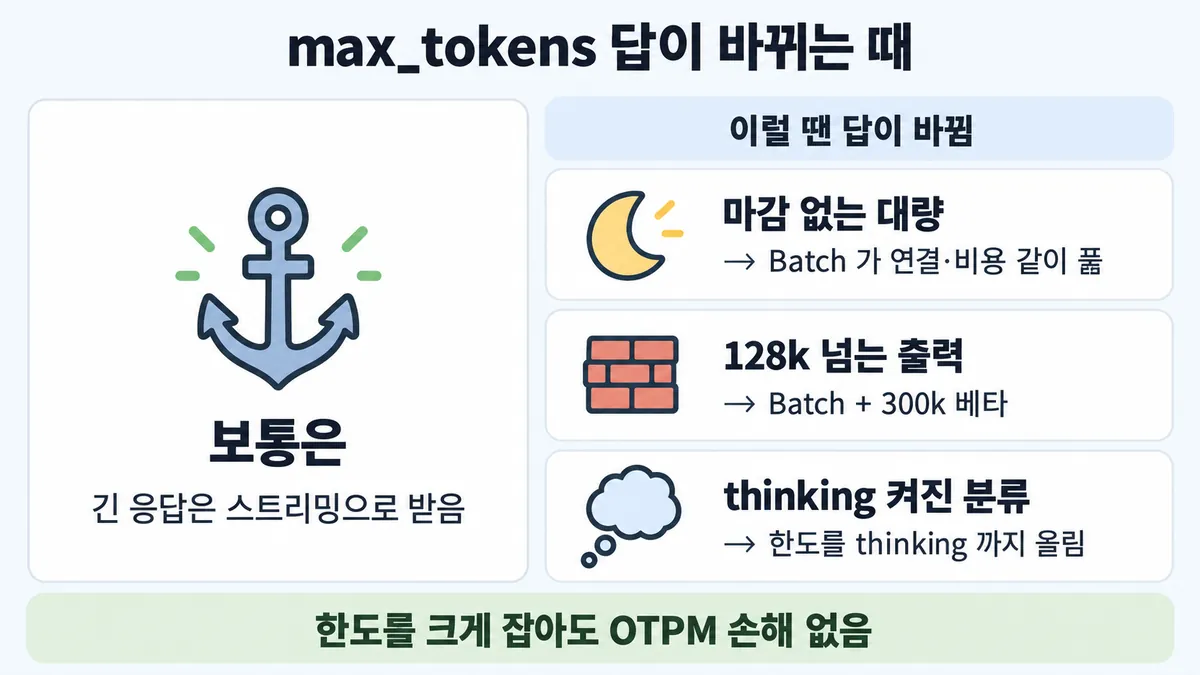
뒤집히는 때
1. "짧은 답이니 한도도 작게" 가 틀리는 때
- 조건 : 문의 한 줄을 라벨 하나로 분류한다. 라벨은 몇 토큰인데
max_tokens를 300 으로 두었다. 모델은 Sonnet 5 다(기본으로 adaptive thinking 이 켜져 있다). - 판단 : thinking 토큰도 300 안에서 센다. 그래서 thinking 이 길어지면 라벨이 나오기 전에
stop_reason: "max_tokens"가 온다. 처방은 한도를 thinking 분량까지 올리거나 effort 를 낮추는 것이다. - 비용 걱정 : 한도를 올려도 OTPM 손해는 없다(확인). 청구도 실제 생성 토큰 기준으로 본다. pricing 의 도구 사용 절에 "The number of output tokens generated" 문장이 있다(일반 요청도 같은 식으로 본다 = 추론).
- 등급 : (thinking 이 한도에 셈 · Sonnet 5 기본 thinking) · thinking 길이 숫자는 공식 값이 없다
- 근거 : thinking-troubleshooting · 릴리스 노트 · rate-limits · pricing
2. "한도가 크면 무조건 스트리밍" 이 아닌 때
- 조건 :
max_tokens가 크지만 사람이 기다리지 않는다. 일은 밤새 쌓아 둔 문서 3,000건의 긴 요약이다(건당 출력 약 9만 토큰). - 계산 : Sonnet 5 출력은 $10/MTok 이다. 동기(스트리밍)는 3,000 × 9만 × $10 = $2,700 이다. Batch 는 50% 라서 $1,350 이다. 입력은 양쪽이 같다고 보고 뺐다.
- 판단 : 연결 문제를 푸는 길은 스트리밍과 Batch 둘이다. 마감이 없고 대량이면 Batch 가 연결 문제와 비용을 같이 푼다. 사람이 기다리면 스트리밍을 쓴다.
- 전제 : 건당 출력 9만은 가정이다. 가격은 2026-09-28 조회값이다(Sonnet 5 배치 출력 $5, pricing 표).
- 등급 : 계산 (50%·연결 처방은 확인)
- 근거 : errors · pricing 표 · prompt-caching 표
3. 한도를 올려도 안 되는 때 — 128k 벽
- 조건 : 한 턴에 20만 토큰짜리 출력이 필요하다(대형 코드 생성).
- 판단 : 동기 요청의 표준 상한은 128k 다. 그래서 더 올릴 수 없다. 길은 두 개다.
- ① Batch 와
output-300k-2026-03-24베타를 쓴다. 한 건이 1시간 넘게 걸릴 수 있으므로 24시간 창 안에서 계획한다. - ② 동기로 받아야 하면 잘린 곳에서 이어서 생성한다.
- ① Batch 와
- 근거 : batch-processing · handling-stop-reasons
4. effort 를 올렸더니 오히려 잘리는 때
- 조건 : 품질을 올리려고 Opus 5 를
xhigh로 올렸다. 그런데max_tokens는 예전 값(예 8천) 그대로다. - 판단 : 높은 effort 는 thinking 과 도구 호출이 늘어 같은 한도 안에서 답 자리가 줄어든다. 그래서 64k 에서 시작해 조정한다. "effort 를 올리면 잘린다 = 모델 결함" 은 틀린 생각이다.
- 등급 : (64k 권장 · thinking 이 한도에 셈) · "thinking 이 늘어 답 자리가 준다" 는 두 확인 사실을 이은 추론이다
- 근거 : effort · thinking-troubleshooting
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 근거 |
|---|---|---|---|
| "max_tokens 기본값은 비스트리밍 16,000 · 스트리밍 64,000 · 분류 256" | 영상이 그렇게 가르쳤다 | 서버 기본값은 없다. 요청마다 정한다. 64k 는 Opus xhigh·max 의 권장 출발점이다 | messages-create(optional 표시 없음) · effort |
| "출력이 16,000 을 넘으면 스트리밍으로" | 숫자 기준이 외우기 쉽다 | SDK 기준은 예상 시간 10분이다 | errors |
| "타임아웃이 나면 클라이언트 타임아웃 값만 늘림" | 가장 손쉽다 | 중간 네트워크가 유휴 연결을 끊는다. 처방은 스트리밍·Batch·keep-alive 다 | errors |
| "max_tokens 를 크게 잡으면 OTPM 한도를 더 먹음" | 예약하는 값처럼 보인다 | 실제 생성 토큰만 센다 | rate-limits |
| "effort 를 올리자 답이 잘렸으니 모델 품질 문제다. 모델을 바꾼다" | 설정을 바꾼 직후의 증상이라 모델 탓 같다 | thinking 토큰도 max_ 에 센다. 한도를 올리거나 effort 를 낮춘다 | thinking-troubleshooting |
| "잘린 JSON 은 파서에서 닫는 괄호를 붙여 살림" | 재요청 비용이 아깝다 | 불완전해서 스키마가 안 맞을 수 있다. 더 높은 한도로 재시도한다 | structured-outputs |
| "max_tokens 를 낮추면 답이 짧고 완결되게 나옴" | 상한을 목표 길이로 착각한다 | 넘으면 자를 뿐이다. 짧게 하려면 프롬프트로 요청한다 | messages-create · reduce-latency |
| "긴 출력이니 상담원이 기다려도 Batch 로" | 50% 할인과 300k 상한이 끌린다 | 완료 시각 약속이 없다 | ◆ Batch API vs 동기 호출 |
"배치 안에서 max_ 으로 캐시 워밍" | 캐시 워밍 기능을 알고 있다 | 배치에서는 안 된다 | batch-processing · prompt-caching |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 4.5 공식 시험 가이드 v1.0
- messages-create
- errors
- streaming
- thinking-troubleshooting
- effort
- handling-stop-reasons
- structured-outputs
- rate-limits
- batch-processing
- prompt-caching
- reduce-latency
- 릴리스 노트
상태
- 필수 여부는 API 레퍼런스 표기(optional 없음)로 판단했다
미해결
- SDK 의 "10분 넘을 것으로 예상" 계산식은 받은 원문에 없다. 몇 토큰부터, 어떤 모델부터 막히는지 모른다(errors · streaming).
- "
max_tokens는 필수" 를 직접 말한 문장은 없다. API 레퍼런스에서 다른 인자에는optional이 붙고max_tokens에는 없다. 이 표기로 판단했다(messages-create, "required" 검색 0건). - Haiku 4.5 최대 출력 토큰은 받은 원문에 없다. 릴리스 노트에서 "max output tokens" 를 검색했다. 128k 로 나온 모델은 Opus 5.5·Fable 5.1·Opus 5·Sonnet 5·Fable 5·Opus 4.8 뿐이다.
- 목록 4.5③ 의 숫자(10분 · 64k)는 원문과 같았다. 목록의 "매력적인 오답" 숫자 16,000/64,000/256 은 원문에 근거가 없다(영상 교정 대상 그대로).