■ 변경마다 eval 다시
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 4.3 A/B 테스트와 반복 개선 · D4 평가 16%Conduct A/B testing and iterative improvements
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 4.3③ 프롬프트 한 줄·모델 버전을 바꿨다 — 무엇을 다시 돌리나? — 반복 개선 루프 (변경 = 시스템 변경, eval 통과 뒤 배포)
- 4.4① 문서 갱신 뒤 자신 있게 틀린다 — 모델·지연은 그대로 — 어느 계층부터 조사하나 (첫 질문 = 증상 직전에 무엇이 바뀌었나)
- 4.5② 보기마다 다른 최적화 — 이 시나리오의 레버는 무엇 하나? — 시나리오 단서 → 레버 하나 (캐싱 · 배치 · 라우팅/effort · 스트리밍)
한눈에
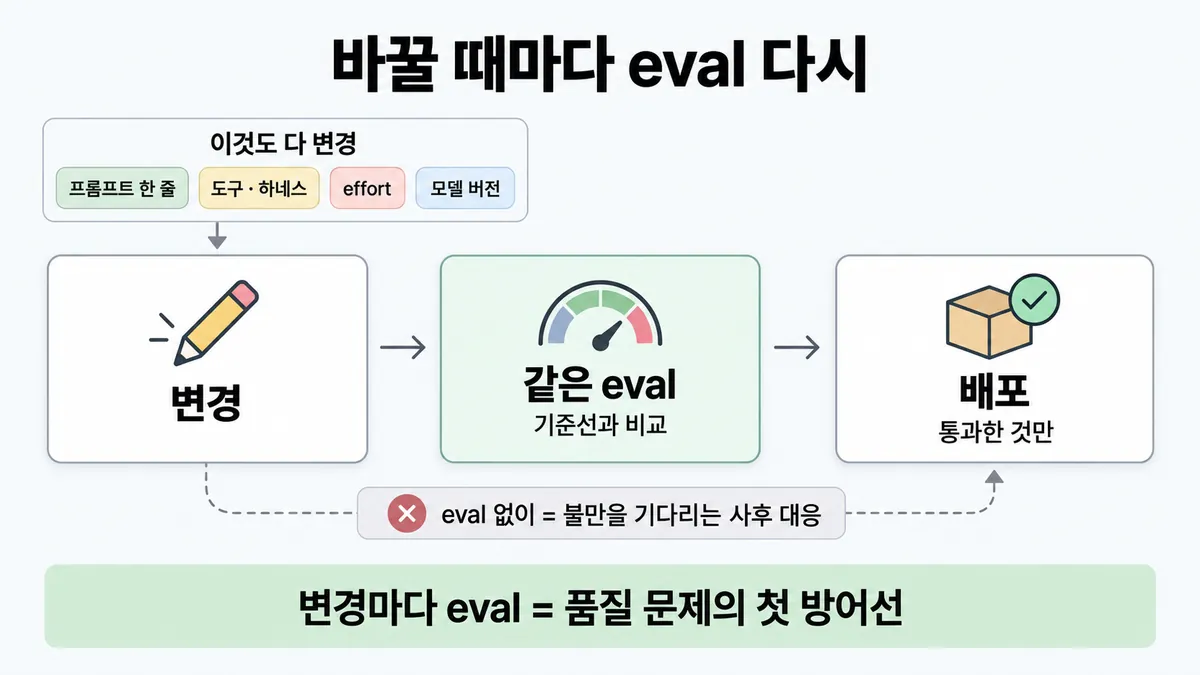
프롬프트 한 줄·도구·effort·모델 버전을 바꾸는 것도 시스템 변경이다. 바꿀 때마다 같은 eval 을 다시 돌려 기준선과 비교한다. 통과한 것만 배포한다. 이것이 품질 문제의 첫 방어선이다
eval 이 없으면 불만을 기다리는 사후 대응이 된다. 순서는 이렇다
- 불만을 기다린다
- 손으로 재현한다
- 고친다
- 다른 데가 안 깨졌길 바란다
비유 GitOps 와 같다. 설정 한 줄도 PR 을 열고 CI 테스트를 거친다. 통과해야 배포한다. 핫픽스라고 파이프라인을 건너뛰지 않는다
ELI5
빵집에서 반죽 비법을 조금 바꿀 때마다 시식단에게 다시 먹여 보는 거예요.
- 소금 한 꼬집만 바꿔도 맛이 달라질 수 있어요.
- 사장님 혼자 한 입 먹어 보고 "괜찮네" 하면 손님이 먼저 실망해요.
- 밀가루 회사를 바꾸면 맛뿐 아니라 빵 한 개 값도 다시 따져야 해요.
- 이 쪽은 "무엇을 바꾸면 무엇을 다시 재나"를 모아 둔 곳이에요.
개념 설명
원리
변경은 곧 시스템 변경이다
- 아래 어느 것을 바꿔도 에이전트 동작이 바뀐다.
- 프롬프트 한 줄
- 도구 정의
- 하네스
- effort
- 모델 버전
- 그래서 바꿀 때마다 같은 과제 세트(static bank of tasks)로 다시 돌려 기준선과 비교한다. 통과한 것만 배포한다. 이것이 품질 문제의 첫 방어선(CI/CD)이다.
- eval 이 없으면 사후 대응이 된다. 불만을 기다리고, 손으로 재현하고, 고치고, 다른 데가 안 깨졌길 바란다. 진짜 regression(회귀)과 잡음을 구분하지 못한다.
루프 (공식 흐름도 · Skilljar)
- 아래 순서로 돈다.
- 과제 세트를 만든다
- 첫 프롬프트를 쓴다
- 돌리고 채점한다
- 기준선 점수를 잡는다
- 프롬프트를 바꿔 같은 과제 세트로 다시 돌린다
- 점수로 비교해 제일 나은 버전을 쓴다
- 한 번이나 몇 번 해 보고 "됐다"고 하는 것은 흔한 함정이다. 실사용자는 예상 못 한 입력을 넣는다.
eval 먼저 (eval-driven development)
- 만들 기능의 eval 을 먼저 정의한다. 통과할 때까지 반복한다.
- 에이전트가 아직 못 하는 기능도 capability(능력) eval 로 먼저 만들어 둔다. 새 모델이 나오면 돌려서, 미리 만든 eval 중 어느 것이 통과하는지(어느 예상이 맞았는지) 바로 본다.
- eval 이 있는 팀은 새 모델을 며칠 만에 들인다. 없는 팀은 몇 주가 걸린다.
모델을 바꾸면 품질과 비용·지연(latency) 기준선을 다시 잰다
- eval 이 있으면 지연 · 토큰 사용량 · 과제당 비용 · 오류율 기준선이 덤으로 생긴다. 그래서 모델 교체 전후를 같은 과제로 비교한다.
- 비용이 달라지는 공식 이유는 셋이다.
- ① 새 토크나이저 : Claude 4.7 이후 모델은 같은 글의 토큰이 약 30% 더 나온다.
- ② 모델별 최소 캐시 길이 : 바꾼 모델에서 조용히 캐싱이 꺼질 수 있다.
- ③ 모델별 기본 effort·thinking(사고) 동작 : Opus 5.5 는 기본이
medium이고, thinking 을 끌 수 없다(시험 뒤 변경).
- 공식 업그레이드 절차는 이렇다.
- 내 사용 사례로 벤치마크한다(가장 중요하다)
- 실제 프롬프트와 데이터로 돌린다
- 정확성·품질·엣지 케이스를 비교한다
- 성능과 비용을 저울질한다
도구보다 과제
- Harbor · Braintrust · LangSmith · Langfuse · Arize 는 예시일 뿐이다. 프레임워크는 돌리는 과제만큼만 좋다. 그래서 빨리 하나 고르고 과제와 grader(채점기)에 힘을 쏟는다.
핵심 질문 두 개
- 이번에 바꾼 것이 무엇이고, 같은 과제로 전후를 비교했나?
- 품질만 봤나, 비용·지연 기준선도 다시 쟀나?
규칙과 판단
갈림길
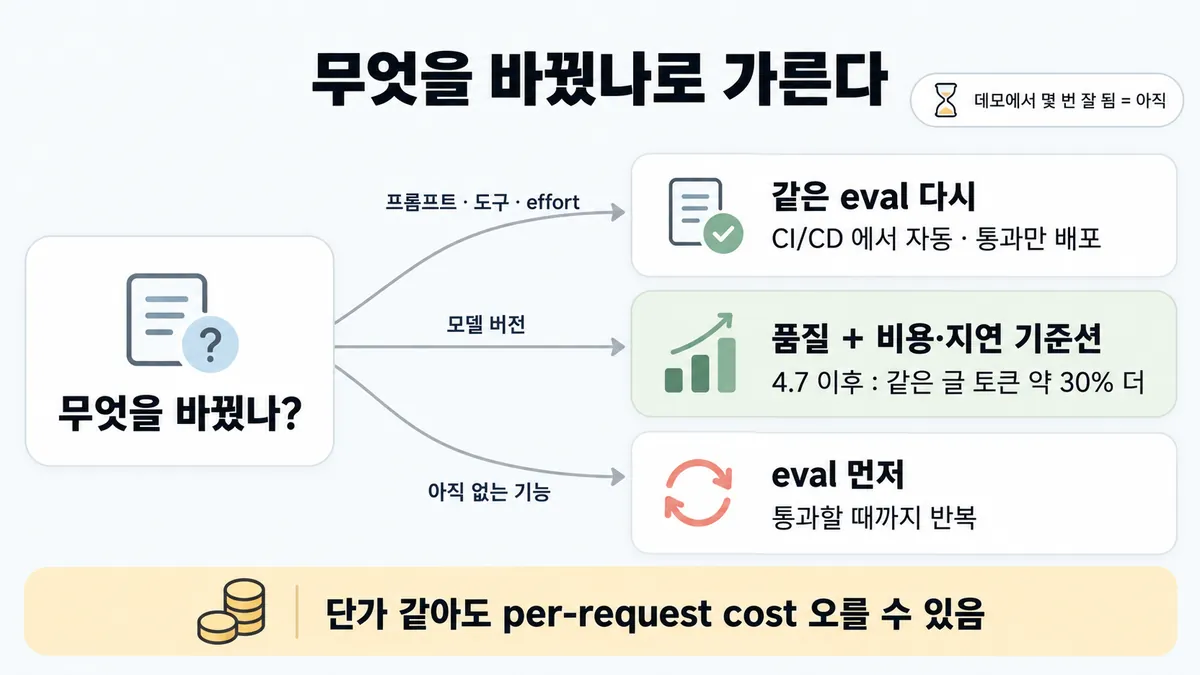
②④ 무엇을 다시 돌리나 [4.3③]
같은 eval 을 다시 돌린다
변경마다 자동 eval 을 CI/CD 에서 돌린다. 통과한 것만 배포한다
품질과 비용·지연 기준선을 다시 잰다
Opus 4.6 에서 4.7 로 가면 같은 글의 per-request cost(요청당 비용)가 약 30% 오른다. Sonnet 4.6 에서 Sonnet 5 로 가면 그래도 약 13% 싸다 계산. 이유는 새 토크나이저다. Claude 4.7 이후 모델은 같은 글의 토큰이 약 30% 더 나온다. 그래서 단가가 같아도 같은 글의 per-request cost 가 오를 수 있다
eval 먼저
만들 기능의 eval 을 먼저 만든다. 통과할 때까지 반복한다
①③⑤ 배포해도 되나 [4.3③]
아직이다
한 번이나 몇 번 해 보는 테스트는 흔한 함정이다. eval 파이프라인으로 점수를 낸다 (Skilljar)
배포한다
통과한 것만 배포한다. regression(회귀)도 같이 돌린다 (◆ capability eval vs regression eval)
도구보다 과제
도구는 돌리는 과제 수준을 못 넘는다. 과제와 grader(채점기)에 힘을 쏟는다
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 변경 → eval → 배포
규칙 (eval) : 같은 과제 세트로 다시 돌린다. 기준선과 비교한다
질문 : 이 변경, 바로 내보내도 될까?
① 통과한 것만 배포 ✓
- 시작 : 변경 — 쪽지 : PR #212 / 프롬프트 한 줄 추가 / "환불 전 주문번호 확인"
- 돌림 : 변경 → eval : 같은 과제 세트로 돌린다 — 쪽지 : 과제 40개 × 새 프롬프트
- 비교 : eval : 기준선과 비교한다 — 쪽지 : 점수 82% → 88% / 과제당 비용 그대로 / regression 없음
- 넘김 : eval → 배포 : 통과한 것만 배포한다 — 쪽지 : CI : passed / 배포 v1.13
- 끝 : 변경마다 돌리는 eval 이 품질 문제의 첫 방어선이다
② 데모만 보고 배포 ≠
- 시작 : 변경 — 쪽지 : 핫픽스 : 프롬프트 한 줄
- 건너뜀 : eval
- 넘김 : 변경 → 배포 : 몇 번 해 보고 됐다고 본다 — 쪽지 : "데모에서 3번 잘 됨" / → 바로 배포
- 나중 : 배포 : 불만이 와서야 알게 된다 — 말 : “교환 신청했는데 왜 환불됐죠?”
- 끝 : eval 없이 내보내면 불만을 기다리는 사후 대응이 된다
③ 모델 업그레이드 ✓
- 시작 : 변경 — 쪽지 : 모델 : Opus 4.6 → 4.7 / 단가 $5/$25 그대로
- 돌림 : 변경 → eval : 모델 버전도 변경이다 — 쪽지 : 같은 과제 40개 / 새 모델로
- 비교 : eval : 새 토크나이저 — 쪽지 : 입력 6,500 → 약 8,450 토큰 / per-request cost / 약 +30%
- 넘김 : eval → 배포 : 품질과 비용·지연 기준선을 잡는다 — 쪽지 : 새 기준선 : 품질 · 지연 / 토큰 · 과제당 비용
- 끝 : 단가가 같아도 같은 글의 토큰이 약 30% 늘어 per-request cost 가 오를 수 있다
규칙 원문 ①②③④⑤ (갈림길로 그린 규칙)
-
루프 : 아래 순서로 돈다 [4.3③]
- 과제 세트를 만든다
- 첫 프롬프트를 쓴다
- 돌리고 채점한다
- 기준선 점수를 잡는다
- 바꾸고 같은 과제 세트로 다시 돌린다
- 점수로 비교해 제일 나은 버전을 쓴다
한 번이나 몇 번 해 보는 테스트는 흔한 함정이다. eval 파이프라인으로 점수를 내고 그 점수로 고친다 (Skilljar)
-
무엇이 변경인가 : 에이전트 변경과 모델 업그레이드마다 자동 eval 을 CI/CD 에서 돌린다. 통과한 것만 배포한다. regression 도 같이 돌린다 (◆ capability eval vs regression eval) [4.3③]
변경에는 이런 것이 있다
- 프롬프트 한 줄
- 도구
- 하네스
- effort
- 모델 버전
effort 도 기본값에서 시작해 eval 결과를 보고 올리거나 내린다
-
eval 먼저 (eval-driven development) : 만들 기능의 eval 을 먼저 만들고, 통과할 때까지 반복한다. 에이전트가 아직 못 하는 기능도 capability(능력) eval 로 먼저 만든다. 새 모델이 나오면 돌려서, 미리 만든 eval 중 어느 것이 통과하는지(어느 예상이 맞았는지) 본다 [4.3③]
eval 이 있는 팀은 새 모델을 며칠 만에 들인다. 없는 팀은 몇 주를 테스트한다
-
모델 교체 : 모델을 바꾸면 품질과 비용·지연(latency) 기준선을 다시 잰다. eval 이 있으면 아래 기준선이 공짜로 생긴다 [4.3③] [4.5]
- 지연
- 토큰 사용량
- 과제당 비용
- 오류율
새 토크나이저 : Claude 4.7 이후 모델은 같은 글의 토큰이 약 30% 더 나온다(내용에 따라 다르다). Sonnet 4.6 이전은 옛 토크나이저다
바꿈 단가(입력/출력, 백만 토큰당) 같은 글의 per-request cost Opus 4.6 에서 4.7 로 $5/$25 에서 $5/$25 로 (같다) 같은 글이면 per-request cost 가 약 30% 오른다 계산 Sonnet 4.6 에서 Sonnet 5 로 $3/$15 에서 $2/$10 으로 입력 1.3 × $2 = $2.6 < $3 이다. 그래서 그래도 약 13% 싸다 계산 최소 캐시 길이는 모델마다 다르다(예 Sonnet 5 1,024 · Haiku 4.5 4,096). 그래서 바꾼 모델에서는 조용히 캐싱이 안 될 수 있다. 자세한 것은 ■ 프롬프트 캐싱 에 있다
이전 모델의 effort 설정을 그대로 가져오지 않는다. 자체 eval 에서 effort 스윕을 한다. Opus 5.5 는 기본 effort 가
medium이다(Opus 5 이전은high). thinking(사고)을 끌 수 없다 시험 뒤 변경 Opus 5.5 출시 2026-09-22업그레이드 판단 순서는 이렇다
- 내 사용 사례로 벤치마크한다(가장 중요하다)
- 실제 프롬프트와 데이터로 돌린다
- 정확성·품질·엣지 케이스를 비교한다
- 성능과 비용을 저울질한다
비용이 올랐을 때 원인을 좁히는 법은 ■ 비용 급증 추적 에 있다. 무엇이 바뀌었나부터 묻는 법은 ■ 변경부터 묻는 진단 에 있다
-
도구보다 과제 : 프레임워크(Harbor · Braintrust · LangSmith · Langfuse · Arize)는 돌리는 과제 수준을 못 넘는다. 그래서 빨리 하나 고르고 과제와 grader 에 힘을 쏟는다 [4.3③]
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 등급 | 근거 |
|---|---|---|---|
| 에이전트를 바꿨거나 모델을 업그레이드했다 | 자동 eval 을 CI/CD 에서 다시 돌린다. 통과한 것만 배포한다 | demystifying-evals "running on each agent change and model upgrade as the first line of defense" · "automatically test changes against hundreds of scenarios before shipping" | |
| 데모나 몇 번의 테스트로 "됐다"고 한다 | 아직이다. eval 파이프라인으로 점수를 낸다 | Skilljar 287731 "Test the prompt once and decide it's good enough. This carries a significant risk of breaking in production" | |
| 새 기능을 만든다 | eval 을 먼저 정의한다. 통과할 때까지 반복한다 | "build evals to define planned capabilities before agents can fulfill them, then iterate" | |
| 모델을 바꿨다 | 품질과 함께 지연·토큰·과제당 비용·오류율 기준선을 비교한다 | "latency, token usage, cost per task, and error rates can be tracked on a static bank of tasks" | |
| Claude 4.7 이후 모델로 바꿨다 | 같은 글의 토큰이 약 30% 더 나온다. 비용을 다시 계산한다 | pricing "This tokenizer produces approximately 30% more tokens for the same text." | |
| 모델을 바꾸니 캐시 적중이 0 이다 | 최소 캐시 길이부터 본다 (■ 프롬프트 캐싱) | prompt-caching | |
| 업그레이드할지 정한다 | 사용 사례 벤치마크, 실제 데이터, 비교, 성능·비용 저울질 순서로 간다 | choosing-a-model | |
| effort 를 정한다 | 기본값에서 시작해 eval 을 보고 조정한다. 이전 모델 설정을 그대로 가져오지 않는다 | 시험 뒤 변경(Opus 5.5) | choosing-a-model · effort |
| eval 도구를 고른다 | 빨리 하나 고르고 과제와 grader 에 힘을 쏟는다 |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 바꾼 것 | 프롬프트·도구·effort 다 | 같은 eval 을 다시 돌린다. 통과한 것만 배포한다 | 판단 규칙 1 | |
| 바꾼 것 | 모델 버전이다 | 품질과 비용·지연 기준선을 다시 잰다 | 판단 규칙 4 | |
| 토크나이저 | 옛것에서 새것으로 바뀐다 (Sonnet 4.6 이전에서 Claude 4.7 이후로) | 같은 글의 토큰이 약 30% 늘어난다 | pricing | |
| 단가 | 같다 (Opus 4.6 에서 4.7, $5/$25) | per-request cost(요청당 비용)가 약 30% 오른다 | 계산 | 릴리스 노트 · pricing |
| 단가 | 내려간다 (Sonnet 4.6 $3/$15 에서 Sonnet 5 $2/$10) | 같은 글이면 약 13% 내려간다 (1.3 × 2 = 2.6 < 3) | 계산 | pricing · 릴리스 노트 |
| 기본 thinking 동작 | 새 모델에서 adaptive thinking 이 기본으로 켜진다 | 출력 토큰이 늘면 단가가 내려가도 비용이 오를 수 있다 | 계산 · 추론 | 뒤집히는 때 1 |
| 앞부분 길이 | 새 모델의 최소 캐시 길이 미만이다 | 캐싱이 조용히 꺼진다 | prompt-caching | |
| 개발 단계 | 초기 프로토타입이다 | 수동 테스트·도그푸딩으로도 한동안은 된다. 그래도 일찍 시작하기를 권한다 | ||
| 개발 단계 | 운영(production) 중이고 규모가 커졌다 | eval 없이 개발하면 무너진다 |
연습 문제
고객지원 Agent 를 Opus 4.6 에서 Opus 4.7 로모델 버전 올린다. 단가표는 입력·출력 모두 그대로단가 같음라서 팀장은 비용 걱정은 없으니 품질 eval 만 다시 보자고 한다. 무엇을 다시 재야 할까?
시험 대비
함정
- "데모에서 잘 됐으니 바로 배포한다" 는 함정이다. 한 번이나 몇 번 해 보는 테스트는 흔한 함정이다. eval 파이프라인으로 점수를 낸다 (Skilljar)
- "프롬프트 한 줄·핫픽스는 eval 을 건너뛴다" 는 함정이다. 변경마다 자동 eval 을 돌린다. 통과한 것만 배포한다
- "단가가 같으니 모델을 올려도 비용은 그대로다" 는 함정이다. 새 토크나이저는 같은 글의 토큰이 약 30% 더 나온다
- "모델을 바꾸면 캐시가 무효라서 비용이 올랐다"를 근거로 드는 보기는 함정이다. 근거로 약하다(prompt-caching 문서에 이 문장이 없다). 공식 근거는 새 토크나이저와 모델별 최소 캐시 길이다
- "Promptfoo 같은 특정 도구 이름"으로 고르는 보기는 함정이다. 공식 글 예시에 없다. 도구보다 과제가 먼저다
- "eval 은 기능이 된 다음에 만든다" 는 함정이다. 권장은 eval 먼저(eval-driven development)다
- "새 모델이 나오면 몇 주 손으로 테스트한다" 는 함정이다. eval 이 있으면 며칠이면 된다
- "eval 없이 불만이 오면 고친다" 는 함정이다. 그것은 불만을 기다리는 사후 대응이다
신호
"Automated evals are especially useful pre-launch and in CI/CD, running on each agent change and model upgrade as the first line of defense against quality problems."
"Absent evals, debugging is reactive: wait for complaints, reproduce manually, fix the bug, and hope nothing else regressed."
"We recommend practicing eval-driven development: build evals to define planned capabilities before agents can fulfill them, then iterate until the agent performs well."
"Once evals exist, you get baselines and regression tests for free: latency, token usage, cost per task, and error rates can be tracked on a static bank of tasks."
"teams without evals face weeks of testing while competitors with evals can quickly determine the model’s strengths, tune their prompts, and upgrade in days."
"This tokenizer produces approximately 30% more tokens for the same text."
"Run an effort sweep on your own evals rather than carrying settings over from an earlier model" (시험 뒤 변경 — Opus 5.5 절)
"they’re only as good as the eval tasks you run through them."
"Test the prompt once and decide it's good enough. This carries a significant risk of breaking in production when users provide unexpected inputs." (Skilljar)
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
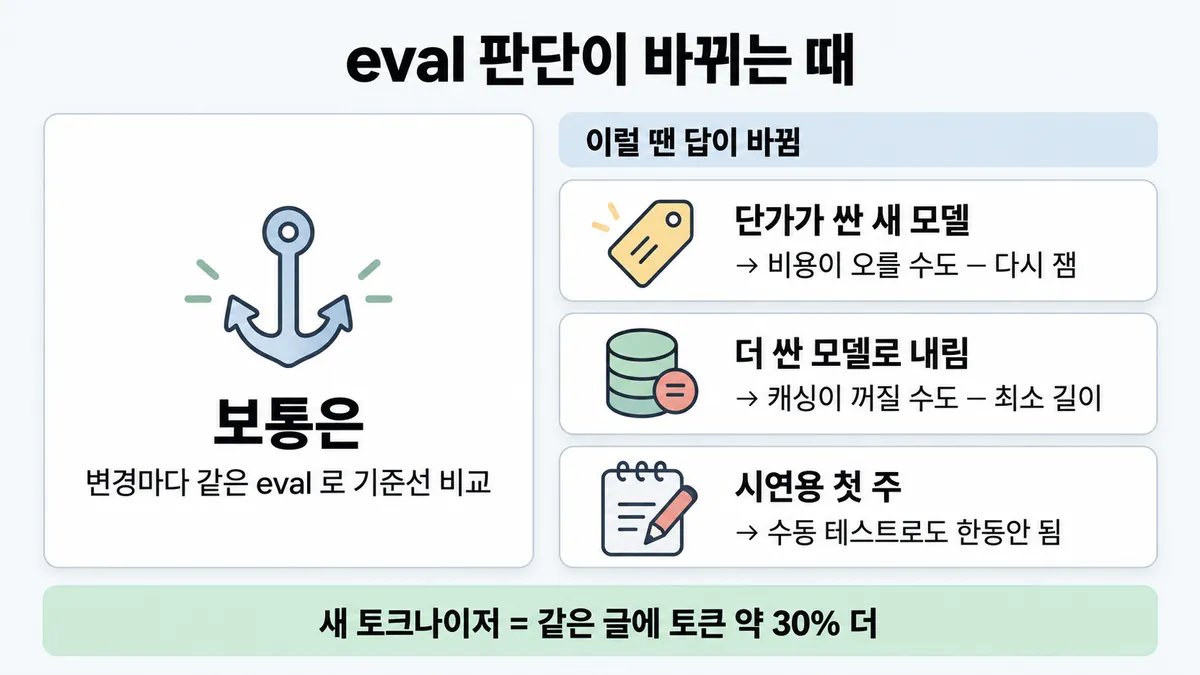
1. 단가가 싼 새 모델로 옮겼는데 per-request cost 가 오르는 때
- 조건 : Sonnet 4.6 에서 Sonnet 5 로 옮긴다. 요청은 입력 6,000 · 출력 800 토큰이다(옛 토크나이저 기준).
- 계산 : Sonnet 4.6 = 6,000 × $3 + 800 × $15 (백만 토큰당) = $0.018 + $0.012 = $0.030 이다. Sonnet 5 에서는 같은 글이 7,800 · 1,040 토큰이 된다. 그러면 $0.0156 + $0.0104 = $0.026 이다(약 13% 싸다). 그런데 Sonnet 5 는 adaptive thinking 이 기본으로 켜진다. thinking 이 출력 1,500 토큰을 더 쓰면 +$0.015 다. 합은 $0.041 이다(약 37% 비싸다).
- 전제 : 캐싱은 없다고 본다. thinking 토큰이 출력 단가로 과금된다고 본다(추론. 받아 둔 파일에서 과금 문장은 못 찾았다, 미해결 4). 1,500 은 가정값이다. 가격은 2026-09-28 조회값이다.
- 판단 : 단가표만 보고 "싸다"고 하지 않는다. 같은 과제 세트로 토큰·비용 기준선을 다시 잰다. 그 뒤 effort 로 조정한다.
- 등급 : 계산 (단가 · 30% · adaptive thinking 기본 켜짐은 확인)
- 근거 : pricing · 릴리스 노트 "adaptive thinking is now on by default" · effort(max_tokens = 사고 + 응답 합)
2. 더 싼 모델로 내렸더니 앞부분 캐싱이 꺼지는 때
- 조건 : 시스템 프롬프트 3,000 토큰(Sonnet 5 기준)을 매 요청 재사용하고, 캐시가 적중한다. 이 상태에서 Haiku 4.5 로 내린다.
- 계산 : Sonnet 5 최소 캐시는 1,024 라서 캐싱된다. 앞부분 비용 = 3,000 × $0.20 = $0.0006 이다. Haiku 4.5 는 옛 토크나이저라 같은 글이 ≈ 3,000 ÷ 1.3 ≈ 2,300 토큰이다. 이것은 최소 4,096 보다 작다. 그래서 캐싱이 안 되고, 오류도 나지 않는다. 앞부분 비용 = 2,300 × $1 = $0.0023 이다. 단가가 싼 모델인데 앞부분은 약 3.8배 비싸다.
- 전제 : 뒤 부분(바뀌는 입력·출력)은 뺀다. 적중률은 100% 로 본다. 가격은 2026-09-28 조회값이다.
- 판단 : 모델 교체 뒤
cache_creation_input_tokens·cache_read_input_tokens가 둘 다 0 이면 최소 길이부터 본다(■ 프롬프트 캐싱). 비용 기준선은 캐싱을 포함해 다시 잰다. - 등급 : 계산 (최소 길이·단가는 확인)
- 근거 : prompt-caching · 표(Sonnet 5 읽기 $0.20 · Haiku 4.5 입력 $1) · pricing
3. 아주 초기 프로토타입 — eval 없이도 되는 것 같은 때
- 조건 : 사내 시연용 첫 주다. 수동 테스트와 도그푸딩으로 빠르게 고치는 중이다.
- 판단 : 공식도 초기에는 수동 테스트와 직관으로도 한동안은 된다고 인정한다. 하지만 운영·규모로 가면 eval 없이는 무너진다. 늦을수록 eval 만들기도 어렵다. 그래서 실제 실패에서 뽑은 20~50개로 일찍 시작한다(■ 첫 eval 셋 만들기).
4. 새 모델이 기본값을 바꾼 때 (시험 뒤 변경)
- 조건 : Opus 5 에서 Opus 5.5 로 옮긴다. effort 를 적지 않은 요청이다.
- 판단 : Opus 5.5 는 기본 effort 가
medium이다(Opus 5 =high). 그래서 같은 요청이 한 단계 낮게 실행된다. thinking 을 끌 수 없다. 이전 모델 설정을 그대로 쓰지 않는다. 자체 eval 에서 effort 스윕을 한다. - 등급 : 시험 뒤 변경 (2026-09-22 출시. 시험은 이 모델을 모를 수 있다)
- 근거 : effort · 릴리스 노트
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "데모에서 잘 됐으니 바로 배포" | 눈으로 확인했다 | 한 번이나 몇 번 해 보는 테스트는 흔한 함정이다. eval 파이프라인으로 점수를 낸다 | Skilljar 287731 | |
| "프롬프트 한 줄 핫픽스는 eval 건너뜀" | 작은 변경 같다 | 변경마다 돌리는 자동 eval 이 첫 방어선이다 | ||
| "단가가 같은 새 모델이니 비용 그대로" | 가격표가 같다 | 같은 글의 토큰이 약 30% 더 나온다 | 계산 | pricing · 릴리스 노트 |
| "모델을 바꾸면 캐시가 무효라서 비용이 올랐다" | 그럴듯한 원인이다 | 받아 둔 문서에 이 문장이 없다. 공식 근거는 새 토크나이저와 모델별 최소 캐시 길이다 | (공식 근거 쪽) · 미해결(문장 부재) | pricing · prompt-caching · 미해결 1 |
| "Promptfoo 같은 특정 도구로 표준화" | 이름이 구체적이다 | 공식 글 예시에 없다. 도구보다 과제가 먼저다 | ||
| "eval 은 기능이 완성된 뒤에" | 측정할 게 먼저 있어야 할 것 같다 | 권장은 eval 먼저(eval-driven development)다 | ||
| "새 모델 나오면 몇 주 수동 테스트" | 신중해 보인다 | eval 이 있으면 며칠이면 된다 | ||
| "품질 eval 만 다시 돌리면 모델 교체 끝" | 품질이 제일 중요해 보인다 | 비용·지연 기준선도 다시 잰다(토크나이저·캐시 최소 길이·effort 기본값) | 계산 | 뒤집히는 때 1·2 |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 4.3 공식 시험 가이드 v1.0
- demystifying-evals 글
- develop-tests
- choosing-a-model
- effort
- pricing
- prompt-caching
- 릴리스 노트
- Skilljar API 287731
- 287736
상태
- 계산 2줄(④ 요청당 비용 변화)
- 시험 뒤 변경 1줄(④ Opus 5.5 effort 기본값)
미해결
- "모델 교체 = 캐시 무효" 라는 공식 문장을 못 찾았다.
grep -i "same model|each model|switching models|change.{0,10}model"을 en-prompt-caching.md 에 돌렸더니 234줄(effort 무효화 표)만 잡혔다. 무효화 표는 thinking·effort 만 다룬다. 목록 4.3③ 의 "?" 표시와 같은 결론이다. - Promptfoo : demystifying-evals 에서
promptfoo는 0건이다(같은 grep 에서 Braintrust은 잡혔다 = 양성 대조). 받아 둔 다른 docs 는 뒤지지 않았다. - Console 평가 도구 : 원문 파일을 받지 않아 확인하지 않았다(목록도 "현행 문서 재확인 못 함").
- thinking 토큰이 출력 단가로 과금된다는 문장은 pricing·effort 파일에서 못 찾았다. 그래서 뒤집히는 때 1 은 이 전제를 추론으로 둔다. effort은 "max_tokens = 사고 + 응답 합" 까지만 말한다.
- 목록 4.3③ 의 "4.7 이후 모델의 새 토크나이저(약 30%)" 는 pricing에 그대로 있다. 릴리스 노트의 Opus 4.7 항목(2026-04-16)에는 "updated tokenizer" 만 있다. 30% 숫자는 Fable 5(2026-06-09)·Sonnet 5(2026-06-30) 항목에 있다. 고친 곳은 없고, 출처만 pricing 을 정본으로 삼는다.