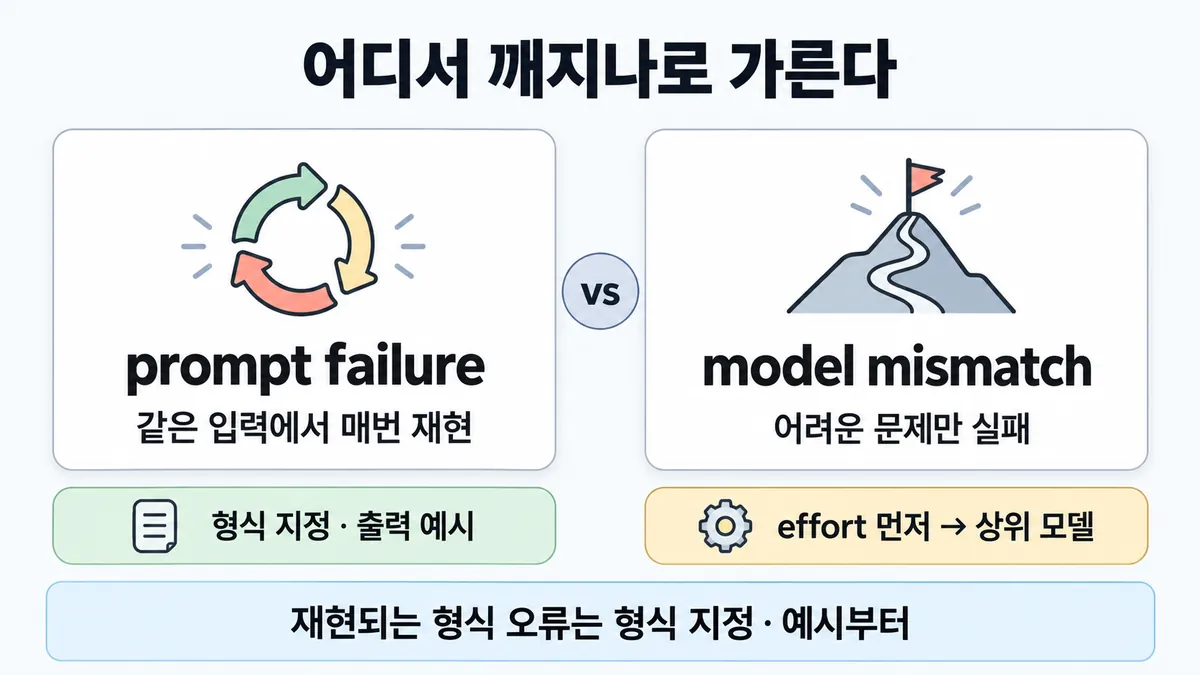
◆ prompt failure vs model mismatch
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 4.4 문제 진단 · D4 평가 16%Diagnose system issues (prompt failure, hallucinations, model mismatch)
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 4.4③ 형식이 매번 깨진다 vs 더 강한 설정에서만 풀린다 — prompt failure vs model mismatch 가르기
- 2.1② 품질이 조금 모자라거나 비용이 남는다 — 모델을 바꿀까, effort 를 바꿀까? — 조절 수단 순서 (effort → 모델 교체 → 섞인 요청은 모델 조합·라우팅)
- 3.3① 상담원이 "답 초안이 늦게 뜬다"고 한다 — 모델부터 바꾸나? — 지연 lever 고르기 (스트리밍 · 캐싱 · 출력 길이 · effort · 모델 교체)
- 6.2① 실행 가능한 설계가 둘 — 아키텍트가 골라 통보할까, 책임자가 고르게 할까? — 절충 전달 방식 (평가 근거 붙은 선택지 공개 → 책임자 결정)
한눈에
ELI5
심부름을 시켰는데 일이 잘못됐어요.
- 매번 같은 곳에서 틀린다면, 내 설명이 헷갈렸던 거예요. 설명을 고쳐요.
- 쉬운 건 잘하는데 어려운 것만 틀린다면, 먼저 "천천히 잘 생각해" 하고 시간을 더 줘요.
- 시간을 충분히 줘도 못 한다면, 그때 더 잘하는 사람에게 맡겨요.
- 종이가 모자라 중간에 멈췄다면, 설명도 사람도 아니고 종이를 더 줘요.
개념 설명
원리
세 층의 lever(조절 수단)
- lever 는 아래 순서로 있다. 앞의 것이 싸고 빠르다.
- 프롬프트(지시·형식·예시)
- 모델 안 lever(effort)
- 모델 자체(교체)
- 공식 순서는 이렇다. 모델을 바꾸기 전에 effort 를 조정하는 것이 흔히 더 나은 lever 다. xhigh·max 로도 eval 이 모자랄 때만 상위 모델로 간다. 업그레이드는 특정 능력 격차가 있을 때만 한다.
prompt failure(프롬프트 실패)의 모양
- 같은 입력에서 같은 식으로 깨지면 지시·형식이 모자란 것이다 (재현된다는 판별 틀은 업계 일반).
- 대책은 출력 형식을 정확히 지정하기, 원하는 출력 예시 넣기(추상 지시보다 효과적), 복잡하면 체이닝하기다.
- 형식 보장이 필요하면 structured outputs 를 쓴다. 제약된 디코딩으로 필수 필드·타입까지 보장한다. 공식 스스로 "잘 짠 프롬프트로도 필수 필드 누락은 생길 수 있다"고 한다. 그래서 프롬프트만으로 100% 는 아니다.
model mismatch(모델 부적합)의 모양
- 문맥·프롬프트가 맞는데 어려운 문제만 틀리면 추론(reasoning) 양이나 능력이 모자란 것이다.
- Opus 4.7 안내는 이렇다. 추론이 얕으면 프롬프트로 우회하지 않는다. effort 를 올린다.
- 반대 mismatch 도 있다. 쉬운 일에 너무 큰 모델이나 높은 effort 를 쓰면 비용·지연(latency) 낭비다. max 는 구조화 출력에서 과도한 thinking(사고)으로 이어질 수도 있다.
둘 다 아닌 것
- 끊긴 JSON(
stop_reason: "max_tokens")은 출력 한도 문제다. 형식·모델 문제가 아니다. - prefill 400 은 4.6 이후 모델이 prefill 을 안 받는 것이다. 형식 대책이 막힌 것이지 모델 능력 문제가 아니다.
규칙과 판단
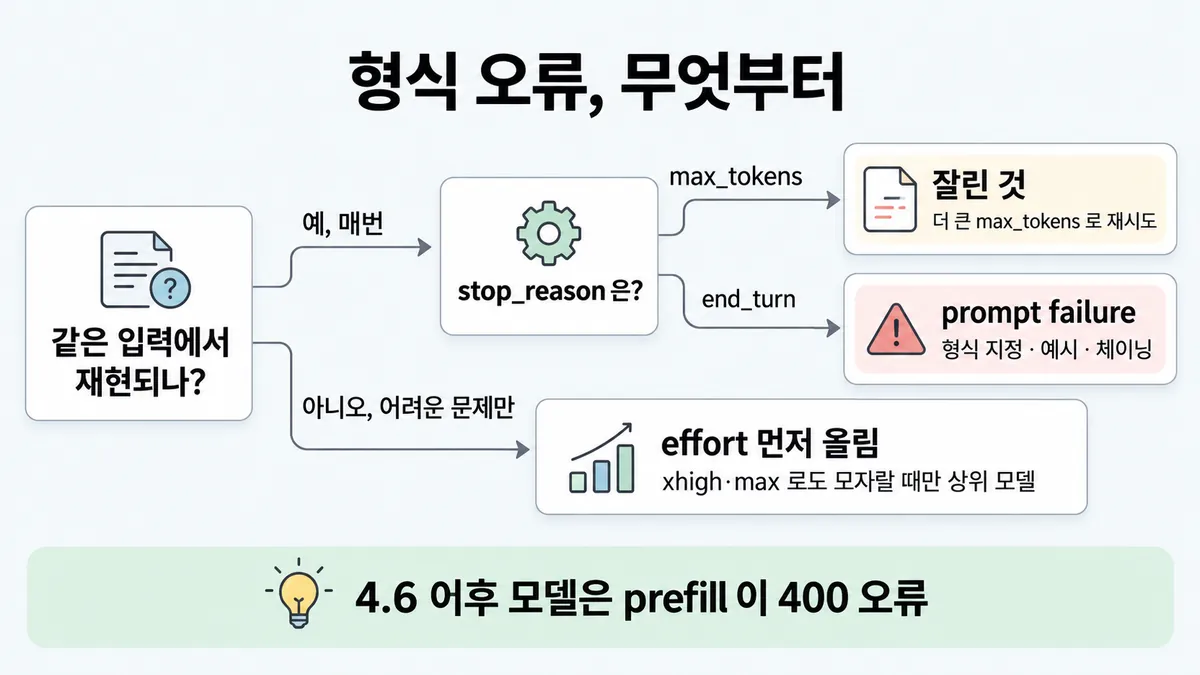
갈림길
어디서 깨지나 [4.4③]
stop_reason 이 무엇인가?max_tokens
잘린 것이다
형식 실패가 아니다. 더 큰 max_tokens 로 재시도한다
end_turn
prompt failure
출력 형식을 정확히 지정한다. 원하는 출력 예시를 넣는다. 복잡하면 체이닝한다
다음 물음 — 지금 effort 가 어느 수준인가?
모델 쪽 lever [4.4③] [2.1②]
effort 를 올린다
모델을 바꾸기 전에 effort 를 조정하는 것이 흔히 더 나은 lever(조절 수단)다
상위 모델
xhigh·max 로도 모자랄 때만 상위 모델(Fable 5.1)로 간다
max 는 가장 어려운 문제용
대부분은 품질 이득이 작은데 비용만 크게 는다. 구조화 출력에서는 과도한 thinking(overthinking)으로 이어질 수 있다
형식 고정 수단 [4.4③]
prefill 금지
structured outputs, 시스템 프롬프트 지시, output_config.format 을 쓴다
prefill 도 된다
이전 모델은 prefill 을 계속 지원한다. 단 JSON outputs 와는 같이 못 쓴다
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 앱 → 모델 → 출력
질문 : 같은 입력이면 매번 같은 자리에서 깨질까?
① 같은 입력에서 매번 깨지면 프롬프트 ✓
- 시작 : 앱 — 쪽지 : 주문 메일 #4821 / "JSON 으로 뽑아 줘"
- 요청 : 앱 → 모델 : 같은 입력을 보낸다 — 쪽지 : 같은 메일 #4821 / 5번째 요청
- 출력 : 모델 → 출력 : 필수 필드가 매번 빠진다 — 쪽지 : {"order_id":"4821"} / delivery_date 없음 / stop_reason : end_turn
- 고침 : 앱 : 출력 형식과 원하는 출력 예시를 넣는다 — 쪽지 : 형식 : order_id, / delivery_date 필수 / + 출력 예시 1개
- 요청 : 앱 → 모델 : 형식을 정해 요청한다 — 쪽지 : 같은 메일 #4821 / + 형식 · 예시
- 출력 : 모델 → 출력 : 필드가 다 채워진다 — 쪽지 : {"order_id":"4821", / "delivery_date": / "10-02"}
- 끝 : 같은 입력에서 매번 재현되는 형식 오류는 prompt failure 다. 모델 교체가 아니다
② 어려운 문제만 실패하면 effort 먼저 ✓
- 시작 : 앱 — 쪽지 : 환불 + 교환 + 쿠폰이 / 겹친 어려운 문의만 틀림
- 요청 : 앱 → 모델 : 문맥·프롬프트는 맞다 — 쪽지 : 문맥 · 프롬프트 OK / effort : 기본값
- 올림 : 모델 : effort 를 올린다 — 쪽지 : effort 를 올려 / eval 다시 (xhigh·max 까지)
- 출력 : 모델 → 출력 : eval 로 다시 잰다 — 쪽지 : 어려운 문의 eval / effort 올린 뒤 재측정
- 끝 : effort 를 올려도(xhigh·max) eval 이 모자랄 때만 상위 모델로 간다
③ prefill 로 형식 고정 ≠
- 시작 : 앱 — 쪽지 : 주문 메일 #4821 / "JSON 으로 뽑아 줘"
- 요청 : 앱 → 모델 : 마지막 assistant 턴을 prefill 한다 — 쪽지 : messages 끝 : / role : "assistant" / content : "{"
- 거절 : 모델 → 앱 : 4.6 이후 모델은 거절한다 — 쪽지 : 400 / invalid_request_error
- 끝 : 4.6 이후 모델은 prefill 을 안 받는다. structured outputs, 시스템 프롬프트 지시,
output_config.format을 쓴다
반복
같은 주문 메일을 5번 보내 보기
- ① 형식 지정 없음 — 5번 모두 같은 필드가 빠진다. 매번 재현된다 ≠
- ② structured outputs — 5번 모두 필수 필드가 있다 ✓
가정① 은 그림용 가정이다. 형식을 안 정한 프롬프트가 같은 필드를 늘 빠뜨린다고 본다. 실제 측정값이 아니다
규칙 원문 갈림 기준 (갈림길로 그린 규칙)
갈림 기준
같은 입력에서 재현되나? 더 강한 설정에서만 풀리나?
- 같은 입력에서 매번 재현되는 형식 오류는 prompt failure(프롬프트 실패)다. 대책은 셋이다
- 출력 형식을 JSON·XML·템플릿으로 정확히 지정한다
- 원하는 출력 예시를 넣는다(추상 지시보다 효과적이다)
- 복잡하면 작은 하위 작업으로 체이닝한다
- 지원 모델이면 structured outputs(
output_config.format·strict: true)를 쓴다. 그러면 필수 필드·타입까지 보장된다. 잘 짠 프롬프트로도 필수 필드 누락은 생길 수 있다 - JSON 이 중간에 끊기면(
stop_reason: "max_tokens") 형식 실패가 아니다. 더 큰max_tokens로 재시도한다. 자세한 것은 ■ stop_reason 으로 분기 · ■ max_tokens 와 긴 출력 에 있다 - prefill 은 형식 대책이 아니다. 4.6 이후 모델은 마지막 assistant 턴 prefill 에 400
invalid_request_error를 낸다. 대신 structured outputs, 시스템 프롬프트 지시,output_config.format을 쓴다 - 이전 모델은 prefill 을 계속 지원한다. 단 JSON outputs 와는 같이 못 쓴다
- 문맥·프롬프트가 맞는데 어려운 문제만 실패하면 model mismatch(모델 부적합) 후보다. 모델을 바꾸기 전에 effort 를 조정하는 것이 흔히 더 나은 lever 다
- 복잡한 문제에서 추론(reasoning)이 얕으면 프롬프트로 우회하지 않는다. effort 를 올린다 (Opus 4.7 안내)
- xhigh·max 로도 eval 이 모자랄 때만 상위 모델(Fable 5.1)로 간다
- max 는 가장 어려운 문제용이다. 대부분은 품질 이득이 작고 비용만 크게 는다. 구조화 출력에서는 과도한 thinking(overthinking)으로 이어질 수 있다
- 반대 방향 model mismatch(너무 큰 모델)도 있다. eval 이 품질 유지를 보이면 effort 를 낮추거나 모델을 내린다. 자세한 것은 ■ 지연 줄이기 lever 에 있다
- 바꿀지는 내 실제 프롬프트·데이터로 만든 벤치마크 eval 로 비교해 정한다. 좋은 eval 셋이 가장 중요한 단계다. 업그레이드는 특정 능력 격차가 있을 때만 한다. 자세한 것은 ■ 첫 eval 셋 만들기 에 있다
판별 틀 자체 : "더 강한 모델·effort 에서만 풀리면 model mismatch" 로 가른다 업계 일반 공식 문장 없음
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 등급 | 근거 |
|---|---|---|---|
| 같은 입력에서 형식 오류가 매번 재현된다 | 형식을 정확히 지정한다 · 예시를 넣는다 · 체이닝한다 | (재현 판별 틀은 업계 일반) | increase-consistency |
| 필수 필드·타입이 꼭 맞아야 한다 | structured outputs 를 쓴다 (output_ · strict: true) | structured-outputs | |
| JSON 이 중간에 끊긴다 | stop_ 다. 더 큰 max_ 를 준다 | structured-outputs | |
| 4.6 이후 모델에 prefill 한다 | 400 invalid_ 가 난다. structured outputs · 시스템 프롬프트 · output_ 을 쓴다 | errors · prompting-best-practices | |
| 문맥·프롬프트는 맞는데 어려운 문제만 실패한다 | effort 를 먼저 본다 | choosing-a-model | |
| 복잡한 문제에 추론이 얕다 (Opus 4.7) | 프롬프트로 우회하지 않는다. effort 를 올린다 | effort | |
| xhigh·max 로도 eval 이 모자란다 | 상위 모델로 간다 (Fable 5.1) | choosing-a-model | |
| max 를 기본값으로 두려 한다 | max 는 가장 어려운 문제용이다. 대부분은 이득이 작고 비용이 크다 | effort | |
| 모델을 바꿀지 판단한다 | 실제 프롬프트·데이터로 만든 벤치마크 eval 로 비교한다 | choosing-a-model | |
| 낮은 설정에서도 eval 이 품질 유지를 보인다 | effort 를 낮추거나 모델을 내린다 | choosing-a-model · effort |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 재현성 | 같은 입력에서 매번 깨진다 | 프롬프트 | 업계 일반 | 목록 4.4③ 틀이다. 공식 문장이 없다 |
| 재현성 | 어려운 입력에서만 깨진다 | effort 를 먼저, 그다음 모델 | choosing-a-model | |
stop_ | max_ 다 | 출력 한도 | structured-outputs | |
| 모델 세대 | 4.6 이후다 | prefill 은 400 | errors | |
| 모델 세대 | 4.6 이전이다 | prefill 이 된다 (JSON outputs 와는 같이 못 쓴다) | prompting-best-practices · structured-outputs | |
| effort 지정 | 생략했고 Opus 5.5 다 | medium 으로 실행된다 | 시험 뒤 변경 | effort |
| effort 지정 | 생략했고 그 밖의 effort 지원 모델이다 | high 로 실행된다 | effort | |
| 과제 | 구조화 출력이거나 지능이 덜 드는 일이다 | max 는 과도한 thinking 위험이 있다 | effort (Opus 4.7 표) | |
| 과제 | 30분 넘는 에이전트·코딩 작업이다 | xhigh 쪽 | effort | |
| 지연 제약 | effort 를 못 올린다 | 목표 지향 문구를 더한다 ("This task involves multistep reasoning...") | effort |
연습 문제
주문 확인 메일에서 JSON 을 뽑는데, 같은 메일을 넣으면 매번매번 재현 delivery_date 필드가 빠진다. 응답은 stop_reason: "end_turn" 으로 끝난다끝까지 씀. 팀원은 더 큰 모델로 바꾸자고 한다. 먼저 할 일은?
시험 대비
함정
- "가장 큰 모델과 effort max 를 기본값으로 둔다" 는 함정이다. max 는 가장 어려운 문제용이다. 대부분은 비용만 크게 는다
- "prefill 로 형식을 고정한다" 는 함정이다. 4.6 이후 모델은 400 을 낸다
- 형식이 매번 깨지는데 모델부터 바꾸는 것은 함정이다. 업그레이드는 특정 능력 격차가 있을 때만 한다. 재현되는 형식 오류는 형식 지정과 예시부터 본다
- JSON 끊김을 프롬프트 탓으로 보는 것은 함정이다.
stop_reason: "max_tokens"이면 더 큰max_tokens를 준다 - 얕은 추론에 "생각 깊게 하라"는 문구만 덧대는 것은 함정이다. effort 를 올린다. 지연(latency) 때문에 effort 를 낮게 둬야 할 때만 문구를 더한다
- 모델을 옮긴 뒤 추론이 얕아진 것을 "모델이 약함"으로 보는 것은 함정이다. effort 기본값부터 본다. 자세한 것은 ■ 변경부터 묻는 진단 에 있다
- increase-consistency 문서는 지금도 "Prefill Claude's response" 를 권한다. 그러나 4.6 이후 모델에는 안 맞는다. 오류·프롬프팅 문서는 400 이라고 한다
- Skilljar API 강의(2025 제작 추정)는 "prefill + stop sequence 로 깨끗한 JSON" 을 가르친다. 4.6 이후 모델은 400 을 낸다
신호
"Provide examples of your desired output. This is more effective than abstract instructions."
"Tuning effort is often a better lever than switching models."
"If you observe shallow reasoning on complex problems with Claude Opus 4.7, raise effort rather than prompting around it."
"Reserve for frontier problems. On most workloads max adds significant cost for relatively small quality gains"
"Sending a request with a prefilled last assistant message to any of these models returns a 400 invalid_request_error"
"Retry with a higher max_tokens value to get the complete structured output"
"Upgrade only if necessary for specific capability gaps."
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
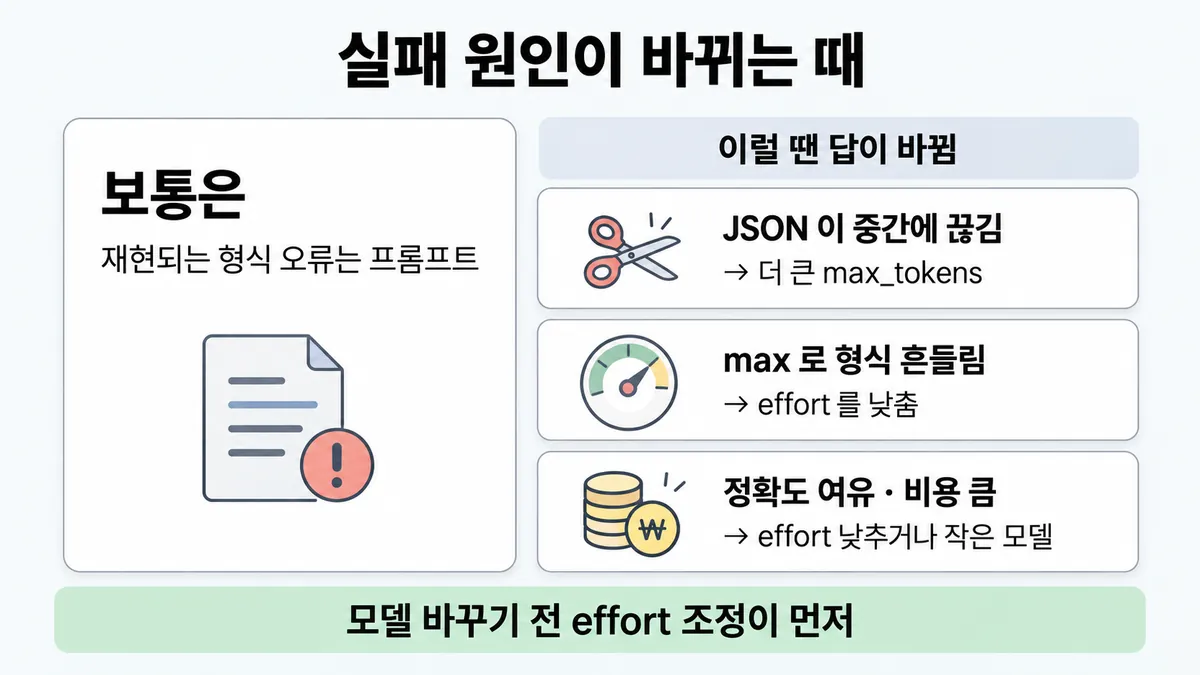
뒤집히는 때
1. 형식이 매번 깨지는데 프롬프트 탓이 아닌 때 — 출력 한도
- 조건 : 주문 150건을 JSON 배열로 뽑는다. 항목당 약 35 토큰이다.
max_tokens는 4,096 이다. - 계산 : 150 × 35 = 5,250 토큰 > 4,096 이다. 그래서 매번 같은 자리에서 끊긴다. 같은 입력에서 재현되니 prompt failure 처럼 보인다.
- 판단 :
stop_reason이max_tokens면 한도 문제다. 더 큰max_tokens로 재시도한다(또는 나눠 요청한다). - 전제 : 항목당 토큰은 예시 가정값이다. 새 토크나이저 모델이면 약 30% 더 나온다. 그러면 한도를 더 일찍 넘는다.
- 등급 : 계산 (처방은 확인)
- 근거 : structured-outputs · pricing
2. effort 를 올렸더니 형식이 오히려 흔들리는 때
- 조건 : 단순 분류를 구조화 출력으로 받는다. 그런데 "품질을 위해" max 로 올렸다.
- 판단 : 공식(Opus 4.7 표)은 max 가 구조화 출력이나 지능이 덜 드는 일에서 과도한 thinking 으로 이어질 수 있다고 한다. 그래서 올리는 것이 답이 아니다. 낮추는 쪽이다.
- 등급 : (Opus 4.7 표 문장이다. 다른 모델에 같은 문장은 없다)
- 근거 : effort
3. "모델이 약하다"가 사실은 기본값인 때
- 조건 : Opus 5 에서 통과하던 긴 다단계 추론이 Opus 5.5 로 옮긴 뒤 실패한다. 요청에 effort 가 없다.
- 판단 : Opus 5.5 기본값은 medium 이라 한 단계 낮게 실행된다. model mismatch 로 보기 전에 effort 를 올려 다시 잰다. 이전 설정을 들고 오지 않는다. effort 를 다시 훑어본다.
- 등급 : 시험 뒤 변경 (2026-09-22). 자세한 것은 ■ 변경부터 묻는 진단 에 있다
- 근거 : effort
4. prefill 이 아직 맞는 답인 때
- 조건 : 4.6 이전 모델(예 Haiku 4.5)을 쓰는 옛 시스템이다. JSON outputs 는 안 쓴다.
- 판단 : 이전 모델은 prefill 을 계속 지원한다. 그래서 "prefill 은 항상 오답"은 아니다. 단 JSON outputs 와는 같이 못 쓴다. 시험 보기가 모델을 밝히지 않으면 4.6 이후 기준(400)이 안전하다(추론).
- 등급 : (지원 여부) · 추론 (시험 기준)
- 근거 : prompting-best-practices · structured-outputs
5. model mismatch 가 "너무 큰" 쪽인 때
- 조건 : 하루 12만 건의 짧은 문의 분류를 Opus 로 돌려 지연·비용이 크다. 정확도는 여유가 있다.
- 판단 : mismatch 는 더 큰 모델 쪽으로만 나지 않는다. eval 로 품질 유지를 확인하며 effort 를 낮추거나 더 작은 모델로 간다. 자세한 것은 ■ 지연 줄이기 lever 에 있다.
- 근거 : choosing-a-model
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 근거 |
|---|---|---|---|
| "가장 큰 모델 + effort max 를 기본값으로" | 최고 설정이면 안전해 보인다 | max 는 가장 어려운 문제용이다. 대부분은 이득이 작고 비용이 크다. 과도한 thinking 도 생긴다 | effort (목록 4.4③ 매력적인 오답) |
| "prefill 로 형식 고정" | 옛 강의·옛 문서의 기법이다 | 4.6 이후 모델은 400 을 낸다 | errors · Skilljar 287732(옛 기법) |
| 재현되는 형식 오류에 "더 큰 모델" | 큰 모델이 형식도 잘 지킬 것 같다 | 업그레이드는 특정 능력 격차가 있을 때만 한다. 형식 지정·예시·structured outputs 가 먼저다 | choosing-a-model · increase-consistency |
| 끊긴 JSON 에 "형식 예시를 더 넣음" | 형식 문제처럼 보인다 | max_ 한도 문제다. 예시를 넣으면 입력만 늘어난다 | structured-outputs |
| 얕은 추론에 "더 생각하라는 문구만 추가" | 프롬프트 수정이 싸 보인다 | Opus 4.7 안내는 effort 를 올린다. 문구는 지연 때문에 effort 를 못 올릴 때 쓴다 | effort |
| "effort 로 안 되면 곧바로 모델 교체" | 빨리 해결될 것 같다 | xhigh·max 까지 eval 로 확인한 뒤에 바꾼다 | choosing-a-model |
| "abstract 지시를 더 길게 쓰면 된다" | 설명을 늘리면 알아들을 것 같다 | 예시가 추상 지시보다 효과적이다 | increase-consistency |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 4.4 공식 시험 가이드 v1.0
- docs increase-consistency
- structured-outputs
- errors
- prompting-best-practices
- choosing-a-model
- effort
- 릴리스 노트
- Skilljar API 287732
상태
- 업계 일반 1줄(판별 틀)
미해결
- increase-consistency 문서(2026-09-28 받은 판)는 지금도 "Prefill Claude's response" 를 권한다. 이것은 errors·prompting-best-practices 문서의 "4.6 이후 400" 과 어긋난다. 문서끼리 어긋나는 채로 두고, 카드는 400 쪽을 따른다.
- 목록 4.4③ 의 "더 강한 tier 에서만 되면 model mismatch" 판별 틀은 영상의 틀이다. 공식 문장이 없다(카드에 업계 일반으로 표시).
- structured outputs 지원 모델 목록 원문(모델별 표)은 확인하지 않았다. 그래서 "지원 모델이면"으로만 쓴다.
- 목록 4.4③ 의 "prefill 은 4.6 이후 모델에서 400" 은 원문과 같다(errors) ✓. 목록의 effort 기본값 "대부분 high, Opus 5.5 는 medium (2026-09-27 조회)" 도 effort과 같다.