■ few-shot 예시
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 2.3 프롬프트 기법 · D2 모델·프롬프트 13%Apply prompt engineering techniques (zero-shot, few-shot, chain-of-thought)
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 2.3① 답의 형식·톤이 들쭉날쭉하다 — 지시를 더 쓸까, 예시를 줄까? — zero-shot(지시만) vs few-shot(예시) · 예시를 어떻게 고르나
- 4.4③ 형식이 매번 깨진다 vs 더 강한 설정에서만 풀린다 — prompt failure vs model mismatch 가르기
- 2.5① 8,000토큰 정책이 매 요청 반복되고 질문만 바뀐다 — 비용·지연을 함께 줄이려면? — 반복 접두부 재사용 (공식 샘플 2)
한눈에
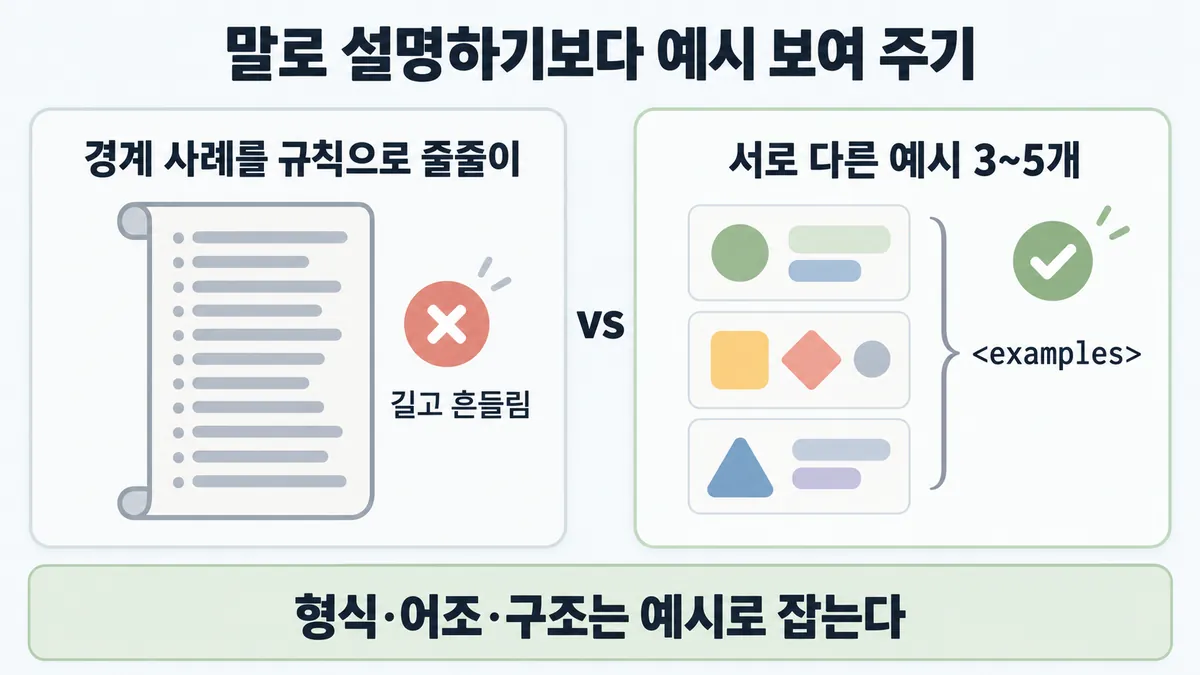
원하는 답의 예시를 몇 개 보여 준다. 출력 형식·어조·구조를 잡는 가장 확실한 방법 중 하나다. 정확도와 일관성이 오른다
추상적인 지침보다 원하는 출력의 예시가 더 효과적이다
비유 로그 파서 규칙을 말로 길게 설명하는 대신 정상·에러·멀티라인 샘플 몇 줄을 같이 주는 것과 같다. 모든 예외를 if 분기로 하드코딩하지 않는다
ELI5
그림 그리는 법을 말로 설명하는 대신, 잘 그린 그림 몇 장을 보여 주는 거예요.
- 말로 "예쁘게 그려" 하면 사람마다 다르게 그려요.
- 잘 그린 그림 서너 장을 보여 주면 비슷하게 그려요.
- 그런데 보여 준 그림이 다 빨간색이면, 빨간 게 규칙인 줄 알아요.
- 그래서 서로 다른 그림을 골라서, "이건 보기예요" 하고 따로 담아 줘요.
개념 설명
원리
예시가 지시보다 센 이유
- 형식·어조·구조는 말로 정확히 설명하기 어렵다. 예시는 "보여 주기" 라서 모델이 바로 따라 한다. 공식은 예시를 출력 형식·어조·구조를 잡는 가장 확실한 방법 중 하나로 본다.
- 추상적인 지침보다 원하는 출력의 예시가 더 효과적이다.
예시의 부작용 = 우연한 공통점도 배움
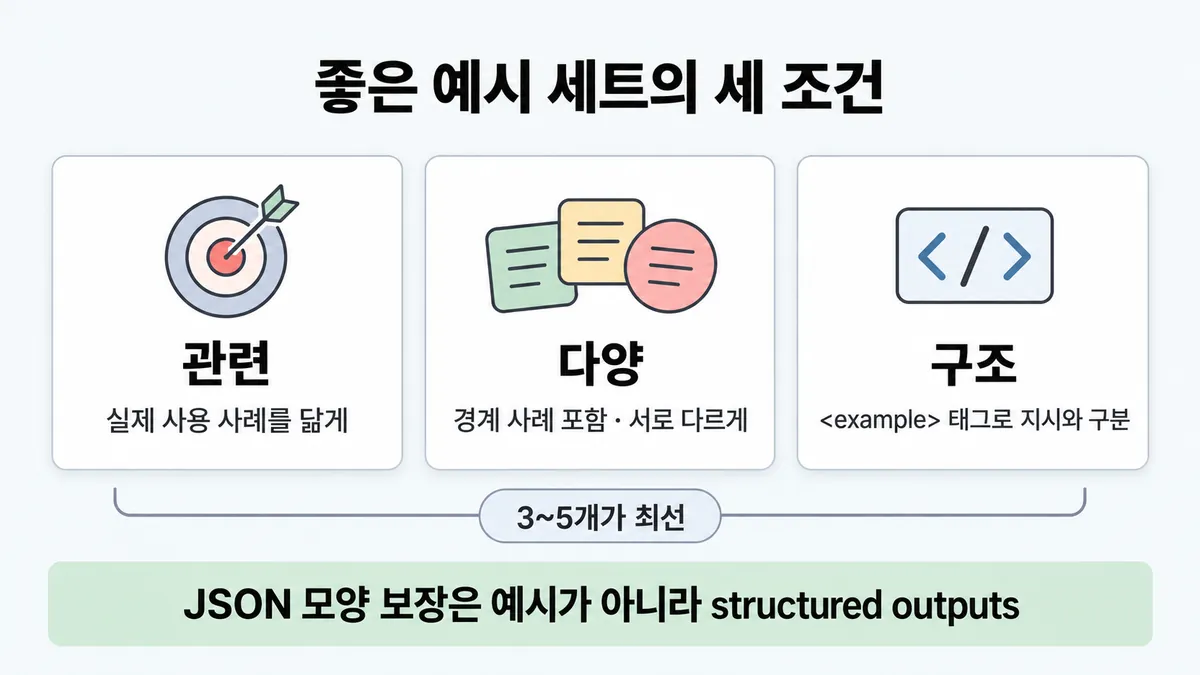
- 예시끼리 공통점(길이·주제·첫 단어)이 있으면 모델은 그것도 규칙으로 읽는다. 그래서 "다양성" 조건이 있다. 경계 사례를 넣고, 의도 안 한 패턴을 따라 하지 않게 충분히 다르게 한다.
- 예시가 지시와 섞이면 어디까지가 예시인지 헷갈린다. 그래서
<example>/<examples>태그로 감싼다.
규칙 목록 vs 대표 예시
- 모든 경계 사례를 규칙 문장으로 나열하면 프롬프트가 길어지고 깨지기 쉽다. 그래서 서로 다르고 대표적인(canonical) 예시 몇 개로 기대 행동을 그림처럼 보여 준다.
- 컨텍스트는 한정 자원이다. 그래서 예시도 "작지만 쓸모 있는 정보가 많은(high-signal)" 쪽으로 고른다.
언제 넣나
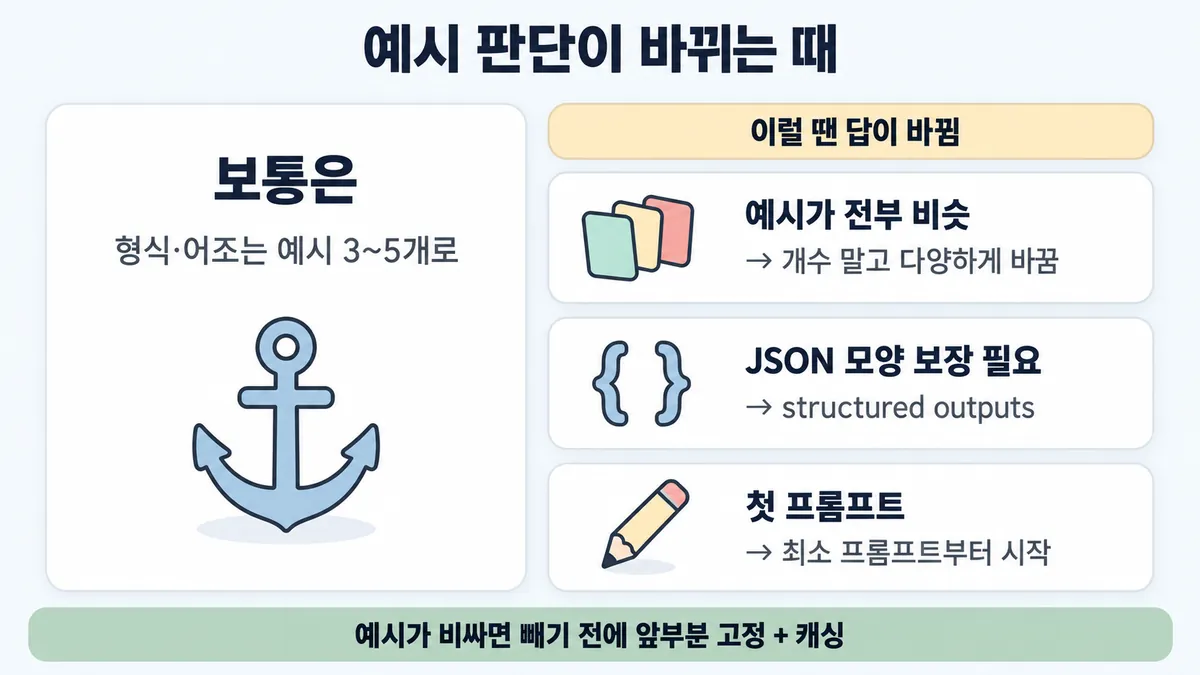
- 처음부터 예시를 잔뜩 넣지 않는다. 가장 좋은 모델로 최소 프롬프트를 시험한다. failure modes(실패 유형)가 형식·어조면 예시를 넣고, 판단 기준이면 지시를 넣는다.
- 모양을 보장해야 하면 예시가 아니라 스키마를 쓴다. 자세한 것은 ■ structured outputs 에 있다.
규칙과 판단
갈림길
①④ 지시냐 예시냐 [2.3①] [4.4③]
예시를 넣는다
예시는 출력 형식·어조·구조를 잡는 가장 확실한 방법 중 하나다
예시 말고 스키마
모양 보장은 structured outputs 가 한다. 자세한 것은 ■ structured outputs 에 있다
최소 프롬프트부터
가장 좋은 모델로 최소 프롬프트를 먼저 시험한다. 그다음 failure modes(실패 유형)를 보고 지시와 예시를 더한다
좋은 예를 보여 준다
"하지 마" 지시나 나쁜 예보다 좋은 예가 더 효과적이다
②③ 예시 세트 고치기 [2.3①]
서로 다르게 고른다
같은 모범 답 하나를 여러 번 반복하면 다양성 조건을 어긴다 (반복 자체를 콕 집은 공식 문장은 없다. 다양성 조건에서 추론했다). 경계 사례를 넣고, 의도 안 한 패턴을 따라 하지 않을 만큼 다르게 고른다
대표 예시 몇 개를 고른다
경계 사례 목록을 채우는 것은 권하지 않는다. 서로 다르고 대표적인(diverse, canonical) 예시를 고른다
example 태그
<example>(여럿이면 <examples>)로 감싸 지시와 구분한다
3~5개
3~5개가 최선이다
나머지 규칙
-
thinking 과 함께 : 예시 안에
<thinking>태그로 추론(reasoning) 패턴을 보여 준다. 그러면 모델이 그 스타일을 extended thinking(확장 사고) 블록에 일반화한다. thinking 켜기와 깊이는 ■ 모델별 thinking 제어 에 있다 -
예시 고르는 법 (Skilljar) 은 아래와 같다 (docs 와 충돌이 없다)
- eval 에서 최고 점수를 받은 입력·출력 쌍을 예시로 쓴다
- 왜 좋은 답인지 한 줄 덧붙인다
- 가장 흔한 실패 사례를 다루는 예시를 넣는다
- 입력과 이상 출력을 태그(
<sample_input>·<ideal_output>)로 구분한다
-
예시 블록 ≠ 캐시 자리 : 긴 정책을 few-shot 예시 블록으로 옮겨도 캐시되는 재사용 앞부분이 생기지 않는다 (공식 샘플 2 오답 D). 자세한 것은 ■ 프롬프트 캐싱 에 있다 [2.5①]
규칙 원문 ①②③④ (갈림길로 그린 규칙)
-
언제 : 형식·어조·구조가 들쭉날쭉하면 예시가 가장 확실한 방법 중 하나다. 예시는 추상적인 지침보다 효과적이다 [2.3①] [4.4③]
순서 : 가장 좋은 모델로 최소 프롬프트를 먼저 시험한다. 그다음 failure modes 를 보고 분명한 지시와 예시를 더한다. 자세한 것은 ■ 시스템 프롬프트 문체 · 규칙 ⑥ 에 있다
-
세 조건이 있다
- 관련 : 실제 사용 사례를 닮게 한다
- 다양 : 경계 사례를 넣는다. 의도 안 한 패턴을 따라 하지 않게 충분히 다르게 한다
- 구조 :
<example>태그로 감싼다. 여럿이면<examples>로 감싸 지시와 구분한다
3~5개가 최선이다. Claude 에게 예시의 관련성·다양성을 평가시켜도 된다. 처음 세트를 바탕으로 더 만들게 해도 된다
-
경계 사례 목록 금지 : 모든 규칙을 말하려고 경계 사례를 줄줄이(laundry list) 넣지 않는다. 기대 행동을 잘 보여 주는 서로 다르고 대표적인 예시를 고른다. 예시는 "천 마디 말보다 나은 그림" 이다
-
좋은 예 > 나쁜 예·금지 지시 : 간결함 같은 문체는 적절한 간결함을 보여 주는 좋은 예로 잡는다. 좋은 예가 나쁜 예나 "하지 마" 지시보다 효과적이다 (Sonnet 5 문서)
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 등급 | 근거 |
|---|---|---|---|
| 답의 형식·어조·구조가 매번 다르다 | 예시(few-shot)를 넣는다 | prompting-best-practices en-full · increase-consistency | |
| 예시 개수를 정한다 | 3~5개가 최선이다 | en-full | |
| 예시가 서로 비슷하다 | 경계 사례를 넣고, 충분히 다르게 한다 | en-full | |
| 예시가 지시와 섞였다 | <example> 태그로, 여럿이면 <examples> 로 감싼다 | en-full | |
| 경계 사례를 규칙으로 줄줄이 적었다 | 서로 다르고 대표적인 예시 몇 개로 바꾼다 | effective-context-engineering | |
| 처음 프롬프트를 짠다 | 최소 프롬프트로 시작한다. failure modes 를 보고 지시와 예시를 더한다 | effective-context-engineering | |
| 간결함 같은 문체를 잡고 싶다 | 좋은 예가 나쁜 예나 금지 지시보다 낫다 | prompting-claude-sonnet-5 en-full | |
| thinking 을 켠 상태에서 추론(reasoning) 방식을 보여 주고 싶다 | 예시 안에 <thinking> 태그를 넣는다 | en-full | |
| 예시를 어디서 구할지 정한다 | eval 최고 점수 입력·출력 쌍을 쓰고, 왜 좋은지 한 줄 붙인다 | (Skilljar) | Skilljar API 287746 |
| 긴 정책을 few-shot 블록으로 옮겨 비용을 줄이려 한다 | 오답이다. 캐시되는 재사용 앞부분이 생기지 않는다 | 가이드 샘플 2 해설(sample-questions-p6-7) |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 흔들리는 것 | 형식·어조·구조 | 예시 | 판단 규칙 1 | |
| 흔들리는 것 | 코드가 파싱할 JSON 모양 | 스키마를 쓴다. 자세한 것은 ■ structured outputs 에 있다 | structured-outputs | |
| 흔들리는 것 | 판단 기준(무엇을 환불로 볼지) | 지시와 이유를 쓴다. 자세한 것은 ■ 시스템 프롬프트 문체 에 있다 | 업계 일반 | 공식은 예시·지시를 "failure modes 에 따라" 더하라고만 한다(effective-context-engineering) |
| 예시 수 | 1개 | 패턴 하나는 잡힌다(one-shot). 경계 사례가 여럿이면 multi-shot 을 쓴다 | (Skilljar) | Skilljar API 287746 |
| 예시 수 | 3~5개 | 공식 최선이다 | en-full | |
| 예시 수 | 수십 개 | 공식 문장이 없다. 매 요청 토큰 비용이 든다 | 업계 일반 | 뒤집히는 때 2 |
| 예시 모양 | 전부 같은 길이·주제다 | 모델이 그 공통점을 따라 한다 | en-full | |
| 모델 | Opus 4.8 · Sonnet 5 (문자 그대로) | 예시가 보여 준 범위 밖으로는 조용히 넓히지 않는다. 그래서 범위는 지시로 정한다 | 추론 | opus-4-8 en-full · sonnet-5 en-full (예시 문맥 문장은 아님) |
| 요청 수 | 많고 예시가 고정이다 | 예시는 고정 앞부분이다. 캐싱으로 비용이 줄어든다 | 계산 | 뒤집히는 때 2 |
연습 문제
고객지원 Agent 의 티켓 요약 프롬프트에 예시 3개를 넣었는데 셋 다 환불 문의 · 셋 다 두 문장비슷한 것뿐이다. 그 뒤로 배송 문의 요약까지 두 문장에 환불 말투패턴을 따라 함로 나온다. 팀장은 "같은 모범 답을 몇 번 더 넣어 강조하자"고 한다. 예시 세트를 어떻게 고칠까?
시험 대비
함정
- "모든 예외 경우를 규칙 목록으로 길게 나열한다" 는 함정이다. 권하지 않는 방법이다. 대표 예시 몇 개를 고른다
- "같은 모범 답 하나를 여러 번 반복한다" 는 함정이다. 다양성 조건을 어겨 의도 안 한 패턴을 따라 한다 (반복 자체를 콕 집은 공식 문장은 없다. 다양성 조건에서 추론했다)
- "예시를 지시 문장 사이에 그냥 섞는다" 는 함정이다. 태그로 구분한다
- "예시는 많을수록 좋다(수십 개)" 는 함정이다. 공식은 3~5개가 최선이라고 한다. 그 이상이 나쁘다는 문장은 없다 업계 일반 컨텍스트는 한정 자원이라 늘 비용이 든다
- "정책 문서를 few-shot 블록으로 옮겨 비용·지연(latency)을 줄인다" 는 함정이다. 캐시되는 재사용 앞부분이 생기지 않는다 (공식 샘플 2 오답 D)
- "JSON 모양을 예시만으로 보장한다" 는 함정이다. 예시는 방향만 준다. 보장은 structured outputs 가 한다. 자세한 것은 ■ structured outputs 에 있다
- 목록 영상 요령 "권장 7단계 순서(명확→이유→예시→XML→역할→형식→체이닝)대로" 는 함정이다. 공식은 소개 순서일 뿐 규칙이 아니다. 가까운 원칙은 최소 프롬프트부터 시작하는 것이다 (목록 영상 요령이다. 공식 근거는 없다)
신호
"Examples are one of the most reliable ways to steer Claude's output format, tone, and structure."
"Include 3–5 examples for best results."
"Wrap examples in <example> tags (multiple examples in <examples> tags) so Claude can distinguish them from instructions."
"we recommend working to curate a set of diverse, canonical examples that effectively portray the expected behavior of the agent."
"It’s best to start by testing a minimal prompt with the best model available to see how it performs on your task"
"relocating to few-shot (D) does not create a cacheable, reusable prefix" (가이드 샘플 2)
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
1. 예시를 넣었더니 더 한쪽으로 쏠린 때
- 조건 : 티켓 요약 예시 3개가 전부 환불 건이고 전부 두 문장이다. 이후 배송 문의 요약도 두 문장에 환불 말투로 나온다.
- 판단 : 예시가 모자란 것이 아니라 다양성이 부족한 것이다. 개수를 늘리기보다 주제·길이·경계 사례가 다른 예시로 바꾼다.
- 등급 : (원리) · 사례는 새로 만든 것
- 근거 : en-full "vary enough that Claude doesn't pick up unintended patterns"
2. "예시가 비싸서 뺀다" 가 틀리는 때
- 조건 : 예시 4개 × 약 600토큰 = 2,400토큰이다. 하루 3만 요청이고 Haiku 4.5 를 쓴다 (입력 $1, 캐시 읽기 $0.10 / 백만 토큰).
- 계산 : 캐시가 없으면 2,400 × 30,000 = 7,200만 토큰/일이라 $72/일이다. 예시를 고정 앞부분에 두고 캐시가 적중하면 0.1배라 $7.20/일이다(+ 5분마다 쓰기 1.25배).
- 전제 : 아래를 가정한다. 가격은 2026-09-28 조회값이다.
- 예시가 요청마다 똑같고 바뀌는 입력 앞에 있다.
- 캐시 대상 앞부분(tools + system + 예시)이 Haiku 4.5 최소 캐시 길이 4,096토큰 이상이다. 예시 2,400 만으로는 모자라서 시스템 프롬프트·도구 정의와 합쳐 넘어야 한다.
- 호출 간격이 5분보다 짧다.
- 판단 : 예시 비용이 문제면 빼기 전에 앞부분을 고정하고 캐싱한다. 단 "정책을 예시 블록으로 옮기면 캐시된다" 는 반대로 오답이다(샘플 2 D). 캐싱은 위치가 아니라 요청마다 똑같은 앞부분에서 생긴다.
- 등급 : 계산 (배수·가격·최소 길이는 확인)
- 근거 : ko-pricing-2026-09-28 · ko-prompt-caching(Haiku 4.5 최소 4,096) ■ 프롬프트 캐싱 · 규칙 ①② sample-questions-p6-7
3. 예시로 안 되는 때 (모양 보장)
- 조건 : 예시 5개로 JSON 모양을 보여 줬는데 하루 몇 건씩 파싱이 실패한다. 뒤쪽 시스템은 재시도를 못 한다.
- 판단 : 예시는 방향만 준다. 보장은 structured outputs(제약 디코딩)가 한다. 자세한 것은 ■ structured outputs 에 있다. 예시는 필드 값의 문체와 기준을 잡는 데 계속 쓴다.
- 근거 : structured-outputs
4. 예시보다 지시가 먼저인 때
- 조건 : 첫 프롬프트라 failure modes 를 아직 모른다.
- 판단 : 가장 좋은 모델로 최소 프롬프트부터 시작한다. 실패가 형식·어조면 예시를 넣고, 그 밖이면 지시를 넣는다. 처음부터 예시를 쌓는 것은 순서가 거꾸로다.
- 근거 : effective-context-engineering
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "모든 예외 경우를 규칙 목록으로 길게 나열" | 빈틈없어 보인다 | 권하지 않는 방법이다. 서로 다르고 대표적인 예시 몇 개를 쓴다 | effective-context-engineering | |
| "같은 모범 답 하나를 여러 번 반복" | 강조하면 더 따를 것 같다 | 다양성 조건을 어긴다. 모델이 우연한 공통점까지 따라 한다 | 추론 | en-full(반복 자체를 콕 집은 문장은 없다) |
| "예시를 지시 문장 사이에 섞어 둠" | 따로 둘 이유를 못 느낀다 | 태그로 구분해야 지시와 헷갈리지 않는다 | en-full | |
| "예시는 많을수록 좋다(수십 개)" | 많이 보여 주면 더 정확할 것 같다 | 공식 최선은 3~5개다. 더 많을 때의 손익 문장은 없다 | 업계 일반 | en-full |
| "나쁜 예를 잔뜩 보여 주고 '이렇게 하지 마'" | 피할 것이 분명해 보인다 | 좋은 예가 나쁜 예나 금지 지시보다 효과적이다 | sonnet-5 en-full | |
| "정책을 few-shot 블록으로 옮겨 비용 절감" | 위치를 바꾸면 효과가 있을 듯하다 | 캐시되는 재사용 앞부분이 생기지 않는다 | 가이드 샘플 2 해설 | |
| "예시만으로 JSON 모양 보장" | 예시가 형식을 잘 잡으니까 | 예시는 방향일 뿐이다. 보장은 structured outputs 가 한다 | structured-outputs | |
| "권장 7단계 순서대로 기법을 쌓는다" | 순서가 있으면 안심이 된다 | 공식은 소개 순서일 뿐이다. failure modes 에 따라 더한다 | effective-context-engineering (목록 영상 요령) |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 2.3 공식 시험 가이드 v1.0
- 샘플 2 (official sample-questions-p6-7)
- prompting-best-practices
- effective-context-engineering
- increase-consistency
- prompting-claude-sonnet-5
- Skilljar API 287746
상태
- 업계 일반 1줄
- 추론 1줄
미해결
- 예시 수 상한은 모른다. 3~5개가 "최선" 이라는 문장만 있다. 그 이상일 때 품질이 떨어지는지는 공식 문장이 없다.
- 문자 그대로 따르는 모델(Opus 4.8·Sonnet 5)에서 예시가 일반화되는 폭은 모른다. 모델 문서는 "지시" 의 범위만 말한다. 예시 문맥 문장은 없다(상황 변수의 해당 줄은 추론이다).
- 목록 영어 신호 3개는 원문에서 모두 찾았다. 단 마지막 문장의 원문 따옴표는 곧은
'가 아니라’다(effective-context-engineering).- "Include 3–5 examples for best results."
- "we recommend working to curate a set of diverse, canonical examples…"
- "It's best to start by testing a minimal prompt…"