■ per-request cost
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 1.6 비즈니스 가치 축 맞추기 · D1 설계 17%Align solutions to business value pillars (efficiency, transformation, productivity, cost, performance SLAs)
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 1.6③ 한 건에 얼마, 한 달에 얼마? — 비용 축을 숫자로 — 요청당 비용으로 설계안 비교
- 4.5② 보기마다 다른 최적화 — 이 시나리오의 레버는 무엇 하나? — 시나리오 단서 → 레버 하나 (캐싱 · 배치 · 라우팅/effort · 스트리밍)
- 2.1① 정확도가 비용보다 중요한 복잡 추론 작업, 어느 모델로 시작하나? — 출발 모델 고르기 (효율 우선 = Haiku 4.5 에서 올림 / 능력 우선 = Opus 5.5 에서 낮춤)
한눈에
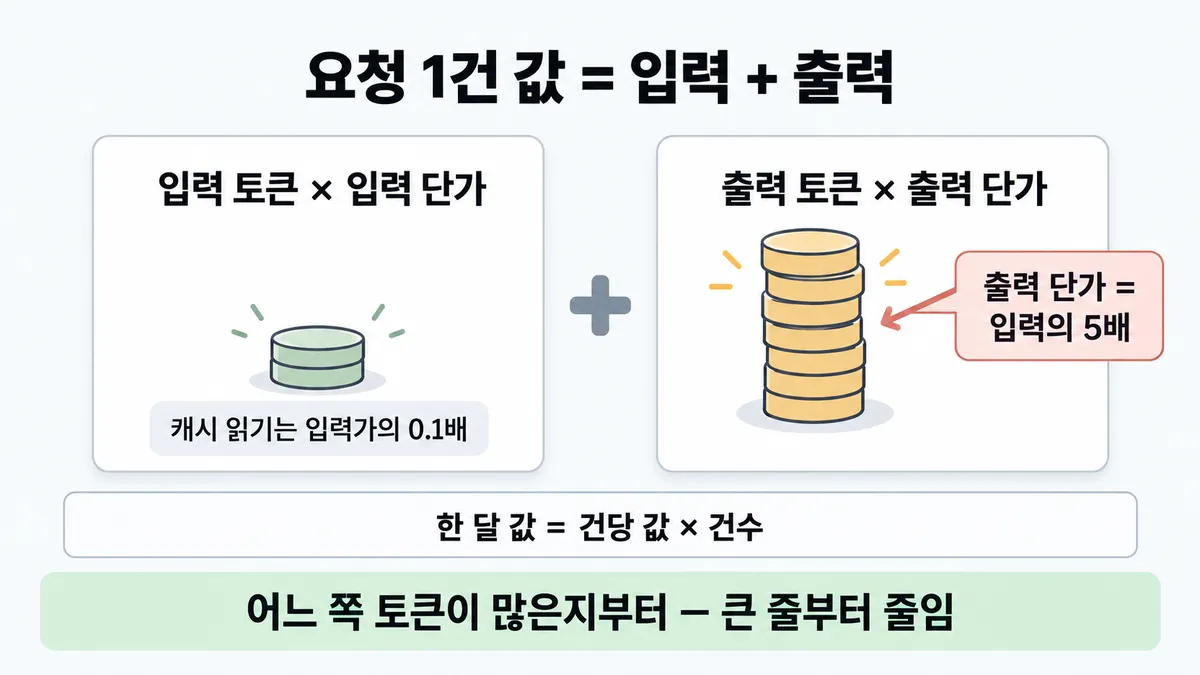
요청 1건 값은 입력 토큰 × 입력 단가 + 출력 토큰 × 출력 단가 다. 캐시 쓰기와 읽기는 입력 단가의 배수로 붙는다. 한 달 값은 건당 값 × 건수 다. 그래서 설계안은 건당 값으로 비교한다
출력 단가는 입력 단가의 5배다 (현행 모델 전부). 그래서 어느 쪽 토큰이 많은지부터 본다
비유 클라우드 요금과 같다. 들어오는 트래픽은 싸고 나가는 트래픽(egress)은 비싸다. 그래서 청구서의 큰 항목부터 줄인다
ELI5
택배 요금이랑 비슷해요.
- 보내는 상자(입력)보다 받는 상자(출력)가 다섯 배 비싸요.
- 매번 똑같이 넣는 포장재는 창고에 맡기면 10분의 1 값이에요.
- 급하지 않으면 느린 배송으로 반값이에요.
- 그러니 영수증에서 제일 큰 줄부터 줄여요.
개념 설명
원리
값의 뼈대
- 요청 1건 값은 입력 토큰 × 입력 단가 + 출력 토큰 × 출력 단가 다. 한 달 값은 건당 값 × 건수 다.
- 출력 단가는 입력 단가의 5배다 (Haiku 4.5 $1/$5 · Sonnet 5 $2/$10 · Opus 5.5 $4/$20 · Opus 5 $5/$25, 백만 토큰당).
- 그래서 "입력이 많은 일"과 "출력이 많은 일"은 줄이는 수단이 다르다.
수단별로 깎이는 곳
- 캐싱은 입력 단가에만 거는 배수다. 쓰기는 1.25배(5분)나 2배(1시간)이고, 읽기는 0.1배다. 출력은 그대로다.
- 배치는 입력과 출력 모두 50% 할인된다. 대신 끝나는 시각을 약속하지 않는다. 캐싱 할인과 함께 적용된다.
- 모델을 바꾸면 단가 자체가 바뀐다. Opus 5.5 에서 Haiku 4.5 로 바꾸면 입력과 출력 모두 4분의 1 이 된다. 대신 품질이 흔들릴 수 있어 eval 로 확인한다.
- effort 는 한 모델 안에서 출력 토큰(thinking(사고)·도구 호출·답)을 줄인다.
곱해지는 것 · 숨은 것
- 새 토크나이저는 같은 글을 약 30% 더 많은 토큰으로 센다. 그래서 단가표가 같아도 청구가 늘 수 있다.
- 미국 전용 추론은 1.1배다. fast mode 는 Opus 5.5 에서 2배 단가($8/$40)다.
- 도구 정의, 도구 시스템 프롬프트,
tool_result, 웹 검색 결과는 전부 입력 토큰이다. 웹 검색은 1,000회당 $10 이 따로 붙는다. - 1M 창은 전 구간이 같은 단가다. 그래서 긴 요청이라고 할증이 붙는 일은 없다(4.6 이후).
공식 줄이는 순서
- 순서는 맞는 모델, 캐싱, 배치(급하지 않은 일), 사용 패턴 감시다.
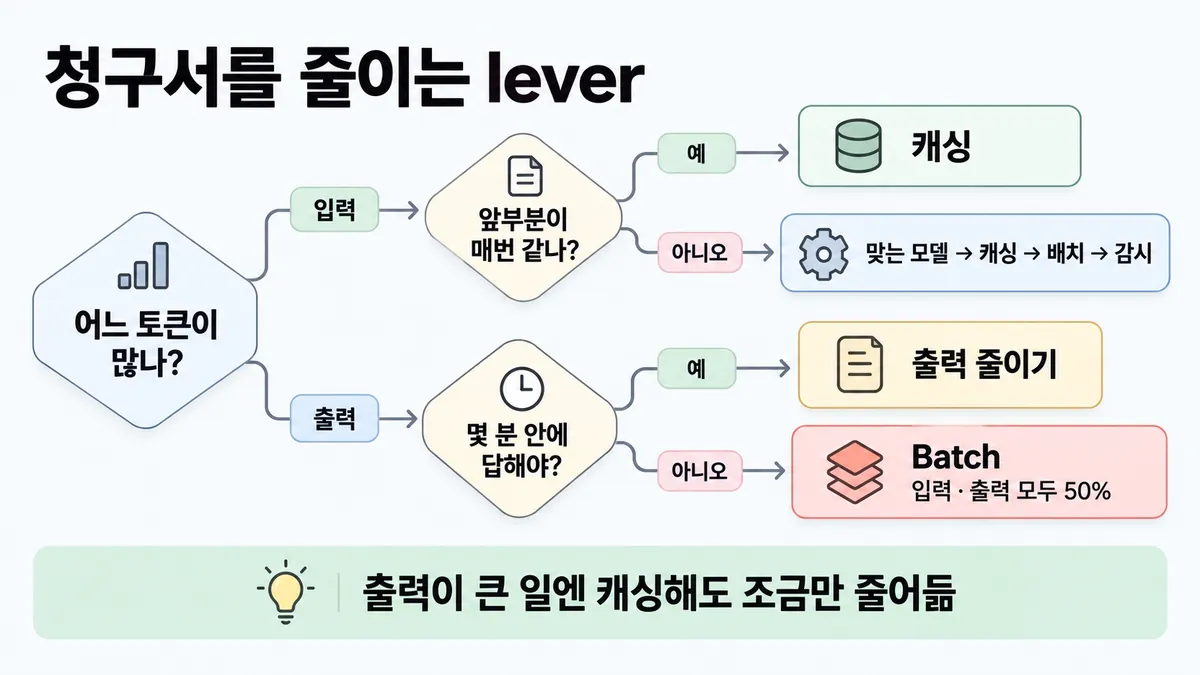
- 이 순서는 목록일 뿐이고 지문 조건이 먼저다. 먼저 볼 조건은 둘이다. 청구서의 큰 항목이 입력인가, 출력인가? 몇 분 안에 답해야 하는가?
규칙과 판단
갈림길
①② 청구서의 큰 항목 [1.6③]
캐싱한다
입력 대부분이 0.1배 값이 된다. 5분 캐시는 읽기 1번부터 이득이다. 자세한 것은 ■ 프롬프트 캐싱 에 있다
다음 물음 — 모델이 과제에 맞나?
출력을 줄이고 모델을 본다
"짧게 답해" 와 max_tokens 로 출력을 줄인다. 자세한 것은 ■ 지연 줄이기 lever 에 있다. 맞는 모델로는 eval 로 품질을 확인한 뒤 바꾼다
Batch 로 보낸다
입력과 출력 모두 50% 할인된다. 자세한 것은 ◆ Batch API vs 동기 호출 에 있다
③ 줄이는 순서 [1.6③] [4.5②]
맞는 모델로 바꾼다
간단한 일은 Haiku, 대부분의 프로덕션은 Sonnet, 가장 복잡한 추론은 Opus 다. eval 로 품질을 확인한 뒤 낮춘다. 과제를 무시하고 제일 작은 모델을 고르면 오답이다 (샘플 2 B)
캐싱과 배치를 함께 쓴다
캐싱은 반복되는 컨텍스트 비용을 줄인다. 배치는 입력과 출력 모두 50% 할인된다. 두 할인은 함께 적용된다
캐싱하고 출력을 줄인다
캐싱으로 반복되는 컨텍스트 비용을 줄인다. 출력이 대부분이고 몇 분 안에 답해야 하면 "짧게 답해" 와 max_tokens 로 출력을 줄인다. 자세한 것은 ■ 지연 줄이기 lever 에 있다
배치로 보낸다
급하지 않은 작업은 Batch API 로 보낸다. 입력과 출력 모두 50% 할인된다
출력을 줄인다
출력이 대부분이고 몇 분 안에 답해야 하면 "짧게 답해" 와 max_tokens 로 출력을 줄인다. 자세한 것은 ■ 지연 줄이기 lever 에 있다
④⑤ 숨은 값 [1.6③] [2.1①]
토큰 수도 비교한다
새 토크나이저는 같은 글에 약 30% 더 많은 토큰을 쓴다. 단가만 비교하면 토큰 수가 약 30% 느는 것을 놓친다
숨은 입력을 더한다
tools 정의, 도구 시스템 프롬프트, tool_use·tool_result 블록, 웹 검색 결과는 전부 입력 토큰이다
모든 토큰 1.1배 · 비싼 요금
inference_geo: "us" 는 모든 토큰에 1.1배가 붙는다. fast mode 는 비싼 요금이다 (Opus 5.5 $8/$40). fast mode 는 배치와 같이 쓰지 못한다
세션 시간당 $0.08 이 붙는다
토큰 값에 세션 시간당 $0.08 이 더 붙는다. 배치 모드는 없다
표 단가 그대로다
1M 창 전체가 표준 단가다
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 요청 → 캐시 → 모델 → 청구서
블록 : 고정 앞부분, 바뀌는 입력 (바뀌는 것)
규칙 (청구서) : 입력 토큰 × 입력 단가 + 출력 토큰 × 출력 단가 (출력 = 입력의 5배)
질문 : 청구서의 큰 항목은 입력일까, 출력일까?
① 긴 고정 앞부분 → 캐싱 ✓
- 시작 : 요청 — 쪽지 : Haiku 4.5 / 고정 앞부분 6,000 / 질문 200 · 답 300
- 요청 1 : 고정 앞부분 → 캐시 : 쓰기는 1.25배다 — 쪽지 : 캐시 쓰기 / 6,000 × 1.25배
- 요청 2 : 캐시 : 읽기는 0.1배다 — 쪽지 : 캐시 읽기 / 6,000 × $0.10/M
- 입력 : 바뀌는 입력 → 모델 : 입력 단가 그대로다 — 쪽지 : 질문 200 × $1/M
- 청구 : 모델 → 청구서 : 출력은 입력의 5배다 — 쪽지 : 출력 300 × $5/M / 건당 $0.0077 → $0.0023
- 끝 : 입력 대부분이 0.1배 값이 된다. 건당 값이 약 70% 줄어든다 (계산)
② 짧은 입력 · 긴 출력 → 캐싱 ≠
- 시작 : 요청 — 쪽지 : Sonnet 5 / 고정 지침 2,500 / 리뷰 500 · 보고서 5,000
- 캐싱 : 고정 앞부분 → 캐시 : 할인은 입력 단가에만 붙는 배수다 (출력은 그대로다) — 쪽지 : 캐시 읽기 / 2,500 × $0.20/M
- 입력 : 바뀌는 입력 → 모델 : 입력은 짧다 — 쪽지 : 리뷰 500 × $2/M
- 청구 : 모델 → 청구서 : 출력이 청구서의 대부분이다 — 쪽지 : 출력 5,000 × $10/M = $0.05 / 건당 $0.056 → $0.0515
- 끝 : 캐싱해도 총비용은 조금만 줄어든다. 약 8% 다 (계산)
③ 급하지 않은 대량 → 배치 ✓
- 시작 : 요청 — 쪽지 : 밤새 보고서 1,000건 / 아침까지만 되면 됨
- 입력 : 요청 → 모델 : Batch API 로 보낸다 — 쪽지 : 배치 1개 = 요청 1,000개 / 결과는 나중에 한꺼번에
- 청구 : 모델 → 청구서 : 입력과 출력 모두 50% 할인된다 — 쪽지 : 건당 $0.056 → $0.028
- 끝 : 급하지 않은 작업은 Batch API 로 보낸다. 캐싱 할인도 함께 받을 수 있다
나머지 규칙
-
예산 차원 (Price) : API 호출당 비용, 모델 크기, 사용 빈도를 본다. 예산은 성공 기준(success criteria)의 한 차원이다. 자세한 것은 ■ impact metrics 에 있다
규칙 원문 ①②③④⑤ (갈림길로 그린 규칙)
-
식 : 건당 값은 아래 네 항목의 합이다 [1.6③]
- 캐시 안 된 입력 × 입력 단가
- 캐시 쓰기 × 1.25배(5분) 또는 2배(1시간)
- 캐시 읽기 × 0.1배
- 출력 × 출력 단가
공식 계산 예는 Opus 5 와 Managed Agents 1시간 세션이다. 입력 5만 $0.25 + 출력 1.5만 $0.375 + 런타임 $0.08 = $0.705 다. 입력 중 4만을 캐시 읽기로 바꾸면 $0.525 다
이 예에서 출력 토큰 수는 입력의 3분의 1 이다. 그런데 값은 출력이 더 크다 ($0.375 > $0.25). 이것이 출력 단가 5배의 뜻이다 계산
-
단가는 아래 표와 같다 (백만 토큰당, 2026-09-28 조회) [1.6③]
모델 입력 출력 캐시 읽기 Haiku 4.5 $1 $5 $0.10 Sonnet 5 $2 $10 $0.20 Opus 5 · 4.8 · 4.7 $5 $25 $0.50 Opus 5.5 $4 $20 $0.20 Fable 5.1 $10 $50 $0.25 시험 뒤 변경 Sonnet 5 $2/$10 정가는 2026-08-10 에 확정됐다(예정됐던 $3/$15 인상은 취소됐다. Fable 5.1 캐시 읽기 0.025배는 2026-09-01 에 바뀌었다. Opus 5.5 $4/$20·읽기 0.05배는 2026-09-22 에 바뀌었다. 시험은 배수(출력 5배 · 읽기 0.1배)와 역할(빠르고 싼 ↔ 능력 높은)로 물을 가능성이 있다)
-
줄이는 공식 순서는 맞는 모델, 캐싱, 배치(급하지 않은 작업), 사용 패턴 감시다 [1.6③] [4.5②]
- 맞는 모델 : 간단한 일은 Haiku, 대부분의 프로덕션은 Sonnet, 가장 복잡한 추론(reasoning)은 Opus 다
- 모델을 낮출 때는 eval 로 품질을 확인한 뒤 낮춘다
- 한 모델 안에서는 effort 로 지능과 비용을 맞바꾼다. 자세한 것은 ■ 지연 줄이기 lever 에 있다
- 과제를 무시하고 제일 작은 모델을 고르면 오답이다 (샘플 2 B)
- 캐싱 : 반복되는 컨텍스트 비용을 줄인다. 긴 고정 앞부분을 캐싱하면 입력 대부분이 0.1배 값이 된다. 5분 캐시는 읽기 1번부터 이득이다. 규칙 본문은 ■ 프롬프트 캐싱 에 있다
- 배치 : 입력과 출력 모두 50% 할인된다. 캐싱 할인과 함께 적용된다. 규칙 본문은 ◆ Batch API vs 동기 호출 에 있다
- 출력이 대부분이고 몇 분 안에 답해야 하면 "짧게 답해" 와
max_tokens로 출력을 줄인다. 자세한 것은 ■ 지연 줄이기 lever 에 있다 - 감시 : 토큰 소비를 추적해 최적화 기회를 찾는다. 응답
usage에input_tokens·output_tokens·cache_read_input_tokens·cache_creation_input_tokens가 있다
-
숨은 입력 : 아래는 모두 입력 토큰이다 [1.6③]
tools정의(이름·설명·스키마)tool_use·tool_result블록- 도구 시스템 프롬프트. 도구가 있으면 자동으로 붙는다(모델별 수백 토큰, 예 Sonnet 5 354)
- 웹 검색 결과. 결과는 이후 턴까지 입력 토큰이 된다. 웹 검색 자체는 1,000회당 $10 이다
-
곱해지는 것 [1.6③] [2.1①]
- 새 토크나이저(Claude 4.7 이후·Sonnet 5)는 같은 글에 약 30% 더 많은 토큰을 쓴다 (내용에 따라 다르다)
- 미국 전용 추론
inference_geo: "us"는 모든 토큰에 1.1배가 붙는다 (4.6 이후 모델) - fast mode 는 비싼 요금이다 (Opus 5.5 $8/$40). 배치와 같이 쓰지 못한다
- 1M 창 전체가 표준 단가다. 900k 요청도 9k 요청과 같은 토큰당 요율이다
- Managed Agents 는 토큰 값에 세션 시간당 $0.08 이 더 붙는다. 배치 모드는 없다
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
| 매번 같은 긴 앞부분에 짧게 바뀌는 질문이 붙는다. 지연(latency)과 비용이 둘 다 문제다 | 고정 앞부분을 앞에 두고 캐싱한다 | 가이드 샘플 2 정답 C "reducing both time-to-first-token and per-request cost without discarding required context" |
| 비용을 줄이는 첫 수로 "과제를 무시하고 가장 작은 모델"을 고른다 | 오답이다 | 가이드 샘플 2 해설 "downsizing blindly (B) risks quality" |
| 모델을 고른다 | 간단한 일은 Haiku, 대부분의 프로덕션은 Sonnet, 가장 복잡한 추론(reasoning)은 Opus 다 | pricing |
| 급하지 않은 대량 작업이다 | Batch 로 보낸다 (입력·출력 50%) | pricing |
| 캐싱과 배치를 같이 쓴다 | 두 할인이 함께 적용된다 | pricing "Batch API and prompt caching discounts can be combined." |
| 옛 모델에서 새 토크나이저 모델로 옮긴다 | 단가뿐 아니라 같은 글의 토큰 수까지 비교한다 | pricing "approximately 30% more tokens for the same text" |
| 도구와 웹 검색을 쓰는 에이전트다 | 도구 정의, 도구 시스템 프롬프트, 결과를 입력에 더한다. 검색은 1,000회당 $10 이다 | pricing |
| 예산 기준을 성공 기준(success criteria)에 넣는다 | API 호출당 비용, 모델 크기, 사용 빈도를 본다 | define-success en-full |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 토큰 비중 | 입력(고정 앞부분)이 대부분이다 | 캐싱 효과가 가장 크다 | 계산 | 뒤집히는 때 1 |
| 토큰 비중 | 출력이 대부분이다 | 캐싱 효과가 작다. 배치, 출력 줄이기, 모델 바꾸기를 본다 | 계산 | 뒤집히는 때 2 |
| 마감 | 몇 분 안이다. 사람이 기다린다 | 동기 호출을 쓴다 (배치 불가) | ◆ Batch API vs 동기 호출 | |
| 마감 | 없다 | 배치로 50% 아낀다 | pricing | |
| 호출 간격 | 5분보다 길다 | 5분 캐시는 매번 만료돼 쓰기 요금을 다시 낸다. 1시간 캐시를 검토한다 | ■ 프롬프트 캐싱 · 규칙 ③ | |
| 품질 여유 | eval 에서 여유가 크다 | 작은 모델로 내려 단가 자체를 낮춘다 | pricing · 샘플 2 B(무작정은 오답) | |
| 모델 세대 | 옛 토크나이저에서 새 토크나이저로 옮긴다 | 단가 인하 폭보다 덜 싸다 | 계산 | 뒤집히는 때 4 |
| 배포 방식 | Managed Agents 다 | 세션 시간당 $0.08 이 더 붙는다. 배치는 없다 | pricing | |
| 데이터 위치 | 미국 전용 추론이다 | 모든 토큰이 1.1배다 | pricing |
연습 문제
쇼핑몰이 매일 밤 Sonnet 5 로 상품 리뷰 보고서를 만든다. 요청마다 고정 지침 2,500 토큰과 리뷰 500 토큰을 넣는다. 보고서는 5,000 토큰씩 나온다출력이 큼. 결과는 다음 날 아침에만 보면 된다급하지 않음. 팀은 "고정 지침이 있으니 캐싱부터"라고 한다. 청구서를 가장 크게 줄이는 lever(조절 수단)는 무엇인가?
시험 대비
함정
- "과제와 상관없이 제일 작은 모델로 바꾼다" 는 함정이다. 품질 위험이 있다 (샘플 2 B)
- "정책을 잘라 입력을 줄인다" 는 함정이다. 필요한 정책을 잃는다 (샘플 2 A)
- 긴 출력 일에 캐싱만 하는 것은 함정이다. 할인은 입력 단가에만 붙는 배수다. 그래서 출력 토큰이 청구서 대부분이면 캐싱해도 총비용이 조금만 줄어든다
- "몇 분 안에 답해야 하는데 배치로 50% 아낀다" 는 함정이다. 배치에는 분 단위 약속이 없다. 자세한 것은 ◆ Batch API vs 동기 호출 에 있다
- 새 모델로 옮기며 단가만 비교하는 것은 함정이다. 토큰 수가 약 30% 느는 것을 놓친다. 예를 들어 Sonnet 4.6 $3/$15 에서 Sonnet 5 $2/$10 으로 옮기면 단가는 33% 싸다. 그러나 토큰이 1.3배면 약 13% 만 싸다 계산
- 도구 정의와 검색 결과를 빼고 입력을 세는 것은 함정이다. 그것들도 전부 입력 토큰이다
- "200k 넘는 긴 요청은 할증이다" 는 함정이다. 4.6 이후는 1M 창 전체가 표준 단가다 (옛 규칙 : 2026-02-05 릴리스 노트에는 200k 초과 할증이 있었다)
- "Managed Agents 세션도 배치로 50% 아낀다" 는 함정이다. 배치 모드는 없다
신호
"reducing both time-to-first-token and per-request cost without discarding required context" (가이드 샘플 2)
"downsizing blindly (B) risks quality" (가이드 샘플 2)
"Choose Haiku for simple tasks, Sonnet for most production workloads, and Opus for the most complex reasoning"
"Use the Batch API for non-time-sensitive tasks"
"This tokenizer produces approximately 30% more tokens for the same text."
"Batch API and prompt caching discounts can be combined."
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
1. 입력이 대부분인 일 — 캐싱이 제일 큼
- 조건 : 고정 앞부분은 6천 토큰, 질문은 200 토큰, 답은 300 토큰이다. 모델은 Haiku 4.5 이고 월 30만 건이다.
- 계산 : 캐싱이 없으면 6,200 × $1 + 300 × $5 (백만 토큰당) = 건당 $0.0077 이다. 월로는 $2,310 이다. 캐시가 적중하면 6,000 × $0.10 + 200 × $1 + 300 × $5 = 건당 $0.0023 이다. 월로는 $690 이다. 약 70% 절감이다.
- 그다음 : 캐싱 뒤에는 출력이 건당 값의 약 65% 다. 그래서 다음 lever(조절 수단)는 출력 쪽(길이·effort)이다.
- 전제 : 아래를 가정한다.
- 월 30만 건이 고르게 와서(분당 약 7건) 5분 안에 늘 다음 호출이 있다.
- 캐시 쓰기는 무시할 만큼 드물다.
- 가격은 2026-09-28 조회값이다.
- 등급 : 계산 (배수·단가는 확인)
- 근거 : prompt-caching 표 · pricing
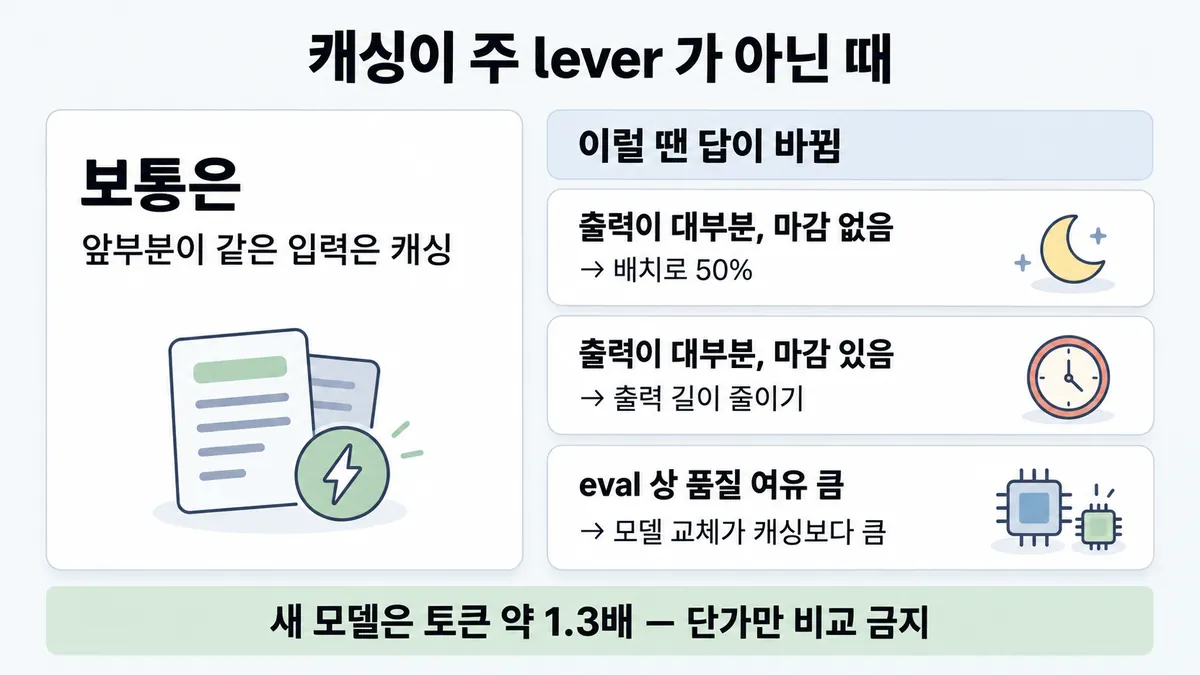
2. 출력이 대부분인 일 — 캐싱은 거의 안 먹힘
- 조건 : 보고서를 만든다. 입력은 3천(그중 고정 2,500), 출력은 5천이다. 모델은 Sonnet 5 다.
- 계산 : 캐싱이 없으면 3,000 × $2 + 5,000 × $10 = 건당 $0.056 이다. 캐싱하면 2,500 × $0.20 + 500 × $2 + 5,000 × $10 = $0.0515 다. 약 8% 절감이다. 배치는 $0.028 이라 50% 절감이다. 출력을 2,500 으로 줄이면 $0.031 이라 약 45% 절감이다.
- 판단 : 마감이 없으면 배치를 쓴다. 마감이 있으면 출력 길이와 모델 쪽을 본다. "캐싱부터"가 순서상 앞이라도 이 일에서는 효과가 작다.
- 등급 : 계산
- 근거 : prompt-caching 표 · pricing
3. 모델 교체가 캐싱보다 큰 때
- 조건 : 같은 보고서(입력 3천, 출력 5천)를 Opus 5.5 로 돌린다. eval 에서 품질 여유가 크다.
- 계산 : Opus 5.5 는 (3,000 × $4 + 5,000 × $20) × 1.3 = 건당 약 $0.146 이다. Haiku 4.5 는 3,000 × $1 + 5,000 × $5 = $0.028 이다. 약 5.2배 차이다. 캐싱은 입력 쪽만 줄여서 이만큼은 못 줄인다.
- 전제 : 같은 글이 Opus 5.5(새 토크나이저)에서 1.3배 토큰이라고 본다. Haiku 4.5 는 옛 토크나이저로 본다. pricing이 "Claude 4.7 이후"만 새 토크나이저라고 해서 그렇게 본 것이다(추론).
- 판단 : 이것이 공식 순서 1번이 "맞는 모델"인 이유다. 단 eval 로 품질을 확인한 경우에만 그렇다. 무작정 낮추면 샘플 2 B 오답이다.
- 등급 : 계산 · 조건부(eval 전제)
- 근거 : prompt-caching 표 · pricing · 가이드 샘플 2 해설
4. 새 모델이 단가만큼 안 싼 때
- 조건 : Sonnet 4.6($3/$15)에서 Sonnet 5($2/$10)로 옮긴다.
- 계산 : 단가는 × 2/3 이고, 같은 글의 토큰은 × 약 1.3 이다. 그래서 청구는 × 약 0.87 이다. 33% 가 아니라 약 13% 절감이다.
- 등급 : 계산. 30% 는 "approximately" 이고 내용에 따라 다르다. 실제 값은 token counting API 로 잰다.
- 근거 : 릴리스 노트 · prompt-caching 표
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "과제와 상관없이 가장 작은 모델로" | 단가가 제일 싸다 | 품질 위험이 있다. eval 없이 낮추면 오답이다 | 가이드 샘플 2 B | |
| "정책 문서를 앞 1,000 토큰만 남기고 자름" | 입력이 바로 줄어 보인다 | 필요한 정책을 잃는다 | 가이드 샘플 2 A | |
| "정책을 few-shot 예시 블록으로 옮김" | 구조를 바꾸면 나아 보인다 | 캐시할 수 있는 재사용 앞부분을 만들지 않는다 | 가이드 샘플 2 D | |
| "캐싱하면 출력도 싸짐" | "캐싱 = 비용 절감"으로 외웠다 | 캐싱 배수는 기본 입력 단가 기준이다. 출력은 그대로다 | pricing | |
| "몇 분 안에 답해야 하는데 배치로 50%" | 50% 가 크다 | 배치에는 분 단위 약속이 없다 | ◆ Batch API vs 동기 호출 | |
| "새 모델 단가가 33% 싸니 청구도 33% 준다" | 단가표만 봤다 | 새 토크나이저는 같은 글에 약 30% 더 많은 토큰을 쓴다 | 계산 | 뒤집히는 때 4 |
| "200k 넘는 요청은 할증이라 잘라야" | 옛 자료(2026-02 까지 200k 초과 할증)를 봤다 | 4.6 이후는 1M 창 전 구간이 표준 단가다 | pricing · 릴리스 노트 | |
| "Managed Agents 세션을 배치로 돌려 50%" | 두 할인을 섞었다 | 세션은 상태를 유지하는 대화형이라 배치 모드가 없다 | pricing | |
| "스트리밍을 켜면 비용이 준다" | 빨라 보이면 싸 보인다 | 스트리밍은 체감용이고 토큰 값과 무관하다 | 업계 일반 | ◆ Batch API vs 동기 호출 함정 |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 1.6 공식 시험 가이드 v1.0
- 샘플 2 공식 시험 가이드 v1.0
- pricing
- prompt-caching (모델 단가표)
- 릴리스 노트
- define-success
상태
- 계산 2줄(① 출력 비중 · 함정 토크나이저 예)
- 시험 뒤 변경 1곳(② 최신 단가)
미해결
- pricing 모델 단가표는 defuddle 판에서 칸이 밀렸다. 그래서 Sonnet 5 입력·출력 칸이 비어 있다. 단가는 같은 표인 prompt-caching과 릴리스 노트로 대조했다.
- 시험 시점의 단가는 모른다. 가이드가 어느 모델 가격을 전제했는지 모르기 때문이다. 시험은 배수(출력 5배·읽기 0.1배·배치 50%)와 역할(빠르고 싼 ↔ 능력 높은)로 물을 가능성이 있다 (추론).
- 공식 "줄이는 순서"는 번호 목록 4줄뿐이다. 우선순위인지 나열인지 말하는 공식 문장은 없다. 뒤집히는 때 2·3 처럼 지문 조건이 순서를 바꿀 수 있다 (계산).
- 목록 1.6③ 의 "가격 숫자는 바뀌니 역할로 판단한다"는 공식 문장에 없다 (업계 일반).
- Haiku 4.5 가 옛 토크나이저인지는 공식 명시가 없다. "Claude 4.7 이후 = 새 토크나이저"에서 미룬 것이다 (뒤집히는 때 3 전제).