■ 에이전트 상태·실패·배포
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 1.4 멀티 에이전트와 조율 · D1 설계 17%Design multi-agent systems and orchestration strategies
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 1.4③ subagent 하나가 멈추면 전체는? — 상태·실패 전파·배포를 어떻게 다루나
- 2.4② 긴 에이전트 작업에서 창이 차오른다 — 무엇을 남기고 무엇을 밖으로 빼나? — 컨텍스트 관리 수단 (사전 로드 vs 그때 가져오기 · 컴팩션 · 구조화 메모 · 서브에이전트 요약)
한눈에
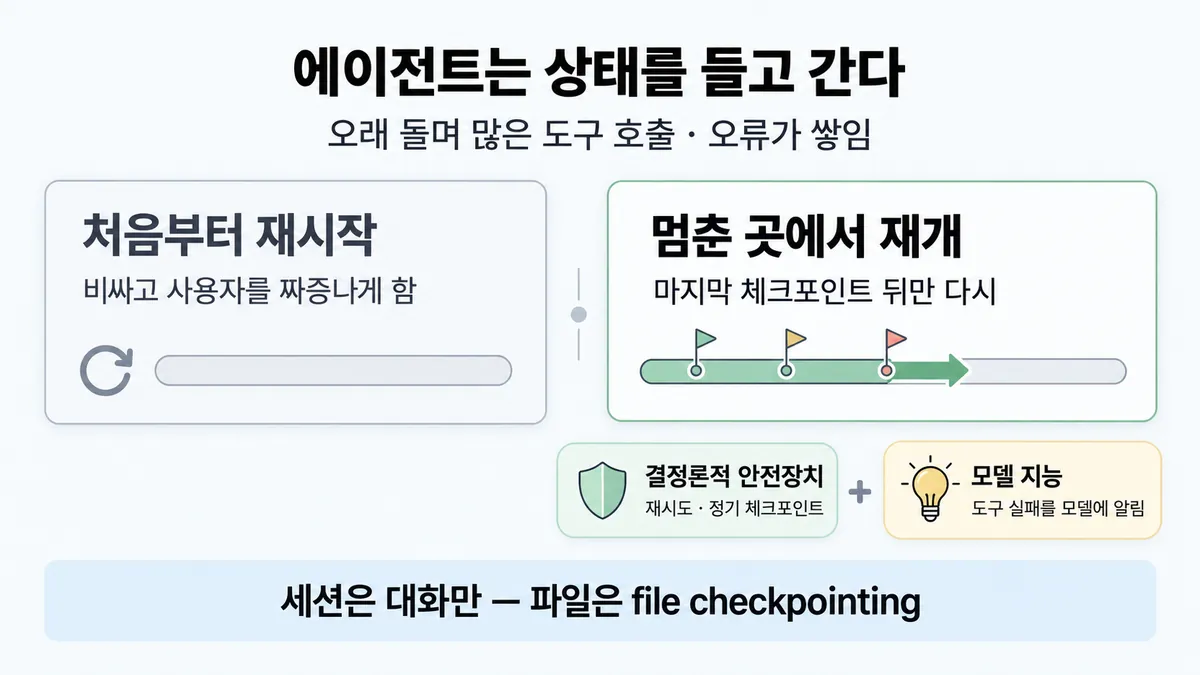
에이전트는 오래 돌며 많은 도구 호출에 걸쳐 상태를 들고 간다. 그래서 작은 실패도 치명적이고 오류가 쌓인다. 따라서 실패·실행 방식·배포를 상태 있는 시스템으로 다룬다
작은 변경도 큰 행동 변화로 번진다. 그래서 시제품과 프로덕션의 거리가 생각보다 멀다
비유 Step Functions 의 재시도·체크포인트와 같다. 옛 버전과 새 버전을 함께 두고 트래픽을 옮기는 배포와도 같다. "파드 재시작이면 복구 끝" 은 상태 있는 작업의 진행분을 날린다
ELI5
긴 퍼즐을 맞추다가 잠깐 넘어졌을 때를 생각해 봐요.
- 다 쏟고 처음부터 다시 하면 너무 아까워요.
- 그래서 중간중간 사진을 찍어 두고, 거기서 다시 시작해요.
- 친구 모두가 한 명을 기다리면, 그 친구가 늦을 때 다 같이 멈춰요.
- 퍼즐 판을 바꿀 땐, 맞추던 친구 것은 그대로 두고 새 친구부터 새 판을 줘요.
개념 설명
원리
왜 상태가 문제인가
- 에이전트는 수십~수백 번 도구를 부르며 상태를 쌓는다. 한 걸음이 틀리면 뒤 경로가 통째로 달라진다. 그래서 오류가 쌓인다.
- 처음부터 다시 하면 쌓은 진행분을 버린다. 비용·시간도 다시 낸다. 그래서 "멈춘 곳에서 재개" 한다.
두 겹의 안전장치
- 결정론적 쪽 : 재시도(SDK 기본 2번, 지수 백오프), 정기 체크포인트, 세션 저장(resume)이다.
- 모델 쪽 : 도구가 실패했다고 알려 주면 모델이 다른 길을 찾는다. 오류 메시지는 고칠 점이 보이게 쓴다.
- 재시도로 안 풀리는 실패가 있다(월 지출 한도 429). 그래서 종류를 가려야 한다.
동기 vs 비동기
- 동기 : 묶음 단위로 기다린다. 그래서 조율이 단순하다. 대신 가장 느린 subagent 가 전체 속도를 정한다. 도중에 방향을 못 바꾼다.
- 비동기 : 끝나는 대로 다음으로 간다. 그래서 병렬성이 오른다. 대신 할 일이 생긴다. 결과를 맞추고, 상태를 일관되게 두고, 오류가 번지지 않게 해야 한다.
배포
- 돌고 있는 에이전트는 "어느 버전의 프롬프트·도구" 를 전제로 계획을 세워 둔다. 중간에 버전이 바뀌면 깨진다.
- 구버전·신버전을 함께 두고 새 트래픽만 새 버전으로 보낸다. 그러면 도는 것은 구버전에서 끝난다.
규칙과 판단
갈림길
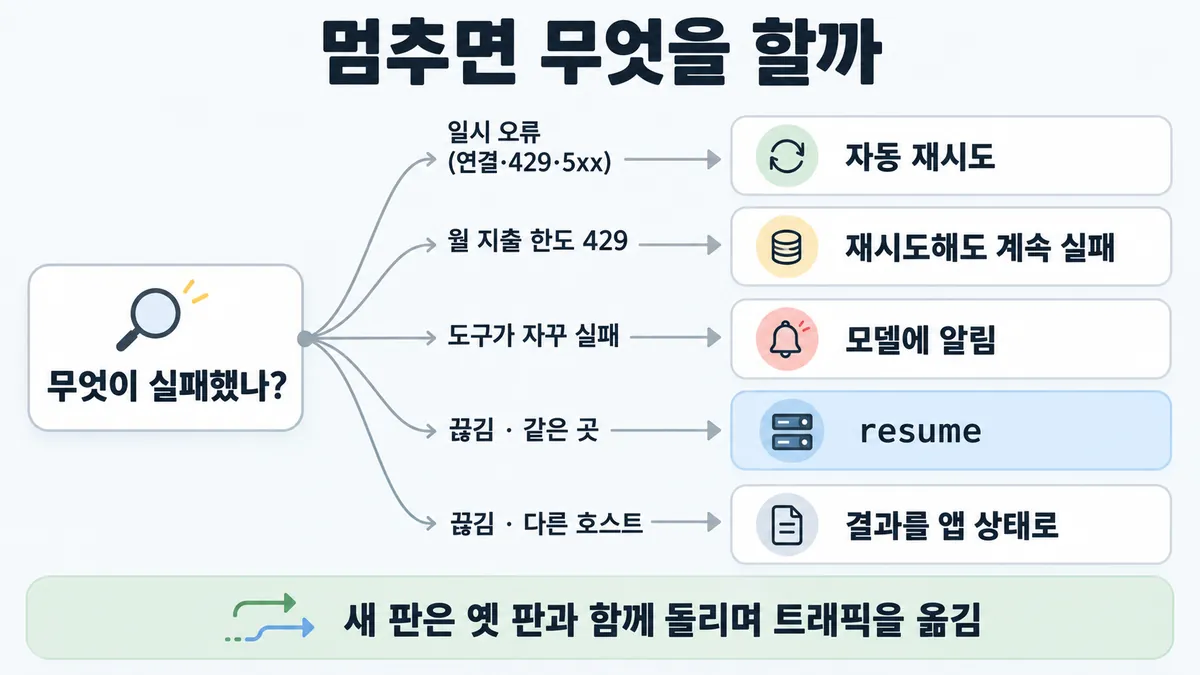
① 멈추면 [1.4③]
자동 재시도
공식 SDK 가 지수 백오프로 기본 2번 자동 재시도한다
재시도해도 계속 실패한다
retry-after 없이 계속 실패한다
모델에 알린다
도구 실패를 모델에 알려 적응시킨다
한도를 올려 resume 한다
max_turns·예산 한도로 끝난 실행도 한도를 올려 resume 한다
resume
멈춘 곳에서 재개한다. 세션은 대화만 저장하고 파일시스템은 저장하지 않는다. 파일은 file checkpointing 으로 다룬다
결과를 앱 상태로
결과(분석·결정·diff)를 앱 상태로 저장해 새 세션 프롬프트에 넣는다. 이쪽이 흔히 더 튼튼하다
② 기다릴까 [1.4③]
동기
조율은 쉽다. 하지만 subagent 하나 때문에 전체가 막힌다
비동기
결과 조율·상태 일관성·subagent 간 오류 전파가 어렵다
③ 새 버전 배포 [1.4③]
구버전·신버전 함께
구버전·신버전을 함께 돌리며 트래픽을 조금씩 옮긴다 (rainbow deployment)
코디네이터를 업데이트한다
참조 에이전트는 스냅샷 버전에 고정된다. 그래서 새 버전에 위임하려면 코디네이터를 업데이트한다
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : orchestrator → subagents → 체크포인트
규칙 (체크포인트) : 결정론적 안전장치 (재시도 로직 · 정기 체크포인트)
질문 : 끊기면 어디서부터 다시 할까?
① 멈춘 곳에서 재개 ✓
- 시작 : orchestrator — 말 : “환불 오류 원인을 찾아 줘 (단계 9개)”
- 위임 : orchestrator → subagents : 단계를 나눠 맡긴다 — 쪽지 : 단계 1~9 / subagent 3개
- 저장 : subagents → 체크포인트 : 정기적으로 체크포인트를 남긴다 — 쪽지 : 2:30 저장 / 끝난 단계 7 · 남은 단계 2
- 실패 : subagents : 도구 실패를 모델에 알린다 — 쪽지 : tool_result: 검색 시간 초과 / 재시도 가능 · 부분 결과 있음
- 재개 : 체크포인트 → subagents : 멈춘 곳에서 재개한다 — 쪽지 : resume: 세션 ID / 2:30 저장분부터 → 10분만 다시
- 끝 : 결정론적 안전장치와 모델 지능을 함께 쓴다. 마지막 체크포인트 뒤만 다시 한다
② 처음부터 재시작 ≠
- 시작 : orchestrator — 말 : “환불 오류 원인을 찾아 줘 (단계 9개)”
- 건너뜀 : 체크포인트
- 위임 : orchestrator → subagents : 단계를 나눠 맡긴다 — 쪽지 : 단계 1~9 / subagent 3개
- 실패 : subagents : 검색 시간 초과 — 쪽지 : 2:40 오류 / search timeout
- 재시작 : orchestrator → subagents : 처음부터 다시 시작한다 — 쪽지 : 단계 1/9 부터 다시 / 다시 할 양 2시간 40분
- 끝 : 재시작은 비싸고 사용자를 짜증나게 한다
③ 동기 대기 ≠
- 시작 : orchestrator — 말 : “환불 오류 원인을 찾아 줘 (단계 9개)”
- 위임 : orchestrator → subagents : 묶음이 다 끝날 때까지 기다린다 — 쪽지 : subagent 4개 / 70초 · 85초 · 95초 · 8분
- 타이머 : subagents : 검색 시간 초과
- 대기 : subagents → orchestrator : 셋은 끝났는데 기다린다 — 쪽지 : 도착 3/4 · 95초에 끝남 / 남은 1개 때문에 8분 대기
- 끝 : subagent 하나 때문에 전체가 막힌다
규칙 원문 ①②③ (갈림길로 그린 규칙)
-
상태와 실패 : 실패하면 처음부터 재시작하지 않는다. 멈춘 곳에서 재개한다. 재시작은 비싸고 사용자를 짜증나게 한다 [1.4③]
결정론적 안전장치(재시도 로직 · 정기 체크포인트)와 모델 지능(도구 실패를 모델에 알려 적응시키는 것)을 함께 쓴다
도구 오류는 불투명한 코드·traceback 이 아니라, 구체적으로 고칠 점을 알려 주는 메시지로 준다. 자세한 것은 ■ 도구 설계 에 있다
subagent 실패를 "성공 + 빈 결과" 로 삼키지 않는다. orchestrator 가 반응하도록 세 가지를 돌려준다
- 오류 종류
- 재시도 가능 여부
- 모은 부분 결과
필드 구성은 이 카드의 해석이다. 공식은 도구 실패를 모델에 알리고, 오류 메시지를 구체적으로 쓰라는 것이다
재시도 : 공식 SDK 는 일시 오류(연결·429·5xx)를 지수 백오프로 기본 2번 자동 재시도한다(
max_retries로 조정한다). 단 월 지출 한도 429 는 retry-after 없이 계속 실패한다. 자세한 것은 ■ rate limit 에 있다재개 수단 (Agent SDK 세션)은 셋이다
- continue : 가장 최근 세션을 잇는다
- resume : 세션 ID 로 잇는다
- fork : 원본은 두고 갈래를 새로 만든다
max_turns·예산 한도로 끝난 실행도 한도를 올려 resume 한다
세션은 대화만 저장한다. 파일시스템은 저장하지 않는다. 그래서 파일은 file checkpointing 으로 다룬다
다른 호스트면 SessionStore 로 transcript 를 복제한다. 또는 결과(분석·결정·diff)를 앱 상태로 저장해 새 세션 프롬프트에 넣는다. 뒤쪽이 흔히 더 튼튼하다
Managed Agents : 세션이 대화 기록·샌드박스 상태·산출물을 서버에 저장한다. 그래서 멈춘 뒤 깨끗이 재개한다
긴 작업 : 끝난 단계는 요약해 외부 메모리에 둔다. 컨텍스트 창이 차면 새 서브에이전트로 넘기고, 계획은 메모리에서 되찾는다
새 컨텍스트 창에서는 progress 파일과 git 로그로 상태를 되찾는다. git 은 되돌릴 체크포인트다
디버깅 : 같은 프롬프트도 실행마다 결정이 다르다. 그래서 프로덕션 전체를 트레이싱한다. 대화 내용이 아니라 결정 패턴과 상호작용 구조를 관측한다. 자세한 것은 ■ observability 세 신호 · ■ 텔레메트리 기록 범위 에 있다
-
동기 vs 비동기 : 동기는 subagent 묶음이 다 끝날 때까지 기다린다. 조율은 쉽다. 대신 세 가지 문제가 있다 [1.4③]
- orchestrator 가 도중에 subagent 의 방향을 못 튼다
- subagent 끼리 조율하지 못한다
- subagent 하나 때문에 전체가 막힌다
비동기는 동시에 작업하고, 필요할 때 새 subagent 를 만든다. 그래서 병렬성이 오른다. 대신 결과 조율·상태 일관성·subagent 간 오류 전파가 어렵다
연구 글(2025)은 동기로 운영한다. 모델이 더 긴 일을 하게 되면, 비동기의 이득이 그 복잡도를 넘을 것으로 본다
병렬이면 독립 작업은 합이 아니라 가장 느린 것의 시간에 끝난다
Agent SDK 서브에이전트는 기본이 백그라운드다. 결과가 먼저 필요하면 Claude 가
run_in_background: false로 둔다 (2026-09-28 조회)Managed Agents 세션 상태는 모든 스레드를 모은 값이다. 하나라도 running 이면 running 이다
-
배포 : 에이전트는 거의 쉬지 않고 도는 상태 있는 연결망이다(프롬프트·도구·실행 로직이 얽혀 있다). 배포 순간에 에이전트가 과정 어디에든 있을 수 있다. 그래서 모두를 한꺼번에 새 버전으로 바꾸지 못한다 [1.4③]
rainbow deployment 는 구버전·신버전을 함께 돌리며 트래픽을 조금씩 옮긴다
Managed Agents : 코디네이터 명단은 만들거나 업데이트할 때 스냅샷으로 저장된다. 참조 에이전트는 스냅샷 버전에 고정된다. 그래서 새 버전에 위임(delegation)하려면 코디네이터를 업데이트한다
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
| 긴 실행이 중간에 실패했다 | 처음부터 하지 않는다. 멈춘 곳에서 재개한다 | multi-agent-research-system |
| 도구가 계속 실패한다 | 실패를 모델에 알려 적응시킨다. 재시도와 체크포인트도 둔다 | multi-agent-research-system |
| 연결 오류·429·5xx 다 | SDK 가 자동 재시도한다(기본 2번, 지수 백오프) | errors |
| 월 지출 한도 429 다 | 재시도는 소용없다. 접근이 풀릴 때까지 계속 실패한다 | errors |
| max_turns·예산 한도로 끝났다 | 한도를 올려 같은 세션을 resume 한다 | agent-sdk-sessions |
| 다른 호스트·서버리스에서 이어가야 한다 | SessionStore 로 transcript 를 복제한다. 또는 결과를 앱 상태로 새 세션에 넣는다 | agent-sdk-sessions |
| 에이전트가 파일을 바꿨고 되돌려야 한다 | file checkpointing 을 쓴다 (세션은 대화만 저장한다) | agent-sdk-sessions |
| subagent 하나가 전체를 막는다 | 동기 병목이다. 비동기는 병렬성을 주지만 조율·일관성·오류 전파 부담이 있다 | multi-agent-research-system |
| 실행 중인 에이전트가 있는데 배포한다 | 구버전·신버전을 함께 두고 트래픽을 옮긴다 | multi-agent-research-system |
| Managed Agents 에서 subagent 새 버전을 쓴다 | 코디네이터를 업데이트한다(명단은 스냅샷에 고정된다) | managed-agents multi-agent |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 실행 길이 | 몇 시간 · 도구 호출 수백 | 체크포인트를 두고 재개한다 | multi-agent-research-system | |
| 실행 길이 | 한 번에 끝나는 무상태 호출 | 그냥 다시 실행(재시도)하는 것이 맞다. 세션 저장도 끌 수 있다 | 뒤집히는 때 1 | |
| 실패 종류 | 일시 오류 | 재시도한다 | errors | |
| 실패 종류 | 한도(지출·턴·예산) | 재시도가 아니라 한도를 바꾸고 재개한다 | errors · agent-sdk-sessions | |
| 호스트 | 같은 머신 | resume 한다 | agent-sdk-sessions | |
| 호스트 | CI·임시 컨테이너·서버리스 | 결과를 앱 상태로 넘긴다. 또는 SessionStore 를 쓴다 | 뒤집히는 때 2 | |
| subagent 시간 편차 | 한 subagent 만 유독 느리다 | 동기면 그 subagent 가 전체 시간을 정한다 | 계산 | 뒤집히는 때 3 |
| subagent 시간 편차 | 비슷하다 · 조율이 중요하다 | 동기로 충분하다 | 뒤집히는 때 4 | |
| 배포 시점 | 도는 에이전트가 있다 | 구버전·신버전을 함께 둔다 | 판단 규칙 9 |
연습 문제
고객지원 Agent 의 3시간짜리 환불 오류 원인 조사가 2시간 40분째에 작업 서버 재부팅으로 끊겼다중간에 끊김. 운영팀은 "깨끗하게 처음부터 다시 돌리자"고 한다. 재부팅된 서버는 같은 머신이라 세션 기록이 그대로 남아 있다같은 곳. 어떻게 이어 가야 하나?
시험 대비
함정
- subagent 하나가 검색 시간 초과로 멈추면, "실패하면 전체를 처음부터 다시" 는 함정이다. 멈춘 곳에서 재개한다
- "전부 비동기로 바꾸면 무조건 빨라진다" 는 함정이다. 결과 조율·상태 일관성·오류 전파 비용이 든다
- "재시도 로직만 넣으면 끝이다" 는 함정이다. 결정론적 안전장치를 두고, 도구 실패를 모델에 알린다. 지출 한도 429 는 재시도해도 계속 실패한다
- "resume·fork 하면 파일 변경도 되돌아간다" 는 함정이다. 세션과 fork 는 대화만 다룬다. 파일은 file checkpointing 으로 다룬다
- "새 버전을 한꺼번에 배포한다" 는 함정이다. 돌던 에이전트가 깨진다. 구버전·신버전을 함께 둔다
- "코디네이터가 참조 에이전트의 최신 버전을 자동으로 쓴다" 는 함정이다. 참조 에이전트는 스냅샷 버전에 고정된다
- "원인을 찾으려 대화 내용을 전부 기록한다" 는 함정이다. 결정 패턴과 상호작용 구조를 관측한다(프라이버시). 자세한 것은 ■ 텔레메트리 기록 범위 에 있다
- Managed Agents 세션 예산 : 예산에 닿으면
budget_reached로 일시 정지한다. 예산을 바꾸면 재개한다. 스레드마다 따로 정지한다 시험 뒤 변경 2026-08-07
신호
"Agents are stateful and errors compound."
"Instead, we built systems that can resume from where the agent was when the errors occurred."
"letting the agent know when a tool is failing and letting it adapt works surprisingly well."
"We combine the adaptability of AI agents built on Claude with deterministic safeguards like retry logic and regular checkpoints."
"Synchronous execution creates bottlenecks."
"by gradually shifting traffic from old to new versions while keeping both running simultaneously."
"Capture the results you need (analysis output, decisions, file diffs) as application state and pass them into a fresh session’s prompt."
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
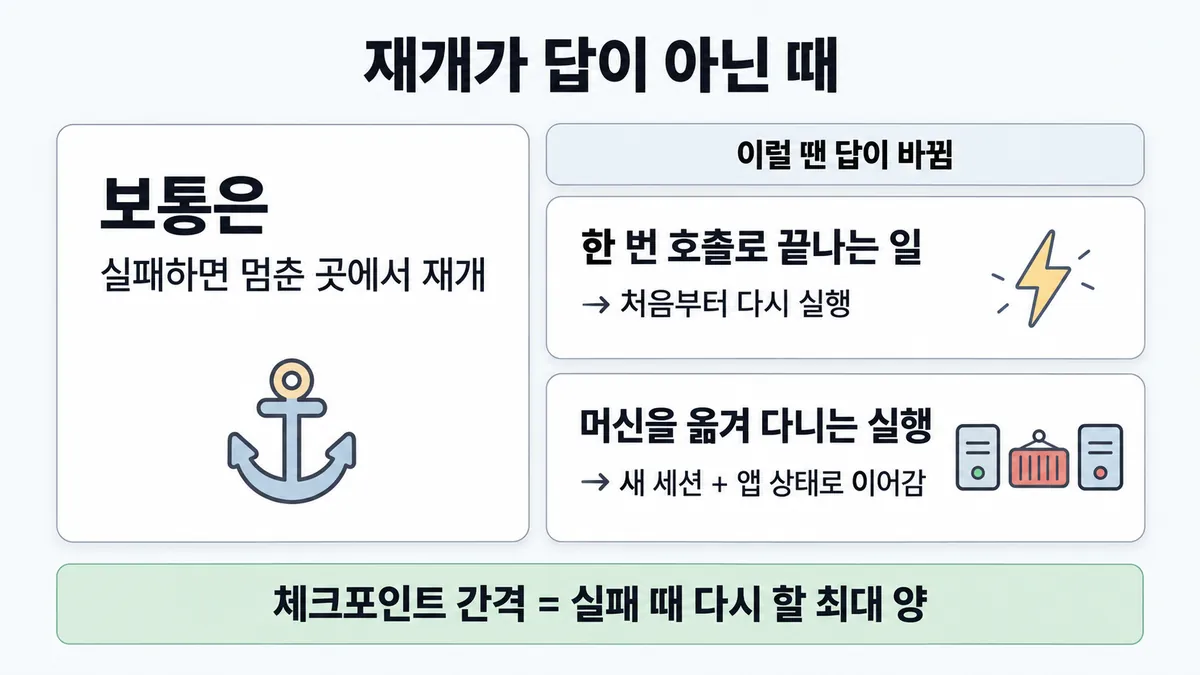
1. 처음부터 다시가 맞는 때
- 조건 : 티켓 한 건 분류처럼 한 번 호출로 끝나는 무상태 작업이다.
- 판단 : 쌓인 상태가 없으니 "재개" 할 것도 없다. 다시 실행(재시도)하는 것이 가장 단순하다. Agent SDK 도 무상태 작업에는 세션을 디스크에 안 남기는 옵션을 둔다(
persistSession: false, TypeScript). - 등급 : (옵션) · "상태가 없으면 재시작이 맞다"는 추론
- 근거 : agent-sdk-sessions
2. resume 보다 "새 세션 + 앱 상태"가 나은 때
- 조건 : 실행이 CI 워커와 임시 컨테이너를 옮겨 다닌다. 세션 파일은 만든 머신에만 있다.
- 판단 : 필요한 결과(분석·결정·diff)를 앱 상태로 잡아 새 세션 프롬프트에 넣는 쪽이 "흔히 더 튼튼" 하다. 공식 선택지는 셋이다.
- SessionStore 로 transcript 를 복제한다
- 세션 파일을 옮긴다
- resume 에 기대지 않는다
- 근거 : agent-sdk-sessions · prompting-best-practices(새 창에서 파일시스템으로 상태를 되찾는 편이 compaction 보다 나을 때가 있다)
3. 동기 대기가 전체를 붙잡을 때
- 조건 : subagent 4개가 70초 · 85초 · 95초 · 8분(시간 초과 직전) 걸린다.
- 계산 : 순차로 하면 70 + 85 + 95 + 480 = 730초(약 12분)다. 병렬 동기는 가장 느린 것인 480초(8분)다. 느린 하나를 빼면 95초다. 한 subagent 때문에 약 5배 길어진다.
- 판단 : 병렬화만으로는 부족하다. 길은 둘이다. 느린 subagent 에 시간 한도를 두고 실패를 모델에 알려 다른 길을 찾게 한다. 또는 비동기로 먼저 끝난 결과부터 진행한다. 비동기의 대가는 결과 조율·상태 일관성·오류 전파 관리다.
- 전제 : subagent 끼리 독립이다. orchestrator 합성 시간은 뺀다.
- 등급 : 계산 (병렬 = 가장 느린 것의 시간은 확인)
- 근거 : agent-sdk-subagents · multi-agent-research-system
4. 동기로 두는 게 나은 때
- 조건 : subagent 시간이 비슷하다. orchestrator 가 모든 결과를 모아 한 번에 판단해야 한다.
- 판단 : 연구 글의 실제 운영(production)도 동기다. 조율이 단순하다는 이득이 크다. 공식은 "모델이 더 긴 일을 하게 되면" 비동기 이득이 복잡도를 넘을 것이라고 한다. 지금 무조건 비동기로 가라는 뜻이 아니다.
- 근거 : multi-agent-research-system
5. 재개 지점을 얼마나 자주 — 잃는 양 계산
- 조건 : 3시간짜리 조사가 2시간 40분에 실패했다. 체크포인트는 25분마다 남긴다.
- 계산 : 처음부터 하면 2시간 40분을 다시 한다. 재개하면 마지막 체크포인트 뒤 최대 25분만 다시 한다(2시간 30분 시점 저장이면 10분).
- 판단 : 체크포인트 간격은 실패 때 다시 할 최대 양이다. 긴 작업일수록 촘촘히 둔다.
- 등급 : 계산 (정기 체크포인트는 확인)
- 근거 : multi-agent-research-system
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 근거 |
|---|---|---|---|
| "실패하면 전체를 처음부터 다시 돌린다" | 깨끗하게 새로 하고 싶다 | 재시작은 비싸고 사용자를 짜증나게 한다. 멈춘 곳에서 재개한다 | multi-agent-research-system |
| "전부 비동기로 바꾸면 무조건 빨라진다" | 기다림이 사라질 것 같다 | 결과 조율·상태 일관성·오류 전파 부담이 생긴다 | multi-agent-research-system |
| "재시도 횟수를 늘리면 해결" | 대부분 오류는 일시적이다 | 지출 한도 429 는 계속 실패한다. 도구 실패는 모델이 적응해야 한다 | errors · multi-agent-research-system |
| "fork 하면 파일도 갈라진다" | 세션을 복사하니 그래 보인다 | fork 는 대화만 가른다. 파일 변경은 진짜로 남는다 | agent-sdk-sessions |
| "파드 재시작이면 복구 끝" | 무상태 서비스 습관이다 | 상태 있는 작업은 진행분이 날아간다 | multi-agent-research-system |
| "새 버전을 한 번에 전부 배포" | 버전이 섞이면 복잡해 보인다 | 도는 에이전트가 깨진다. 구버전·신버전을 함께 둔다 | multi-agent-research-system |
| "명단 에이전트를 고치면 코디네이터가 바로 새 버전을 쓴다" | 참조니까 최신일 듯하다 | 스냅샷에 고정된다. 코디네이터를 업데이트해야 한다 | managed-agents multi-agent |
| "원인 분석을 위해 대화 내용 전부 수집" | 많이 보면 잘 보일 것 같다 | 결정 패턴·상호작용 구조 관측으로 충분하다. 대화 내용은 안 본다(프라이버시) | multi-agent-research-system |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 1.4 공식 시험 가이드 v1.0
- multi-agent-research-system
- agent-sdk-sessions
- agent-sdk-subagents
- managed-agents overview
- managed-agents multi-agent
- errors
- writing-tools-for-agents
- prompting-best-practices
- 릴리스 노트
상태
- 시험 뒤 변경 1곳(세션 예산)
미해결
- 목록 1.4③ 의 영어 신호 2개("Agents are stateful and errors compound.", "Synchronous execution creates bottlenecks.")는 원문에서 찾았다. 이상 없다.
- 목록의 비유 용어 "rainbow deployment" 는 공식 글 용어가 맞다. 구체 절차(몇 % 씩 옮기나)는 공식 글에 없다.
- Agent SDK 서브에이전트 "기본 백그라운드" 는 지금 문서 값이다(Claude Code v2.1.198 이후). 시험 시점(2026-07) 기준인지 모른다.
- 세션 예산(
budget_reached)은 2026-08-07 에 추가됐다. 시험 뒤 변경이다.