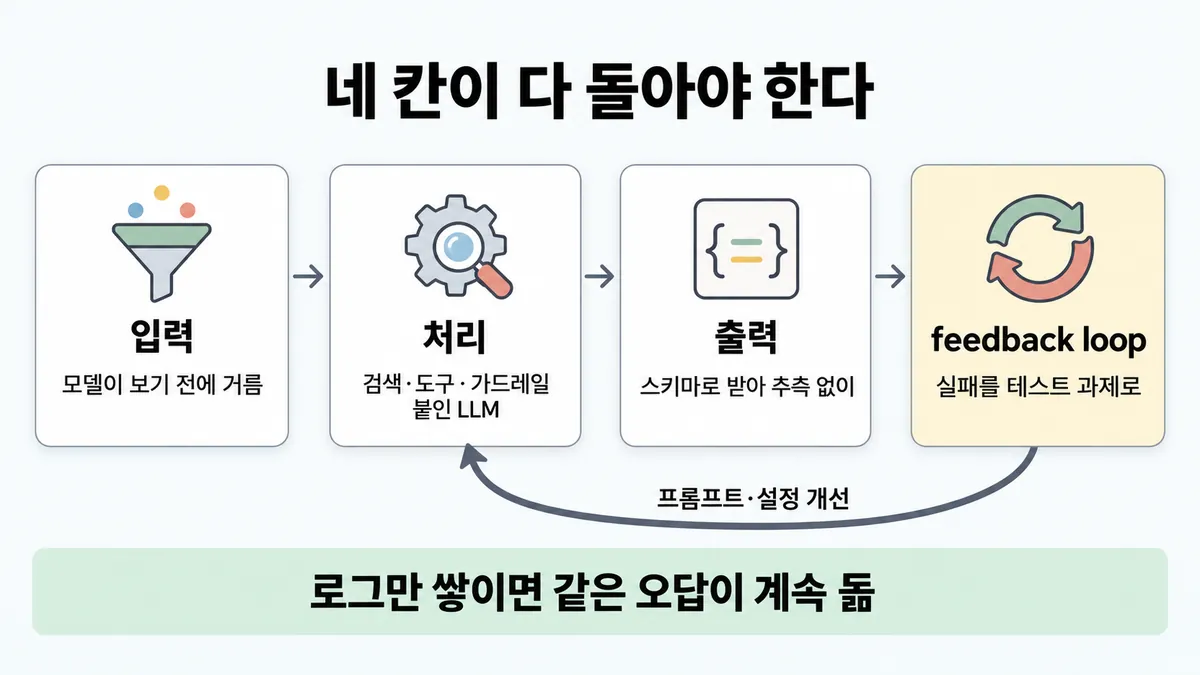
■ input → processing → output → feedback loop
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 1.2 입력부터 피드백까지 구조 설계 · D1 설계 17%Design end-to-end architectures (input → processing → output → feedback loops)
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 1.2① 입력·처리·출력·피드백, 각 칸은 무슨 일을 맡나? — 단계마다 책임 나누기 (입력 선별 → 보강된 LLM 처리 → 모양이 정해진 출력 → 평가 결과를 되돌리는 길)
- 4.6② 출시 뒤 품질이 조용히 떨어진다 — 무엇을 돌리나? — 운영 신호를 eval 로 되먹이는 루프
- 2.2② JSON 모양·금지 규칙을 꼭 지켜야 한다 — 프롬프트? prefill? 스키마? — 유도(프롬프트) vs 강제(스키마·enum 도구·훅) · prefill 400 을 만났을 때의 수리
한눈에
칸마다 맡는 일을 나눈다
- 입력 : 모델이 보기 전에 거른다
- 처리 : 검색(retrieval)·도구·가드레일·사람 확인을 붙인 LLM(augmented LLM)이 처리한다
- 출력 : 스키마로 받는다. 그래서 뒤쪽 코드가 추측 없이 쓴다
- feedback loop : 실패를 테스트 과제로 바꾼다. 그리고 프롬프트·설정 개선으로 되돌린다
비유 알림은 오는데, 사후 분석이 런북 개선으로 이어지지 않는 팀이다. feedback loop 칸이 빠지면 같은 장애가 반복된다. "대시보드를 만들었으니 feedback loop 끝" 이 속이는 습관이다
ELI5
식당 주방을 네 칸으로 나누는 거예요.
- 입구에서 상한 재료를 먼저 골라내요(입력).
- 요리사는 레시피·도구·맛보기를 곁에 두고 요리해요(처리).
- 접시 모양이 정해져 있어야 서빙하는 사람이 헷갈리지 않아요(출력).
- 손님이 남긴 음식을 보고 레시피를 고쳐야 다음엔 안 남겨요(피드백).
개념 설명
원리
입력 칸은 모델이 보기 전에 거른다
- 가벼운 모델(Haiku 4.5)로 사용자 입력을 미리 분류한다. 알려진 인젝션 패턴도 필터로 거른다. 판정은 구조화 출력으로 받아 앱이 분기한다.
- 같은 선별을 도구 결과에도 적용한다. 도구가 가져온 글도 믿을 수 없는 입력이기 때문이다. 자세한 것은 ■ 프롬프트 인젝션 피해 경로 끊기 에 있다.
- 선별을 주 응답과 따로 돌리는 편이 한 호출이 둘 다 하는 것보다 낫다(병렬화의 가드레일 예).
처리 칸은 보강된 LLM 이다
- augmented LLM 은 검색(retrieval)·도구·메모리를 붙인 LLM 이다. 모델이 검색어를 만들고, 도구를 고르고, 무엇을 기억할지 정한다.
- 정적 지식은 검색(RAG)으로 다룬다. 잔액·주문 같은 실시간 값은 임베딩 RAG 로 부족하다. 그래서 도구를 쓴다.
- 가드레일은 네 가지다.
- 환각(hallucination)을 줄인다(인용·사실 확인)
- 정책을 교차 확인한다
- 권한 없는 약속을 하지 않게 한다
- PII 를 제거한다
- 사람 확인 지점 : 에이전트는 체크포인트에서나 막힐 때 사람에게 돌아온다.
- 루프는 앱이 맡는다. 앱은
stop_reason으로 다음 단계를 정한다(1.2②). "You own the loop and the tools. Claude owns the reasoning." (Skilljar)
출력 칸은 스키마로 받는다
- 구조화 출력은 JSON outputs(
output_config.format, 답의 모양)와 strict tool use(strict: true, 도구 입력의 모양)다. 제약 디코딩으로 스키마 준수를 보장한다. - 구조화 출력이 없으면 이런 일이 생긴다.
- 파싱 오류가 난다
- 필수 필드가 빠진다
- 타입이 맞지 않는다
- 재시도 로직이 필요하다
- 예외는 셋이다.
refusal: HTTP 200 으로 온다. 거절이 스키마보다 우선한다max_tokens: 답이 잘린다- enum 대소문자 : 오류 없이 다르게 온다
feedback loop 칸은 실패를 테스트로 바꾼다
- 성공 기준(success criteria), 평가, 개선이 한 사이클이다. 실패(사용자 신고·지원 큐)를 테스트 과제로 바꿔야 실제 사용을 반영한다. 그래야 regression(회귀)도 막는다.
- 출시 전과 변경마다 자동 eval 을 돌린다. 자동 eval 은 첫 방어선이다.
- 출시 뒤에는 세 가지를 쓴다.
- 운영(production) 감시(분포 변화·예상 못 한 실패)
- 사용자 피드백
- 대화 기록 읽기
- 한 겹이 모든 것을 잡지는 못한다. 스위스 치즈처럼 구멍 난 겹을 여러 장 겹쳐 막는다.
- 운영 감시만 있으면 사후 대응이 된다. 문제가 사용자에게 먼저 닿는다.
핵심 질문 두 개
- 칸 사이에 넘어가는 것(판정 · 도구 입력 · 최종 답)이 스키마로 정해져 있나?
- 운영에서 잡힌 실패가 다음 평가 세트로 들어가는 길이 있나?
규칙과 판단
갈림길
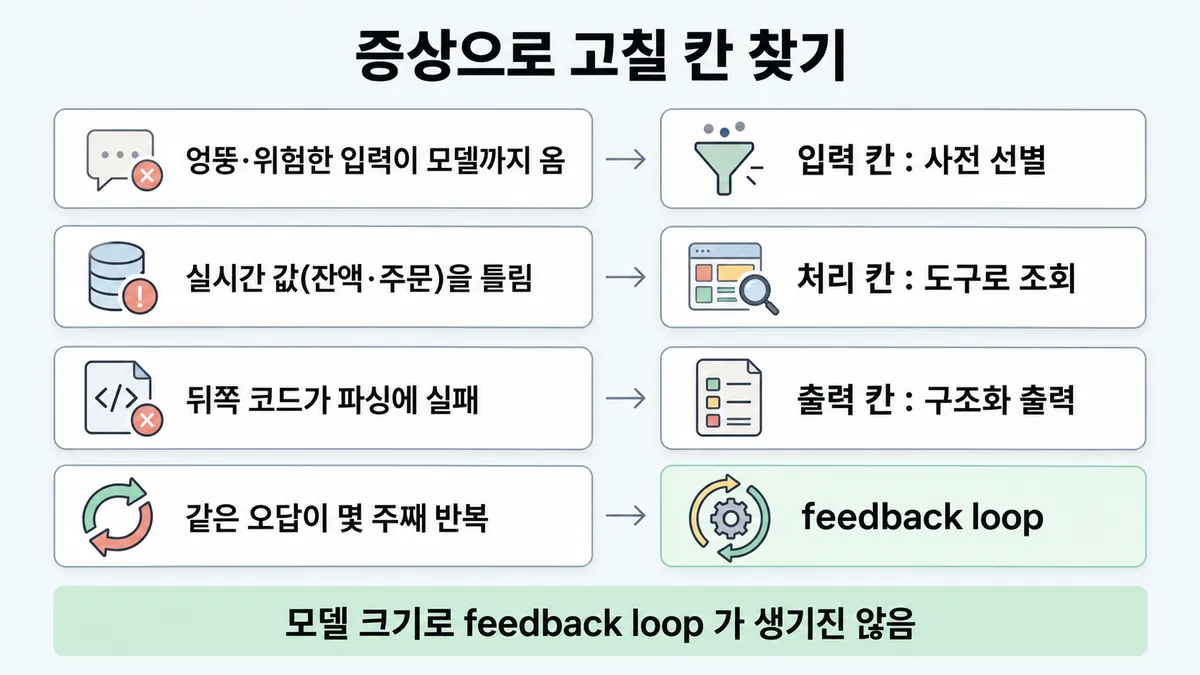
①②③④ 어느 칸이 문제 [1.2①]
입력 칸
가벼운 모델(Haiku 4.5)로 사용자 입력을 사전 선별한다. 판정은 구조화 출력으로 받아 앱이 분기한다
처리 칸·도구
실시간 값은 임베딩 RAG 로 부족하다. 그래서 도구로 조회한다
출력 칸
구조화 출력을 쓴다. 구조화 출력은 JSON outputs(output_config.format)와 strict tool use(strict: true)다
feedback loop 칸
실패(사용자 신고·지원 큐)를 테스트 과제로 바꿔야 regression(회귀)을 막는다
③ 스키마를 걸어도 [1.2①] [1.2②]
stop_reason 이 무엇인가?refusal
거절이 스키마보다 우선한다
refusal 은 HTTP 200 으로 온다. 거절이 스키마보다 우선한다
max_tokens
답이 잘렸다
max_tokens 는 답이 잘린 것이다. 더 큰 값으로 재시도한다
대소문자를 무시한다
enum 대소문자는 보장되지 않는다. 오류 없이 온다. 그래서 대소문자를 무시하고 비교한다
④ feedback loop 무엇으로 [1.2①] [4.6②]
자동 eval
자동 eval 은 변경과 모델 업그레이드마다 도는 첫 방어선이다
운영 감시 + 사용자 피드백 + 대화 기록 읽기
운영(production) 감시는 사후 대응이다. 잡은 실패를 테스트로 바꿔야 루프가 된다
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 입력 → 처리 → 출력 → feedback loop
규칙 (출력) : 스키마로 받아 뒤쪽 코드가 추측 없이 쓴다
규칙 (feedback loop) : 실패를 테스트 과제로 바꿔 프롬프트·설정 개선으로 되돌린다
질문 : 같은 오답이 반복되면 어느 칸이 빠졌을까?
① 네 칸이 다 돈다 ✓
- 시작 : 입력 — 말 : “지금 해지하면 수수료가 얼마예요?”
- 거름 : 입력 : 모델이 보기 전에 거른다 — 쪽지 : Haiku 4.5 선별 / { 안전: true, / 주제: "해지" }
- 통과 : 입력 → 처리 : 앱이 분기한다 — 말 : “지금 해지하면 수수료가 얼마예요?”
- 보강 : 처리 : 검색·도구·가드레일을 붙인다 — 쪽지 : 도구 : / get_contract / → 가입 14개월째
- 스키마 : 처리 → 출력 : 항상 파싱되는 JSON 이다 — 쪽지 : { 수수료: 50000, / 근거: "약관 7조" / }
- feedback loop : 출력 → feedback loop : 실패를 테스트 과제로 바꾼다 — 쪽지 : 신고 #812 / → 테스트 과제 / "14개월 해지 / = 30,000"
- 개선 : feedback loop → 처리 : 개선으로 되돌린다 — 쪽지 : 프롬프트 수정 / eval 에 새 과제 / 포함해 통과
- 다시 : 처리 → 출력 — 쪽지 : { 수수료: 30000, / 근거: "약관 7조" / }
- 끝 : 실패를 테스트 과제로 바꿔야 regression 을 막는다
② feedback loop 가 끊긴다 ≠
- 시작 : 입력 — 말 : “지금 해지하면 수수료가 얼마예요?”
- 거름 : 입력 : 모델이 보기 전에 거른다 — 쪽지 : Haiku 4.5 선별 / { 안전: true, / 주제: "해지" }
- 통과 : 입력 → 처리 : 앱이 분기한다 — 말 : “지금 해지하면 수수료가 얼마예요?”
- 보강 : 처리 : 검색·도구·가드레일을 붙인다 — 쪽지 : 도구 : / get_contract / → 가입 14개월째
- 스키마 : 처리 → 출력 : 항상 파싱되는 JSON 이다 — 쪽지 : { 수수료: 50000, / 근거: "약관 7조" / }
- 쌓임 : 출력 → feedback loop : 로그만 쌓이고 과제가 안 된다 — 쪽지 : 신고 로그 3주치 / 같은 오답 214건 / 테스트 과제 0개
- 끝 : 하나 고치면 다른 게 깨지는 사후 대응 루프다. 같은 오답이 계속 반복된다
③ 자유 문장 + 정규식 ≠
- 시작 : 입력 — 말 : “지금 해지하면 수수료가 얼마예요?”
- 거름 : 입력 : 모델이 보기 전에 거른다 — 쪽지 : Haiku 4.5 선별 / { 안전: true, / 주제: "해지" }
- 통과 : 입력 → 처리 : 앱이 분기한다 — 말 : “지금 해지하면 수수료가 얼마예요?”
- 보강 : 처리 : 검색·도구·가드레일을 붙인다 — 쪽지 : 도구 : / get_contract / → 가입 14개월째
- 자유 문장 : 처리 → 출력 : 파싱 오류와 필수 필드 누락이 난다 — 쪽지 : "음, 3만 원쯤 / 될 것 같아요!" / 정규식 \d+원 / → 못 찾음
- 끝 : 뒤쪽 코드가 추측해야 한다
나머지 규칙
-
칸 사이 약속은 스키마 : 입력 선별 판정·도구 입력·최종 출력을 모두 스키마로 받으면, 칸마다 뒤쪽 코드가 추측하지 않는다. JSON outputs 와 strict tool use 는 같은 요청에서 같이 쓴다
규칙 원문 ①②③④ (갈림길로 그린 규칙)
-
입력 : 모델이 보기 전에 거른다. 세 가지를 한다 [1.2①]
- 가벼운 모델(Haiku 4.5)로 사용자 입력을 사전 선별한다
- 알려진 인젝션 패턴을 필터로 거른다
- 판정은 구조화 출력으로 받아 앱이 분기한다
자세한 것은 ■ 프롬프트 인젝션 피해 경로 끊기 에 있다
선별을 주 응답과 따로(병렬) 돌리면, 한 호출이 가드레일과 답을 둘 다 하는 것보다 낫다
-
처리 : 보강된 LLM(augmented LLM)은 검색·도구·메모리를 붙인 LLM 이다. 정적 지식은 검색(RAG)으로 다룬다. 실시간 값은 임베딩 RAG 로 부족하다. 그래서 도구로 조회한다 [1.2①]
가드레일은 네 가지다
- 환각(hallucination)을 줄인다(인용·사실 확인)
- 정책을 교차 확인한다
- 권한 없는 약속을 하지 않게 한다
- PII 를 제거한다
사람 확인 지점 : 에이전트는 체크포인트에서나 막힐 때 사람에게 돌아온다
루프는 앱이 맡는다. 앱은 응답의
stop_reason으로 다음 단계를 정한다 (1.2② 본편) (Skilljar) -
출력 : 구조화 출력은 JSON outputs(
output_config.format)와 strict tool use(strict: true)다. 구조화 출력은 세 가지를 보장한다 [1.2①]- JSON 이 항상 파싱된다
- 필수 필드와 타입이 맞는다
- 스키마 위반 때문에 재시도할 필요가 없다
예외는 셋이다
refusal: HTTP 200 으로 온다. 거절이 스키마보다 우선한다max_tokens: 답이 잘린다. 더 큰 값으로 재시도한다- enum 대소문자 : 보장되지 않는다. 오류 없이 온다. 그래서 대소문자를 무시하고 비교한다
같이 못 쓰는 것이 있다. 인용(citations)과 JSON outputs 를 같이 쓰면 400 이다. 메시지 prefill 도 JSON outputs 와 호환되지 않는다
strict 도구는 요청당 20개까지다. 그래서 스키마가 깨지면 곤란한 도구만 strict 로 둔다
-
feedback loop : 성공 기준(success criteria)을 정하고, 평가하고, 개선하는 것이 한 바퀴다. 실패(사용자 신고·지원 큐)를 테스트 과제로 바꿔야 regression 을 막는다. 그래야 실제 사용도 반영된다 [1.2①]
출시 전과 변경마다 자동 eval 을 돌린다. 자동 eval 은 변경·모델 업그레이드마다 도는 첫 방어선이다
출시 뒤에는 세 가지로 본다
- 운영 감시(분포 변화·예상 못 한 실패)
- 사용자 피드백
- 대화 기록 읽기
자세한 것은 ■ observability 세 신호 · ■ 성공 기준 에 있다
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
| 엉뚱·위험한 입력이 주 대화까지 온다 | 가벼운 모델로 사전 선별하고 입력을 검증한다 | mitigate-jailbreaks |
| 선별이 주 응답과 한 호출에 섞여 있다 | 따로(병렬) 돌린다 | building-effective-agents "This tends to perform better than having the same LLM call handle both guardrails and the core response." |
| 실시간 값을 틀린다 | 도구로 조회한다 | customer-support-chat |
| 뒤쪽 코드가 파싱에 실패한다 | 구조화 출력을 쓴다 | structured-outputs |
| 도구 입력도 형식이 깨진다 | strict tool use 를 쓴다 (요청당 strict 20개까지) | structured-outputs |
| 인용(citations)이 필요한 답이다 | JSON outputs 와 같이 못 쓴다(400) | structured-outputs |
| 같은 오답이 반복되고, 로그는 쌓인다 | 실패를 테스트 과제로 바꾼다. 그리고 평가하고 개선한다 | demystifying-evals |
| 출시 뒤 품질을 확인한다 | 운영 감시·사용자 피드백·대화 기록 읽기를 쓴다. 자동 eval 은 변경마다 돌린다 | demystifying-evals |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 입력 출처 | 사용자 채팅이다 | 사전 선별한다(Haiku 4.5) | 판단 규칙 1 | |
| 입력 출처 | 도구 결과(메일·웹)다 | 같은 선별을 도구 결과에도 적용한다 | mitigate-jailbreaks | |
| 지식 종류 | 정적 문서다 | 검색(RAG) 또는 full context(문서 전체를 넣기)를 쓴다. 자세한 것은 ◆ RAG vs full context 에 있다 | customer-support-chat | |
| 지식 종류 | 실시간 값이다 | 도구를 쓴다 | 판단 규칙 3 | |
| 출력을 쓰는 쪽 | 뒤쪽 코드다 | 구조화 출력을 쓴다 | 판단 규칙 4 | |
| 출력을 쓰는 쪽 | 사람이 읽는 답이다 | 자유 문장도 된다 | 업계 일반 | — |
| 출력에 필요한 것 | 출처 인용이다 | 인용 기능을 쓴다 (JSON outputs 와 충돌한다) | 판단 규칙 6 | |
| 모델 | prefill 로 형식을 잡던 옛 방식이다 | Opus 4.6 은 지원하지 않는다. Fable 5·Mythos 5 는 400 이다. 그래서 구조화 출력을 쓴다 | 릴리스 노트 | |
| feedback loop 시점 | 출시 전·변경마다 | 자동 eval 을 돌린다 | 판단 규칙 8 | |
| feedback loop 시점 | 출시 뒤 | 운영 감시·피드백·기록 읽기를 쓴다 | 판단 규칙 8 |
연습 문제
자동차 보험 고객지원 Agent 가 같은 해지 수수료 오답을 3주째 반복한다몇 주째 반복. 고객 신고는 지원 큐에 로그로 쌓이기만 한다. 입력 선별과 JSON 출력은 잘 돈다. 팀은 "더 큰 모델로 바꾸자"고 한다. 어느 칸을 고쳐야 하나?
시험 대비
함정
- "같은 오답이 몇 주째 나오니 더 큰 모델로 바꾸자" 는 함정이다. feedback loop 칸이 빠진 것이다. 로그만 쌓이고 평가 과제로 바뀌지 않았다. 모델 크기로 feedback loop 가 생기지는 않는다 업계 일반. 쌓인 실패를 테스트 과제로 바꾼다
- "출력은 자유 문장으로 받고 정규식으로 파싱한다" 는 함정이다. 파싱 오류와 필수 필드 누락이 생긴다. 뒤쪽 코드가 추측해야 한다. 구조화 출력을 쓴다
- "assistant 메시지 prefill 과 stop sequence 로 JSON 만 받는다" 는 함정이다 (Skilljar API 2025 강의). 지금은 구조화 출력을 쓴다. prefill 은 Opus 4.6 에서 지원되지 않는다(2026-02-05). Fable 5·Mythos 5 에서는 400 이다(2026-06-09). JSON outputs 와도 호환되지 않는다
- "스키마를 걸었으니 오류 처리는 필요 없다" 는 함정이다.
refusal과max_tokens는 스키마와 안 맞을 수 있다 - "대시보드가 있으니 feedback loop 는 끝이다" 는 함정이다. 운영 감시는 사후 대응이다(문제가 사용자에게 먼저 닿는다). 평가가 없으면 하나 고치면 다른 게 깨지는 사후 대응 루프가 된다. 잡은 실패를 테스트로 바꿔야 루프가 된다
- "실시간 잔액도 RAG 로 다룬다" 는 함정이다. 실시간 값은 도구로 조회한다
- "사용자 피드백만 모으면 된다" 는 함정이다. 사용자 피드백은 드물고 심각한 쪽으로 치우친다. 왜 틀렸는지도 거의 적지 않는다
신호
"Design end-to-end architectures (input → processing → output → feedback loops)" (가이드 목표 1.2)
"Structured outputs constrain Claude's responses to follow a specific schema, ensuring valid, parseable output for downstream processing."
"Use a lightweight model like Claude Haiku 4.5 to pre-screen user input before it reaches your main conversation."
"The basic building block of agentic systems is an LLM enhanced with augmentations such as retrieval, tools, and memory."
"When dealing with queries that require real-time information, such as account balances or policy details, embedding-based RAG approaches are not sufficient."
"Converting user-reported failures into test cases ensures your suite reflects actual usage"
"development accelerates as failures become test cases, test cases prevent regressions, and metrics replace guesswork."
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
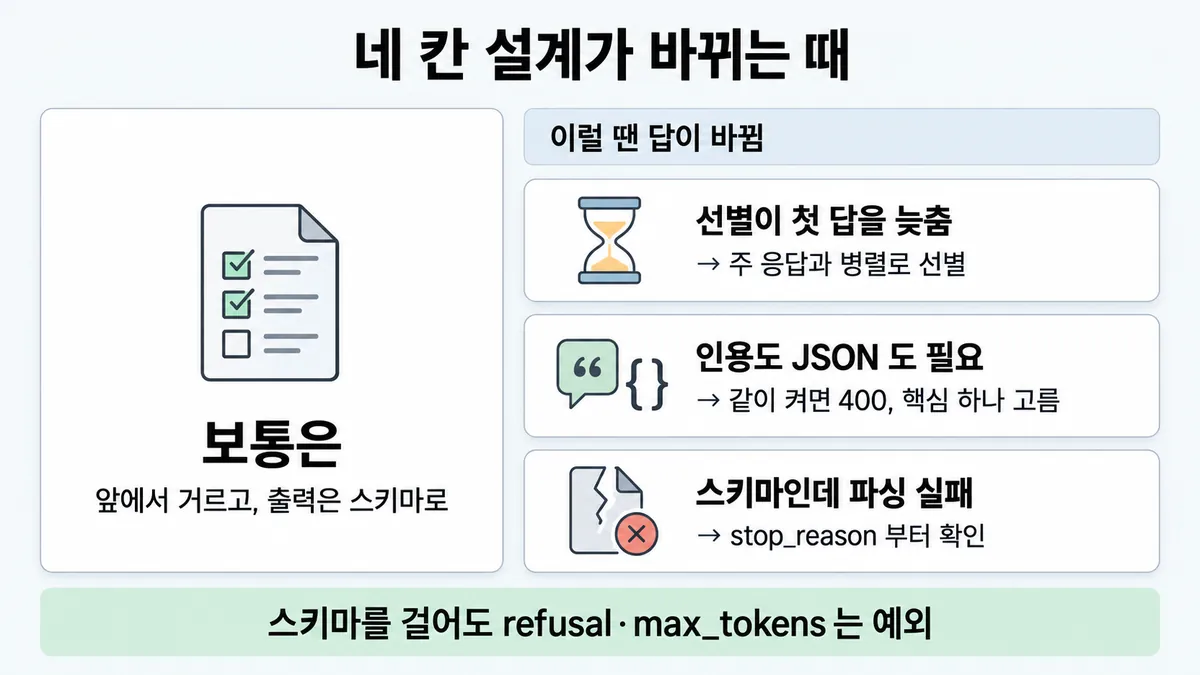
뒤집히는 때
1. 입력 선별이 지연(latency)을 늘리는 때
- 조건 : 모든 채팅에 선별 호출을 앞에 붙였다. 그랬더니 첫 답이 늦어졌다.
- 판단 : 선별을 순서대로(앞에) 두지 않는다. 주 응답과 병렬로 돌린다. 선별 결과가 "막아야 한다" 이면 주 응답을 버린다. 공식 문서도 분류기를 더하면 추가 호출이라 지연을 늘릴 수 있다고 적는다.
- 등급 : (병렬 가드레일 · 추가 호출 지연) · 버리는 운용은 업계 일반
- 근거 : building-effective-agents · customer-support-chat
2. 스키마가 오히려 막는 때
- 조건 : 정책 답변에 조항 인용을 반드시 붙여야 한다. 앱은 JSON 으로도 받고 싶다.
- 판단 : 인용(citations)과 JSON outputs 를 같이 쓰면 400 이다. 인용이 핵심이면 인용 기능을 쓰고 JSON 은 포기한다. JSON 이 핵심이면 인용 필드를 스키마 안에 직접 둔다(업계 일반).
- 등급 : (충돌) · 우회는 업계 일반
- 근거 : structured-outputs
3. 스키마를 걸었는데도 안 맞는 때
- 조건 : 구조화 출력을 켰다. 그런데 하루 수만 건 중 일부가 파싱에 실패한다.
- 판단 :
stop_reason부터 본다.refusal이면 거절이 스키마보다 우선한 것이다(HTTP 200, 토큰 과금).max_tokens이면 잘린 것이다. 더 큰 값으로 재시도한다. 정상 종료인데 값이 다르면 enum 대소문자 문제다. 대소문자를 무시하고 비교한다. - 근거 : structured-outputs
4. feedback loop 를 사용자 피드백에만 기대는 때
- 조건 : "싫어요" 버튼 수만 본다.
- 판단 : 사용자 피드백은 아래 네 가지 성질이 있다. 그래서 자동 eval·운영 감시·대화 기록 읽기와 겹쳐야 한다.
- 드물다
- 스스로 고른 사람만 누른다
- 심각한 쪽으로 치우친다
- 왜 틀렸는지 거의 적지 않는다
- 근거 : demystifying-evals
5. strict 를 전부 켜려는 때
- 조건 : 도구 26개에 전부
strict: true를 건다. - 판단 : strict 도구는 요청당 20개가 상한이다. 선택 파라미터는 합계 24개가 상한이다. 스키마가 깨지면 곤란한 도구만 strict 로 둔다. 나머지는 모델의 기본 준수에 맡긴다.
- 근거 : structured-outputs
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "몇 주째 같은 오답이니 더 큰 모델로" | 모델이 약해 보인다 | feedback loop 칸이 빠진 것이다. 실패를 테스트 과제로 바꾼다 | (feedback loop) · 업계 일반(모델 무관) | demystifying-evals |
| "자유 문장으로 받고 정규식으로 파싱" | 빨리 붙일 수 있다 | 파싱 오류와 필수 필드 누락이 생긴다. 구조화 출력은 형식을 보장한다 | structured-outputs | |
| "prefill + stop sequence 로 JSON 만" | Skilljar 2025 강의가 그렇게 가르친다 | 지금은 구조화 출력을 쓴다. prefill 은 JSON outputs 와 호환되지 않는다. 일부 모델은 400 이다 | structured-outputs · 릴리스 노트 · Skilljar 287732 | |
| "스키마 켰으니 오류 처리 불필요" | "Always valid" 문구가 있다 | refusal · max_ 는 스키마와 안 맞을 수 있다 | structured-outputs | |
| "대시보드를 만들었으니 feedback loop 끝" | 보이면 관리되는 것 같다 | 운영 감시는 사후 대응이다. 평가로 되돌리는 길이 있어야 루프가 된다 | demystifying-evals | |
| "실시간 잔액도 RAG index(색인)로" | RAG 가 지식 주입의 기본 같다 | 실시간 값은 임베딩 RAG 로 부족하다. 도구를 쓴다 | customer-support-chat | |
| "선별·답변을 한 호출에 같이 시킨다" | 호출 수가 줄어든다 | 따로 돌리는 편이 낫다 | building-effective-agents |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 1.2 공식 시험 가이드 v1.0
- structured-outputs
- mitigate-jailbreaks
- building-effective-agents
- customer-support-chat
- define-success
- demystifying-evals
- 릴리스 노트
- Skilljar API 287732
- Skilljar Platform 101 486254
상태
- 업계 일반 1줄(모델 크기 ≠ feedback loop)
미해결
- 목록 1.2① 영어 신호 "Design end-to-end architectures (input → processing → output → feedback loops)" 는 가이드 목표 문구(writer-spec 표)와 같다. 가이드 PDF 원문 파일은
raw/official/에 6~7쪽만 있다. 그래서 줄 번호 대조는 못 했다. - "feedback loop = 평가 결과를 프롬프트·모델 개선으로 되돌림" 의 "모델 개선" 쪽(파인튜닝 등)은 공식 문장이 없다. 카드는 프롬프트·설정 개선만 적는다.
- Skilljar Platform 101 "agent loop"(486254, 2026-06 추정)는 1.2② 본편 재료다. 여기서는 한 줄만 쓴다.