■ LLM-as-judge 설계
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 4.2 평가 데이터·테스트 설계 · D4 평가 16%Design evaluation datasets and test frameworks using mixed methodologies
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 4.2③ LLM 채점기를 어떻게 믿을 만하게 만드나? — LLM judge 설계 (채점 모델·출력 형태·탈출구·보정)
한눈에
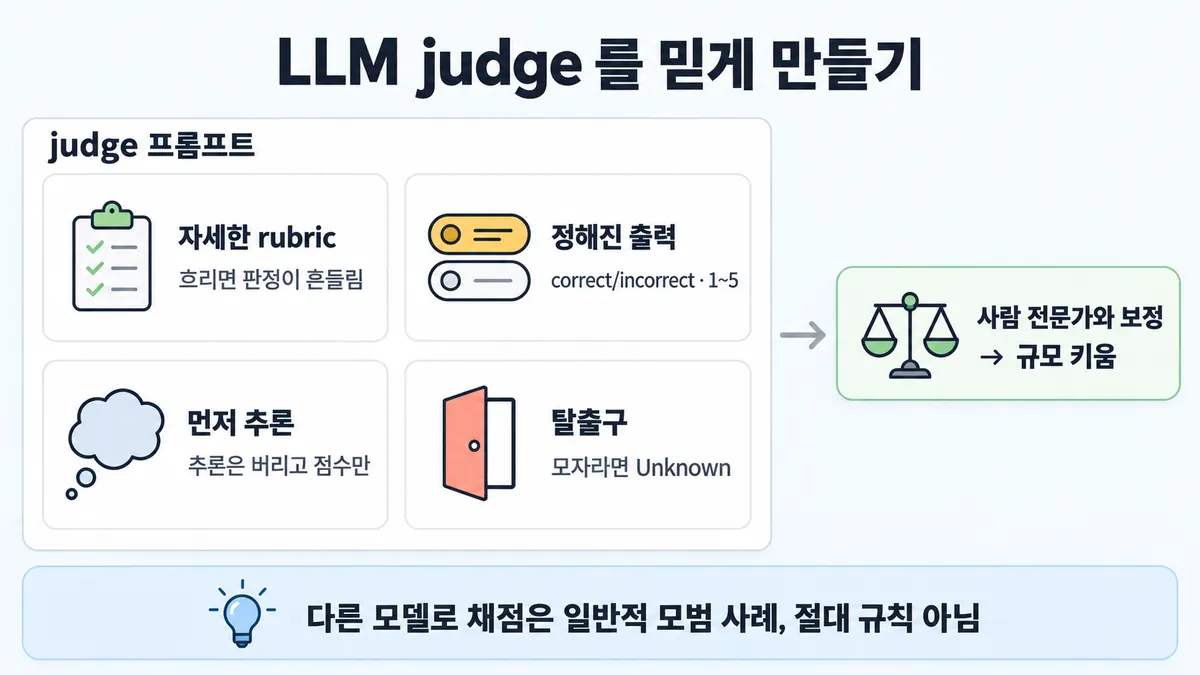
LLM judge 는 답을 LLM 에게 채점시키는 grader(채점기)다. judge 에게 네 가지를 준다. 그리고 사람 전문가와 먼저 맞춰 본 뒤(보정) 규모를 키운다
- 자세한 rubric
- 정해진 출력
- 먼저 추론(reasoning)
- "Unknown" 탈출구
judge 는 비결정적이고 코드보다 비싸다. 그래서 사람과 보정해야 정확하다
grader 를 고를지 말지는 ■ grader 고르기 에서 다룬다
비유 이상 탐지 알림을 온콜의 수동 판정과 대조해 정탐률을 맞춘다. 그 뒤에 자동화한다. 맞춰지면 수동 확인은 가끔만 한다
ELI5
그림 대회에 심사 도우미를 새로 뽑는 거예요.
- 도우미에게 "색칠이 선 밖으로 나가면 감점" 같은 채점표를 줘요.
- 점수는 1점부터 5점 중에서만 고르게 해요.
- 점수 전에 이유를 먼저 생각하게 하고, 점수판엔 점수만 적어요.
- 잘 모르겠으면 "모르겠어요" 라고 해도 된다고 알려 줘요.
- 처음 몇 번은 선생님 점수와 맞는지 봐요. 잘 맞으면 가끔만 봐요.
개념 설명
원리
왜 LLM judge 인가
- 어조·공감·종합처럼 정답이 하나가 아닌 답은 코드로 재지 못한다. LLM 은 뉘앙스를 잡고 규모를 키울 수 있다.
- 대가도 있다. judge 는 비결정적이고 코드보다 비싸다. 사람과 맞춰 보기(보정) 전에는 정확한지 모른다.
judge 프롬프트 네 부품
- rubric : 기준이 흐리면 같은 답에 다른 점수가 나온다(일관성 없는 판정). 한 기준에도 rubric 이 여럿 필요할 수 있다.
- 정해진 출력 : correct/incorrect 또는 1~5 로 받는다. 자유 글은 모아서 셀 수가 없다.
- 먼저 추론(reasoning), 추론은 버림 : 생각할 자리를 주면 복잡한 판단에서 채점이 좋아진다. 점수 집계에는
<result>만 쓴다. - 탈출구 : 정보가 모자라면 "Unknown" 을 돌려주게 한다. 탈출구가 없으면 judge 도 지어내서 확신 판정을 한다(환각(hallucination)).
믿게 만드는 절차
- 아래 순서로 간다.
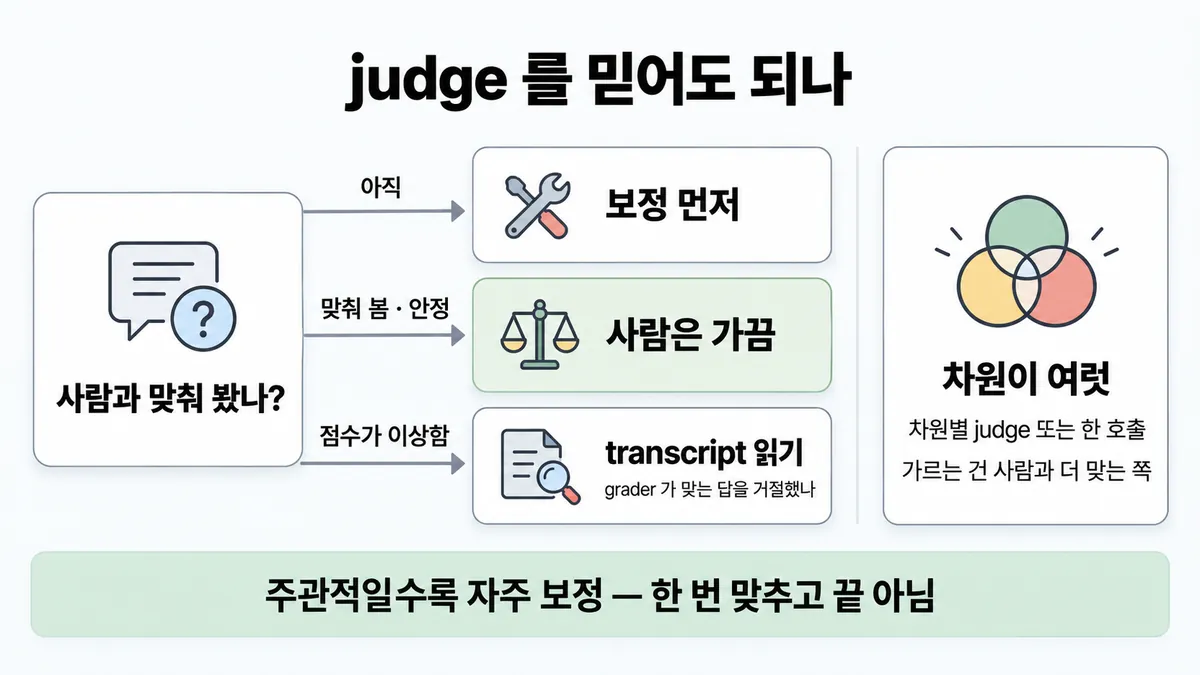
- 사람 전문가 채점과 먼저 맞춰 본다
- 사람 채점과 모델 채점의 차이가 작다는 확신을 얻는다
- 전체로 규모를 키운다
- 안정되면 사람은 가끔만 본다
- grader(채점기)도 틀린다. transcript 와 점수를 읽어야 "에이전트 실수"와 "grader 가 맞는 답을 거절함"을 가려낸다.
공식 문서끼리 갈리는 곳
- demystifying-evals 는 차원마다 따로 떼어낸 judge 가 "도움될 수 있다" 고 한다.
- 멀티 에이전트 리서치 글은 여러 judge 를 시험했다. 그 끝에 한 호출 · 한 프롬프트가 가장 일관되고 사람 판정과 맞았다.
- 둘을 잇는 기준은 보정 결과다. 어느 쪽이든 사람과 더 맞는 쪽을 쓴다.
핵심 질문 두 개
- judge 가 사람 전문가와 얼마나 맞는지 재 봤나?
- judge 에게 기준(rubric) · 출력 형태 · 생각할 자리 · "모름" 이 모두 주어졌나?
규칙과 판단
갈림길
①②③④ judge 프롬프트 [4.2③]
자세한 rubric
모호한 rubric 은 일관성 없는 판정을 낳는다
정해진 값
correct/incorrect 또는 1~5 로 받는다
먼저 추론
추론은 버리고 점수만 쓴다
탈출구
정보가 모자라면 "Unknown" 을 돌려주게 한다
⑤⑥ 몇 개 · 어느 모델 [4.2③]
둘 다 공식 문서에 있다
가르는 기준은 사람과 더 맞는 쪽이다. 차원마다 따로 떼어낸 judge 가 도움될 수 있다. 리서치 글에서는 한 호출 · 한 프롬프트가 가장 일관되고 사람 판정과 맞았다
다른 모델이 기본이다
다른 모델로 채점하는 것은 "일반적으로" 모범 사례다. 절대 규칙은 아니다
⑦⑧ 믿어도 되나 [4.2③]
보정 먼저
사람 전문가와 꼼꼼히 맞춰 본다
사람은 가끔
튼튼해지면 사람 검토는 가끔만 한다
transcript 를 읽는다
에이전트 실수인지, grader 가 맞는 답을 거절했는지 가린다
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 답 → judge → 점수 → 사람
규칙 (judge) : 자세한 rubric · 먼저 추론 · 모자라면 "Unknown"
질문 : judge 는 무엇을 돌려줘야 할까?
① 추론 뒤 점수만 ✓
- 시작 : 답 — 말 : “주문 #4821 은 내일 도착해요.”
- 채점 : 답 → judge : 자세한 rubric 으로 본다 — 쪽지 : rubric : 첫 문장에 / 도착일을 반드시 언급
- 추론 : judge : 먼저 추론한다 — 쪽지 : <thinking> 첫 문장에 / 도착일 "내일" 있음 / </thinking>
- 점수 : judge → 점수 : 추론은 버리고 점수만 낸다 — 쪽지 : <result>correct</result>
- 끝 : 코드는
<result>만 읽는다. 값은 correct/incorrect 또는 1~5 다
② 근거 없이 확신 ≠
- 시작 : 답 — 말 : “환불은 3일 안에 들어와요.”
- 채점 : 답 → judge : 정보가 모자라다 — 쪽지 : transcript 에 / 결제 수단 정보 없음
- 점수 : judge → 점수 : 탈출구 없이 판정한다 — 쪽지 : <result>correct</result>
- 끝 : "Unknown" 탈출구가 없으면 근거 없이도 판정한다. 이것이 환각 판정이다
③ 사람과 맞추기 ✓
- 시작 : 사람 — 쪽지 : 전문가가 먼저 채점한 / 표본 100건
- 보정 : 사람 → judge : 사람 전문가와 꼼꼼히 맞춰 본다 — 쪽지 : 같은 100건을 judge 로 / 판정이 다르면 rubric 고침
- 점수 : judge → 점수 : 사람과 차이가 작다 — 쪽지 : 사람 ↔ judge / 불일치 적음 → 확장
- 끝 : 튼튼해지면 사람 검토는 가끔만 한다
규칙 원문 ①②③④⑤⑥⑦⑧ (갈림길로 그린 규칙)
-
rubric : 자세하고 명확하게 쓴다. 예를 들어 "답은 첫 문장에 'Acme Inc.' 를 반드시 언급, 없으면 자동 incorrect" 처럼 쓴다 [4.2③]
한 사용 사례의 한 기준에도 rubric 이 여러 개 필요할 수 있다. 모호한 rubric 은 일관성 없는 판정을 낳는다
-
출력 : 정해진 값만 받는다. correct/incorrect 또는 1~5 척도다. 순수 정성 평가는 빠르게, 대량으로 재지 못한다 [4.2③]
-
먼저 추론 : judge 가 먼저 추론하게 한다. 추론은 버리고 점수만 쓴다. 그러면 복잡한 판단에서 채점 성능이 오른다 [4.2③]
공식 예는
<thinking>에 추론을 쓰고,<result>에 correct/incorrect 를 쓴다. 코드는<result>만 읽는다Skilljar 는 강점·약점·추론을 점수와 함께 요구한다. 이것이 없으면 점수가 6 근처 중간 점수로 쏠린다 (Skilljar)
-
탈출구 : 환각(hallucination)을 막으려고 지시를 넣는다. 정보가 모자라면 "Unknown" 을 돌려주라고 한다 [4.2③]
-
차원 : 차원마다 구조화된 rubric 을 둔다. 차원마다 따로 떼어낸 judge 가 도움될 수 있다(한 judge 로 전부 보지 않고) [4.2③]
단 리서치 글은 여러 judge 를 시험했다. 그 끝에 한 호출 · 한 프롬프트(0.0~1.0 점수 + 통과/실패)가 가장 일관되고 사람 판정과 맞았다
그래서 둘 다 공식 문서에 있다. 가르는 기준은 사람과 더 맞는 쪽이다
-
채점 모델 : 답을 만든 모델과 다른 모델로 채점하는 것은 "일반적으로" 모범 사례다 [4.2③]
공식 예시 코드도 생성과 채점에 같은 모델 id 를 쓴다. 그래서 절대 규칙이 아니다
-
보정 : LLM judge 를 사람 전문가와 꼼꼼히 맞춰 본다. 그러면 사람 채점과 모델 채점의 차이가 작다는 확신을 얻는다 [4.2③]
튼튼해지면 사람 검토는 가끔만 한다. 주관적인 리서치 품질은 전문가 판정과 자주 보정한다. Descript 는 제품팀이 정한 기준을 쓰고 주기적으로 사람과 보정한다
-
grader 점검 : transcript 와 점수를 읽어야 grader 가 제대로인지 알 수 있다. 실패마다 에이전트 실수인지, grader 가 맞는 답을 거절했는지 가린다 [4.2③]
우회와 꼼수에 강하게 만든다. 진짜로 풀었을 때만 통과해야 한다. 예를 들어 CORE-Bench 에서는 채점 버그 등을 고치자 점수가 42% 에서 95% 로 올랐다
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
| judge 에 기준을 준다 | 자세하고 명확한 rubric 을 준다 | develop-tests "Have detailed, clear rubrics" |
| judge 출력을 정한다 | correct/incorrect 또는 1~5 로 받는다 | develop-tests |
| 복잡한 판단이다 | 먼저 추론하게 한다. 추론은 버리고 점수만 쓴다 | develop-tests |
| 정보가 모자랄 수 있다 | "Unknown" 탈출구를 준다 | demystifying-evals |
| 차원이 여럿이다 | 차원별 rubric 을 둔다. 따로 떼어낸 judge 가 도움될 수 있다 | demystifying-evals (단 리서치 글은 한 호출이 더 일관됐다. 뒤집히는 때 1) |
| 채점 모델을 고른다 | 생성 모델과 다른 모델이 일반적 모범 사례다 | define-success-full (코드 주석) |
| 규모를 늘리기 전이다 | 사람 전문가와 꼼꼼히 맞춰 본다 | demystifying-evals · develop-tests |
| 안정된 뒤다 | 사람 검토는 가끔만 한다 | demystifying-evals |
| 주관적 과제(리서치 품질)다 | 전문가 판정과 자주 보정한다 | demystifying-evals |
| 점수가 이상하다 | transcript 와 점수를 읽는다 | demystifying-evals |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 과제의 주관성 | 높다(리서치 종합 · 공감) | 자주 보정한다 | demystifying-evals | |
| 과제의 주관성 | 정답이 분명하다(목록 맞히기) | 한 judge 로 정답 여부만 봐도 효과적이다 | multi-agent-research-system | |
| 차원 수 | 여럿이다 | 차원별 judge 또는 한 호출 중 사람과 더 맞는 쪽을 쓴다 | 미해결 | 뒤집히는 때 1 |
| 보정 상태 | 아직이다 | 전체에 돌리기 전에 사람 표본과 맞춘다 | develop-tests | |
| 보정 상태 | 안정됐다 | 사람은 가끔만 본다 | demystifying-evals | |
| 채점 모델 | 생성 모델과 같다 | 흠이지만 결정타는 아니다. 보정이 먼저다 | define-success-full | |
| 출력 형태 | 자유 글 평가다 | 정해진 값으로 바꾼다 | develop-tests | |
| 점수 쏠림 | 다 6점 근처다 | 강점·약점·추론을 함께 요구한다 | Skilljar 287742 | |
| 비용 | judge 호출 수가 차원 수만큼 늘어난다 | 계산해 보고 정한다 | 계산 | 뒤집히는 때 1 |
연습 문제
고객지원 답을 채점하는 LLM judge 가 채점에 필요한 주문 정보가 transcript 에 없는 답까지근거 모자람 전부 correct/incorrect 로 자신 있게 판정한다. 팀원은 답을 만든 모델과 다른 모델로 judge 를 바꾸면 해결된다고 한다. judge 프롬프트에 무엇을 더할까?
시험 대비
함정
- 답을 만든 모델이 스스로 채점하는 것은 함정이다. 다른 모델로 채점하는 것이 일반적 모범 사례다. 단 "다른 모델" 만 붙은 보기를 자동으로 정답으로 고르지 않는다. 보정과 rubric 이 빠졌는지 먼저 본다
- "한 judge 로 모든 차원을 보면 늘 오답이다" 는 함정이다. 따로 떼는 것은 "도움될 수 있다" 수준이다. 한 호출이 더 일관된 사례도 공식 문서에 있다
- regex 로 공감을 판정하는 것은 함정이다. 뉘앙스를 못 본다. 자세한 것은 ■ grader 고르기 에 있다
- 사람만 전수 검토하는 것은 함정이다. 가능하면 피한다
- 근거가 모자라도 확신 판정하는 것은 함정이다. 탈출구가 없으면 환각 판정이 나온다. "Unknown" 을 준다
- 추론 없이 점수만 바로 내는 것은 함정이다. 복잡한 판단에서 성능이 떨어진다
- "좋은지 설명해 줘" 같은 순수 정성 평가는 함정이다. 빠르게, 대량으로 재지 못한다
- 사람과 한 번 맞춘 뒤 영영 안 보는 것은 함정이다. 주관적일수록 자주 보정한다
신호
"Have detailed, clear rubrics"
"instruct the LLM to output only 'correct' or 'incorrect', or to judge from a scale of 1–5."
"Ask the LLM to reason first before producing an evaluation score, and then discard the reasoning."
"Generally best practice to use a different model to evaluate than the model used to generate the evaluated output"
"LLM-as-judge graders should be closely calibrated with human experts to gain confidence that there is little divergence between the human grading and model grading."
"To avoid hallucinations, give the LLM a way out, like providing an instruction to return “Unknown” when it doesn’t have enough information."
"grade each dimension with an isolated LLM-as-judge rather than using one to grade all dimensions."
"Once the system is robust, it’s sufficient to use human review only occasionally."
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
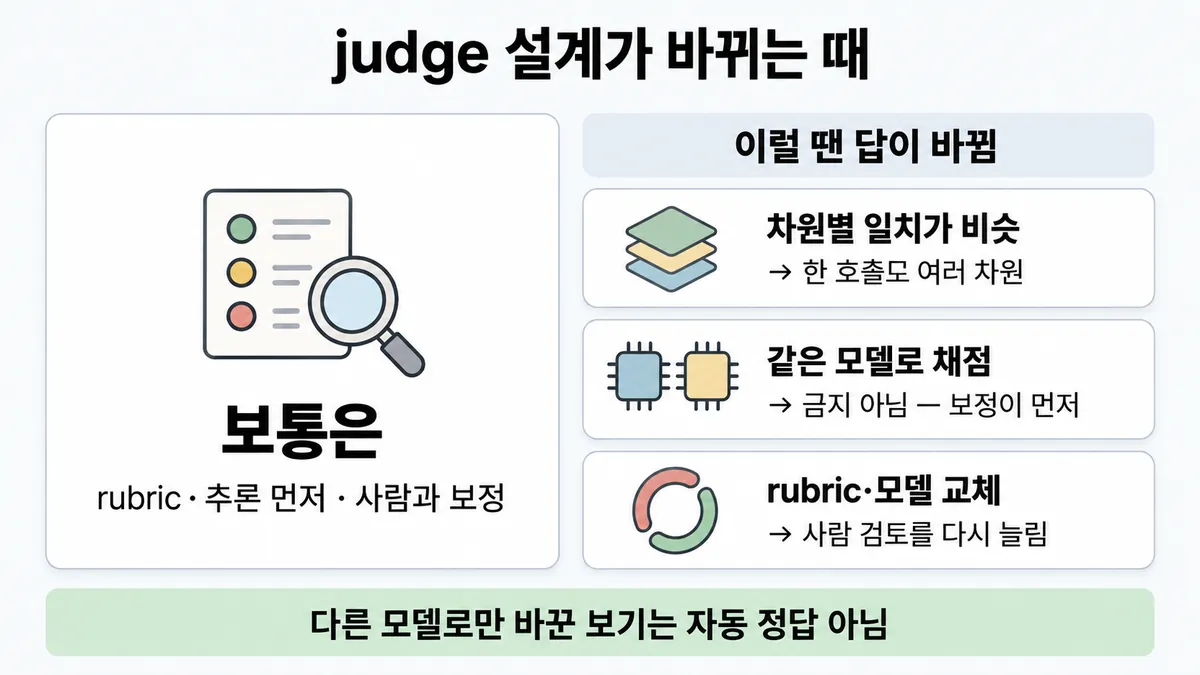
1. 차원별 judge 가 오히려 손해인 때
- 조건 : 답이 2,400건이다. 볼 차원은 3개다(공감 · 정확성 · 정책 준수). Haiku 4.5 로 채점한다.
- 계산 : 차원별 = 2,400 × 3 호출 × (입력 1,100 × $1 + 출력 200 × $5) / 1M = $15.12 다. 한 호출 = 2,400 × (입력 1,400 × $1 + 출력 350 × $5) / 1M = $7.56 이다. 차원별이 약 2배다.
- 전제 : 토큰 수는 가정이다. 가격은 2026-09-28 조회값이다(ko-pricing). 캐시·배치 할인은 뺀다.
- 판단 : 사람 보정 표본에서 두 방식의 일치를 잰다. 차원별이 더 맞으면 2배 비용을 감수한다. 비슷하면 한 호출을 쓴다. 리서치 글은 한 호출이 더 일관됐다고 했다.
- 등급 : 계산 (가격은 확인) · 어느 쪽이 맞는지는 미해결
- 근거 : demystifying-evals · multi-agent-research-system · ko-pricing
2. 같은 모델로 채점해도 되는 때
- 조건 : 생성과 채점을 같은 모델로 한다.
- 판단 : 공식은 "일반적으로" 다른 모델을 권한다. 그러나 같은 문서의 예시 코드는 생성과 채점에 같은 모델 id 를 쓴다. 그래서 금지는 아니다. 보기 중 "다른 모델로 바꿈"만 있고 보정·rubric 이 없으면, "같은 모델 + 사람 보정" 보기가 더 나을 수 있다.
- 등급 : (문장·예시) · 추론 (보기 비교)
- 근거 : define-success-full
3. 추론을 버리면 grader 점검은 어떻게?
- 조건 : judge 추론을 버렸는데 점수가 이상하다.
- 판단 : "버린다"는 점수 집계에서 뺀다는 뜻이다. grader 를 점검할 때는 transcript 와 점수를 읽는다. judge 추론도 그때 읽을 재료가 될 수 있다.
- 등급 : (버림 · transcript 읽기) · 추론 (judge 추론을 점검에 쓰기)
- 근거 : develop-tests · demystifying-evals
4. 사람 검토를 "가끔"에서 다시 늘릴 때
- 조건 : 보정이 끝나 사람 검토를 가끔으로 줄였다. 그런데 rubric 을 바꾸거나 judge 모델을 바꾼다.
- 판단 : 공식 문장은 "튼튼해지면 가끔"까지만 말한다. 바뀐 judge 가 여전히 튼튼한지는 다시 맞춰 봐야 알 수 있다.
- 등급 : 업계 일반 (공식 문장이 없다)
- 근거 : demystifying-evals
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 근거 |
|---|---|---|---|
| "답을 만든 모델이 스스로 채점" | 한 번에 끝나 편하다 | 다른 모델이 일반적 모범 사례다. 더 큰 결함은 보정이 없다는 것이다 | define-success-full · demystifying-evals |
| "judge 하나로 모든 차원을 한꺼번에 보면 늘 오답" | demystifying 이 따로 떼기를 권한다 | 그 권고는 "도움될 수 있다" 수준이다. 한 호출이 더 일관된 공식 사례도 있다 | demystifying-evals · multi-agent-research-system |
| "regex 로 공감을 판정" | 빠르고 싸고 재현된다 | 뉘앙스를 못 본다. 표현만 다른 맞는 답도 틀림 처리한다 | demystifying-evals |
| "사람이 모든 답을 전수 검토" | 가장 믿을 만해 보인다 | 가능하면 피한다. 사람은 보정과 가끔 하는 검토에 쓴다 | develop-tests · demystifying-evals |
| "근거가 부족해도 반드시 판정하게" | 빈칸 없는 결과표가 나온다 | "Unknown" 탈출구가 없으면 환각 판정이 나온다 | demystifying-evals |
| "점수만 바로 출력하게(추론 없이)" | 토큰이 줄어 보인다 | 추론을 먼저 하면 복잡한 판단에서 성능이 오른다 | develop-tests |
| "judge 에게 품질을 자유롭게 서술하게" | 피드백이 풍부해 보인다 | 순수 정성 평가는 빠르게, 대량으로 재지 못한다 | develop-tests |
| "judge 점수를 그대로 믿고 transcript 는 안 읽음" | 자동화의 목적처럼 보인다 | 채점 버그가 점수를 깎는다(고친 뒤 42% 에서 95%) | demystifying-evals |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 4.2 공식 시험 가이드 v1.0
- docs develop-tests
- demystifying-evals
- multi-agent-research-system
- Skilljar API 287742
상태
- 공식 문서끼리 갈림 1곳(⑤ 차원별 vs 한 호출)
미해결
- 차원별 judge(demystifying-evals "can also help")와 한 호출(multi-agent-research-system "most consistent")로 두 공식 글이 갈린다. 시험이 "한 judge 로 모든 차원"을 오답으로 둘지 모른다. 목록 4.2③ 은 이것을 "매력적인 오답"으로 적었다. 그래서 카드는 "늘 오답"으로 쓰지 않는다.
- 보정 표본 크기와 일치율 기준은 공식 숫자가 없다. (책 템플릿
4-2-graders.html의 "표본 50건"도 공식 숫자가 아니다) - "다른 모델"이 다른 회사 모델인지, 같은 계열의 다른 크기인지 원문에 없다(define-success-full 주석뿐이다).
- 목록 4.2③ 의 "영어 신호" 3개는 모두 원문에서 찾았다(develop-tests · define-success-full · demystifying-evals). 단 "Generally best practice…" 는 본문이 아니라 코드 주석이다.