■ impact metrics
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 1.6 비즈니스 가치 축 맞추기 · D1 설계 17%Align solutions to business value pillars (efficiency, transformation, productivity, cost, performance SLAs)
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 1.6② 도입 효과를 무엇으로 증명하나? — 과제 성능 지표와 사업 영향 지표를 나눠 목표치 정하기
- 1.6① 이 설계의 가치를 어느 축으로 말하나? — 가치 축 짝짓기 — 효율·전환·생산성·비용·성능 SLA
한눈에
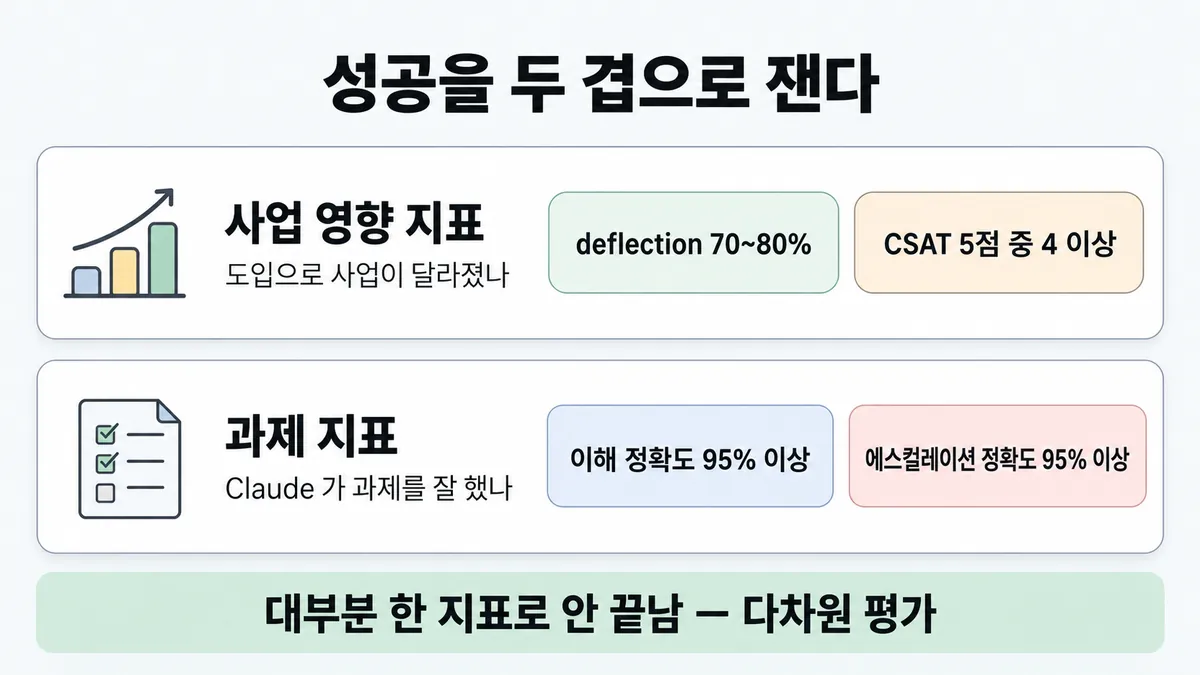
"잘 됐다"를 두 겹으로 측정한다.
- 과제 지표 : Claude 가 맡은 과제를 얼마나 잘 하나?
- 사업 영향 지표 : 도입해서 사업에 무엇이 달라졌나?
둘 다 측정 가능한 목표치를 미리 정한다. 목표치는 지원 팀과 같이 정한다
대부분 한 지표로 끝나지 않는다. 그래서 여러 성공 기준(success criteria)으로 다차원 평가를 한다
비유 SLO 대시보드와 같다. 서비스 안쪽 지표(오류율·지연(latency))와 사업 지표(주문·이탈)를 따로 건다. 가용성 하나로 "성공"이라 하지 않는다
ELI5
새 직원을 뽑고 "잘하나?"를 볼 때 두 가지를 따로 봐요.
- 하나는 맡긴 일을 제대로 하나예요. 주문을 맞게 받았나, 모를 땐 선배를 불렀나.
- 다른 하나는 가게가 나아졌나예요. 손님이 덜 기다리나, 만족했나.
- "손님 반응이 좋았어요" 같은 말로는 못 정해요. 숫자를 미리 정해 둬야 해요.
- 숫자 하나만 보면 속아요. 여러 개를 같이 봐요.
개념 설명
원리
두 겹
- 과제 지표는 Claude 가 맡은 과제 하나하나를 잘 하나를 잰다. 대화 표본 검토와 LLM 채점으로 잰다. 과제 지표는 어디가 깨졌는지를 알려 준다.
- 사업 영향 지표는 도입해서 사업이 달라졌나를 잰다. 사업 영향 지표는 넓힐지 말지를 정하는 데 쓴다. 아래 넷이 여기에 든다.
- 사람 없이 끝난 비율(deflection)
- 만족도(CSAT)
- 처리 시간(AHT)
- 감정 유지
- 과제 지표가 좋아도 사업 지표가 안 오를 수 있다. 사업 지표만 보면 원인을 못 찾는다 (업계 일반). 그래서 두 겹을 같이 건다.
목표치는 만들기 전에
- 공식 고객지원 가이드의 순서는 과제 정의, 성공 기준(success criteria) 수립, 구현이다. 성공 기준은 지원 팀과 같이 정하고 측정 가능한 벤치마크를 붙인다.
- 좋은 기준은 4가지를 갖춘다. 구체적이고, 측정 가능하고, 달성 가능하고, 관련성이 있어야 한다. "달성 가능"의 기준은 업계 벤치마크, 이전 실험, 현재 프런티어 모델 역량이다.
- 모호한 것도 숫자로 바꾼다 (안전 = 10,000회 중 유해 플래그 0.1% 미만).
여러 차원
- 대부분 한 지표로 끝나지 않는다. 그래서 정확도, 무해성, 응답 시간처럼 여러 기준을 한 목표에 묶는다.
- 흔한 기준 목록에 지연(latency)과 가격도 들어간다. 비용은 ■ per-request cost 에 있다. 지연은 ■ 지연 줄이기 lever 에 있다.
목표치의 성격
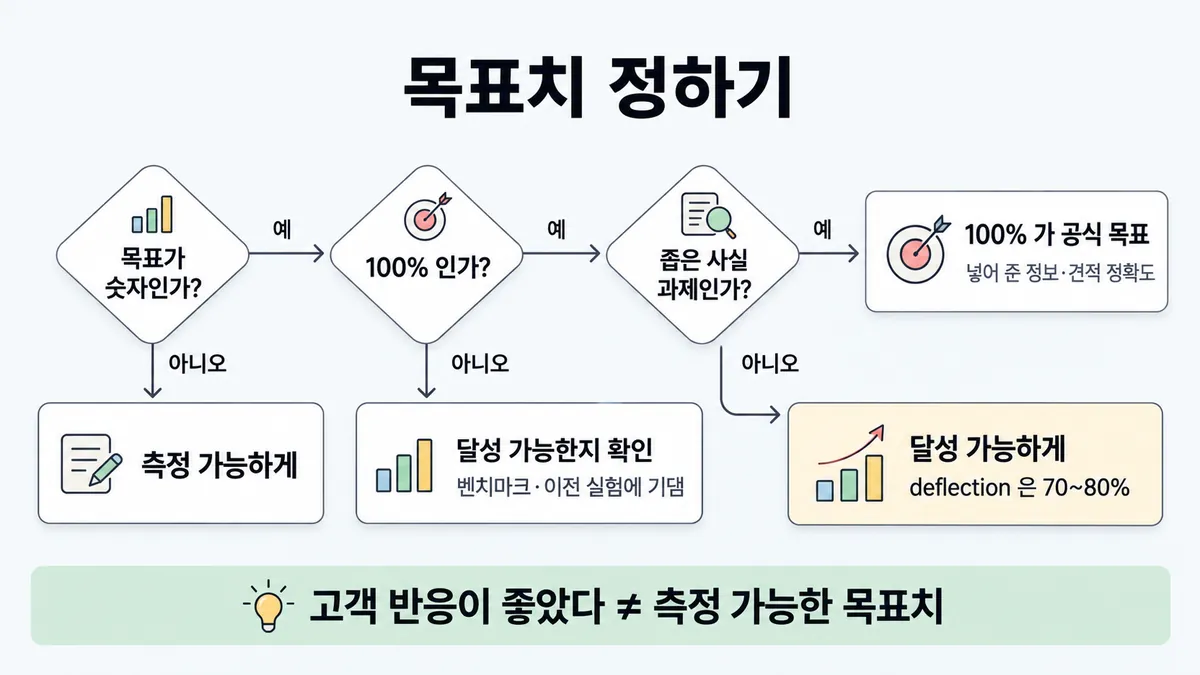
- 좁은 사실 과제(프롬프트에 넣어 준 회사·상품 정보, 견적)는 100% 가 공식 목표다.
- 사람 판단에 좌우되는 결과(deflection 등)는 문의 복잡성에 따라 70~80% 다. 그래서 100% 가 아니다.
규칙과 판단
갈림길
①② 어느 겹의 지표 [1.6②]
과제 지표
목표는 문의 이해 정확도 95% 이상, 응답 관련성 90% 이상, 주제 준수 95%, 에스컬레이션 정확도 95% 이상이다
사업 영향 지표
감정 유지 90%, deflection 보통 70~80%, CSAT 5점 중 4 이상을 목표로 잡는다. AHT 는 사람 상담원보다 낮게 잡는다
③ 목표치 정하기 [1.6②]
측정 가능하게 만든다
정량 지표나 잘 정의된 정성 척도를 쓴다. '안전'처럼 모호한 것도 숫자로 바꾼다
100% 가 공식 목표다
응답 정확도와 콘텐츠 생성 효과성은 100% 가 목표다
달성 가능하게 고친다
deflection 은 보통 70~80% 를 목표로 잡는다 (문의 복잡성에 따라). 목표는 현재 프런티어 모델 역량에 비해 비현실적이면 안 된다
달성 가능하게 잡는다
업계 벤치마크, 이전 실험, AI 연구, 전문가 지식에 기댄다
나머지 규칙
-
여러 지표 함께 : 대부분은 다차원으로 평가한다
흔한 기준은 아래와 같다
- 과제 충실도
- 일관성
- 관련성·논리
- 톤·스타일
- 개인정보 보호
- 맥락 활용
- 지연
- 가격
운영 지표는 응답 시간(ms)과 가동률(%)이다
감정 분석 예는 F1 0.85 이상, 99.5% 무해, 응답 95% 가 200ms 미만이다
가격 차원은 ■ per-request cost 에 있다. 지연 차원은 ■ 지연 줄이기 lever 에 있다
-
짝으로 본다 : deflection 은 에스컬레이션 정확도와 짝이다. AHT 는 CSAT 와 짝이다 업계 일반 네 지표는 공식 목록에 다 있다. 그러나 "한쪽을 올리면 다른 쪽이 내려간다"는 문장은 공식에 없다 [1.6②]
-
value pillars 에 건다 : deflection 과 AHT 는 효율·비용 쪽이다. 응답 시간과 가동률은 성능 SLA 쪽이다 (업계 일반 짝짓기 — 가이드는 5축 이름만 준다) [1.6①]
규칙 원문 ①②③ (갈림길로 그린 규칙)
-
과제 지표는 Claude 가 과제를 잘 했나를 잰다 (고객지원 예의 공식 목표치) [1.6②]
요약하면 문의 이해 정확도 95% 이상, 응답 관련성 90% 이상, 주제 준수 95%, 에스컬레이션 정확도 95% 이상이다
지표 재는 법 목표 문의 이해 정확도 (query comprehension accuracy) 대화 표본을 검토한다. 의도·다음 단계·해결 모습을 맞게 읽었나? 95% 이상 응답 관련성 (response relevance) 대화 묶음을 채점한다. 규모를 키울 때는 LLM 채점을 쓴다 90% 이상 응답 정확도 (response accuracy) 프롬프트에 넣어 준 회사·상품 정보가 맞나? 100% 인용 제공 관련성 (citation provision relevance) 링크·출처를 주는 빈도와 관련성을 본다 도움 될 상호작용의 80% 주제 준수 (topic adherence) 응답이 주제(예 자동차 보험) 안에 있나? 95% 콘텐츠 생성 효과성 (content generation effectiveness) 견적을 언제 내야 하는지 아나? 견적이 맞나? 100% 에스컬레이션 효율성 (escalation efficiency) 제대로 넘긴 대화와 넘겨야 했는데 안 넘긴 대화를 추적한다 에스컬레이션 정확도 95% 이상 -
사업 영향 지표는 도입으로 사업이 달라졌나를 잰다 [1.6②]
요약하면 감정 유지 90%, deflection 보통 70~80%, CSAT 5점 중 4 이상을 목표로 잡는다. AHT 는 사람 상담원보다 낮게 잡는다
지표 재는 법 목표 감정 유지 (sentiment maintenance) 대화 시작과 끝의 감정을 분석한다 90% 에서 유지하거나 개선한다 deflection rate 사람 개입 없이 챗봇이 처리한 문의 비율 70~80% (문의 복잡성에 따라) CSAT (customer satisfaction score) 상호작용 뒤에 설문한다 5점 중 4 이상 평균 처리 시간 (AHT, average handle time) 문의 해결까지 걸린 평균 시간 사람 상담원보다 낮게 (복잡성에 따라 크게 다르다) ⚠ 한국어판은 deflection rate 를 "전환율"로 옮긴다. 이 말은 value pillars(핵심 가치 항목)의 "전환(transformation)" 과 다른 말이다
-
좋은 성공 기준은 4가지다. Specific, Measurable, Achievable, Relevant 다 [1.6②]
- 구체적 : "좋은 성능" 대신 "정확한 감정 분류" 처럼 쓴다
- 측정 가능 : 정량 지표나 잘 정의된 정성 척도를 쓴다. 정성 척도는 정량 지표와 함께 일관되게 쓸 때 가치가 있다. '안전'처럼 모호한 것도 숫자로 바꾼다 (10,000회 중 유해 플래그 0.1% 미만)
- 달성 가능 : 업계 벤치마크, 이전 실험, AI 연구, 전문가 지식에 기댄다. 현재 프런티어 모델 역량에 비해 비현실적이면 안 된다
- 관련성 : 앱 목적과 사용자 요구에 맞춘다. 인용 정확도는 의료 앱에는 중요하고, 일상 챗봇에는 덜 중요하다
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
| 시범 결과가 "반응 좋았다" 같은 말뿐이다 | 측정 가능한 목표치를 먼저 정한다 | define-success · customer-support-chat |
| Claude 가 과제를 잘 했나를 봐야 한다 | 과제 지표를 쓴다 (이해 95% · 관련성 90% · 주제 95% · 에스컬레이션 95%) | customer-support-chat |
| 도입 효과를 사업에 보고한다 | 사업 영향 지표를 쓴다 (감정 90% · deflection 70~80% · CSAT 4/5 · AHT 사람보다 낮게) | customer-support-chat, "evaluate the business impact of employing Claude for support" |
| 자동 해결률 목표를 정한다 | 70~80% 로 잡는다. 문의가 복잡하면 낮게 잡는다 | customer-support-chat "Typically aim for 70-80% deflection rate, depending on the complexity of inquiries." |
| 프롬프트에 넣어 준 정보와 견적의 정확도 목표를 정한다 | 100% 다 | customer-support-chat |
| 목표가 모델 능력보다 높다 | 달성 가능하게 낮춘다 | define-success en-full "should not be unrealistic to current frontier model capabilities" |
| 지표 하나로 성공을 약속한다 | 여러 기준으로 다차원 평가를 한다 | define-success en-full "Most use cases need multidimensional evaluation along several success criteria." |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 문의 복잡성 | 단순하고 반복이 많다 | deflection 목표를 위쪽(80% 쪽)으로 잡는다 | customer-support-chat (복잡성에 따라) ·(반복 문의 많음 = 도입 신호) | |
| 문의 복잡성 | 분쟁과 예외가 많다 | deflection 목표를 아래쪽으로 잡는다. 에스컬레이션 정확도가 더 중요하다 | 업계 일반 | 복잡성에 따른 조정 방향만 공식이다 |
| 결정권자가 묻는 것 | "넓혀도 되나" | 사업 영향 지표를 본다 | customer-support-chat | |
| 결정권자가 묻는 것 | "어디가 틀리나" | 과제 지표를 본다 | 업계 일반 | 과제별로 나눠야 과제마다 평가한다 (customer-support-chat) |
| 과제 성격 | 프롬프트에 넣어 준 사실만 말한다 | 100% 를 목표로 둔다 | customer-support-chat | |
| 과제 성격 | 사람 판단에 좌우되는 결과다 | 100% 가 아니다 | deflection 70~80% | |
| 앱 종류 | 의료처럼 틀리면 큰일이다 | 인용 정확도 비중이 크다 | define-success | |
| 규모 | 대화가 아주 많다 | 응답 관련성은 LLM 채점으로 규모를 늘린다 | customer-support-chat |
연습 문제
자동차 보험 챗봇 도입안에 "견적 금액 정확도 100%" 와 나란히 "문의 100% 를 사람 없이 끝낸다"100% 목표가 적혀 있다. 뒤쪽 숫자는 사람 개입 없이 챗봇이 처리한 문의 비율자동 해결률을 말한다. 이 뒤쪽 목표를 어떻게 고칠까?
시험 대비
함정
- "100% 자동 해결을 목표로 한다" 는 함정이다. deflection 공식 목표는 보통 70~80% 다. 목표는 달성 가능해야 한다
- 반대쪽 함정도 있다. "100% 목표는 늘 오답이다" 는 함정이다. 프롬프트에 넣어 준 회사·상품 정보와 견적 정확도는 공식 목표가 100% 다
- "deflection 만 올리면 성공이다" 는 함정이다. 에스컬레이션 정확도를 같이 보지 않으면, 챗봇이 사람에게 넘겨야 할 대화를 붙잡아도 deflection 숫자는 좋아 보인다 업계 일반
- "고객 반응이 좋았다" 로 확대를 결정하는 것은 함정이다. 측정 가능한 목표치가 없다
- 과제 지표만 보고 사업 효과를 말하는 것은 함정이다. 거꾸로 사업 지표만 보면 어느 과제가 깨졌는지 모른다. 두 겹을 다 본다 업계 일반
- 한국어판 "전환율" 을 value pillars 의 "전환" 으로 읽는 것은 함정이다. "전환율" 은 deflection rate 다
- 성공 기준을 "SMART 5가지(기한 포함)" 로 보는 것은 함정이다. 공식은 4가지(Specific · Measurable · Achievable · Relevant)다
신호
"Here are criteria and benchmarks that can be used to evaluate the business impact of employing Claude for support:"
"Typically aim for 70-80% deflection rate, depending on the complexity of inquiries."
"Aim for a CSAT score of 4 out of 5 or higher."
"Aim for an escalation accuracy of 95% or higher."
"Most use cases need multidimensional evaluation along several success criteria."
"Your success metrics should not be unrealistic to current frontier model capabilities."
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
1. deflection 이 올랐는데 실패인 때
- 조건 : deflection 을 끌어올리려고 사람에게 넘기는 기준을 느슨하게 했다.
- 계산 : 월 2만 5천 건 중 사람이 꼭 봐야 할 문의를 16%(4,000건)로 둔다. 에스컬레이션 정확도가 95% 면 못 넘긴 대화는 200건이다. 86% 로 떨어지면 560건이다. 그러면 사람이 필요한 고객 360명이 더 챗봇에 묶인다. 그런데 deflection 숫자는 오히려 올라간다.
- 전제 : 에스컬레이션 정확도를 넘겨야 할 대화 중 제대로 넘긴 비율로 본다. 공식은 "제대로 넘긴 대화 vs 넘겨야 했는데 안 넘긴 대화"를 추적하라고만 쓴다.
- 등급 : 계산. 두 지표를 같이 걸라는 방향은 공식 다차원 원칙과 같다. "한쪽을 올리면 다른 쪽이 내려간다"는 문장 자체는 공식에 없다(업계 일반).
- 근거 : customer-support-chat · define-success en-full
2. 100% 목표가 맞는 때
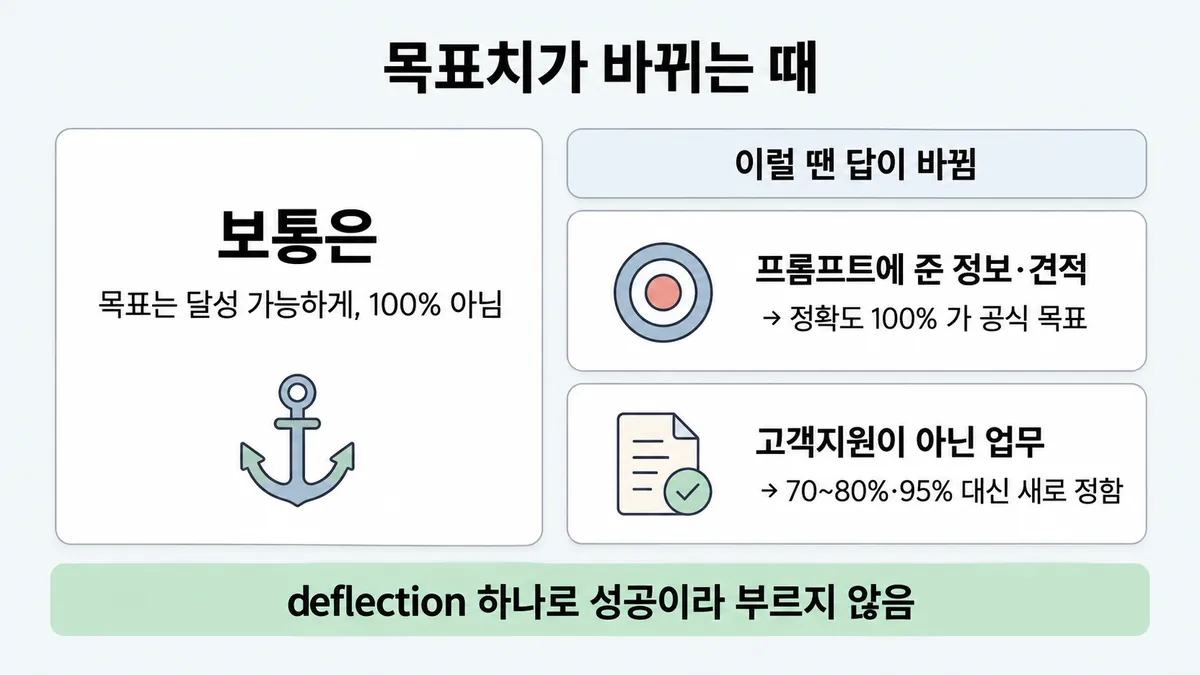
- 조건 : 지문이 좁은 사실 과제의 정확도를 묻는다. "프롬프트에 넣어 준 회사 정보" 나 "견적 금액" 같은 과제다.
- 판단 : 공식 목표가 100% 다. "100% 는 비현실이니 오답"으로 외우면 여기서 틀린다. 100% 가 오답인 것은 자동 해결률처럼 사람 판단에 좌우되는 결과 쪽이다.
- 근거 : customer-support-chat
3. 공식 목표치를 그대로 쓰면 안 되는 때
- 조건 : 업무가 고객지원이 아니다 (예 계약서 조항 추출).
- 판단 : 70~80% · 4/5 · 95% 는 고객지원 예의 벤치마크다. 다른 업무는 업계 벤치마크, 이전 실험, 현재 모델 역량으로 새로 정한다 ("달성 가능").
- 등급 : (원칙) · 다른 업무의 숫자는 공식에 없다
- 근거 : define-success
4. AHT 를 줄였는데 실패인 때
- 조건 : 답을 짧게 끊어 평균 처리 시간을 낮췄다.
- 판단 : AHT 목표는 "사람 상담원보다 낮게"뿐이다. 끊어서 줄이면 CSAT 와 감정 유지가 떨어질 수 있다. 그래서 같이 봐야 한다.
- 등급 : 업계 일반 (두 지표는 공식 목록에 있다. 상충 설명은 없다)
- 근거 : customer-support-chat
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "100% 자동 해결을 목표로" | 높은 목표가 좋아 보인다 | deflection 공식 목표는 70~80% 다. 현재 모델 역량에 비해 비현실적이면 안 된다 | customer-support-chat · define-success en-full | |
| "100% 목표 보기는 늘 오답" | 위 오답의 반대로 외웠다 | 프롬프트에 넣어 준 정보와 견적 정확도는 공식 목표가 100% 다 | customer-support-chat | |
| "deflection 만 올리면 성공" | 인건비 절감이 바로 보인다 | 에스컬레이션 정확도를 같이 보지 않으면, 챗봇이 사람에게 넘겨야 할 대화를 붙잡아도 deflection 숫자는 좋아 보인다 | 업계 일반 | 뒤집히는 때 1 |
| "시범 운영 반응이 좋았으니 확대" | 현장 목소리가 설득력 있다 | 측정 가능한 목표치가 없어 판단할 수 없다 | define-success | |
| "정확도 지표 하나로 도입 성공 판정" | 숫자 하나가 깔끔하다 | 대부분은 다차원으로 평가한다. 사업 영향은 따로 측정한다 | define-success en-full · customer-support-chat | |
| "성공 기준 = SMART 5가지" | 흔한 목표 설정 틀이다 | 공식은 4가지(Specific · Measurable · Achievable · Relevant)다. 기한(T)은 없다 | define-success (목록의 "SMART → 공식 4가지" 경고) | |
| "전환율이 올랐으니 value pillars(핵심 가치 항목)의 '전환' 달성" | 한국어판 번역이 같은 말이다 | 한국어판 "전환율" 은 deflection rate 다. value pillars 의 transformation 과 다른 말이다 | customer-support-chat | |
| "지표는 만든 뒤 운영하며 정함" | 일단 띄우고 보는 습관이다 | 공식 순서는 과제 정의, 성공 기준, 구현이다 | customer-support-chat 순서 |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 1.6 공식 시험 가이드 v1.0
- customer-support-chat-full
- define-success
상태
- 업계 일반 2줄(⑤ 짝 · ⑥ value pillars 짝짓기) + 함정 2줄
미해결
- 사업 영향 지표 4개를 가이드 5축(효율 · 전환 · 생산성 · 비용 · 성능 SLA)에 짝짓는 공식 문장은 없다. 그래서 카드 ⑥ 은 업계 일반이다.
- ROI 계산 공식은 API docs 에 없다. Claude Code 쪽 ROI 측정 가이드 링크만 있다(en-monitoring-usage, 이 카드 범위 밖).
- 목록 1.6② 의 영상 예시 '40% 해결' · '35% 자동 해결' 은 공식 원문에 없다. 그래서 쓰지 않는다.
- 한국어 시험지가 deflection 을 어떤 말로 쓸지 모른다 (한국어판 docs 는 "전환율").
- 고객지원 밖 업무의 공식 목표치는 없다 (뒤집히는 때 3).