◆ TTFT vs 응답 완료 지연
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 4.1 평가 지표 정하기 · D4 평가 16%Define evaluation metrics (accuracy, latency, cost, safety, security)
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 4.1② 첫 토큰은 빨라졌는데 "여전히 느리다"고 한다 — 지연 지표 고르기 (TTFT vs 응답 완료까지)
- 3.3① 상담원이 "답 초안이 늦게 뜬다"고 한다 — 모델부터 바꾸나? — 지연 lever 고르기 (스트리밍 · 캐싱 · 출력 길이 · effort · 모델 교체)
한눈에
ELI5
택배를 시켰을 때 "출발했어요" 문자가 빨리 오는 것과, 상자가 집에 다 도착하는 것은 다른 일이에요.
- 문자가 빨리 오면 덜 답답해요. 이게 첫 글자까지의 시간이에요.
- 그래도 상자가 늦게 오면 기다리는 건 똑같아요.
- 상자가 많을수록 다 오는 데 오래 걸려요.
- 그래서 둘을 따로 재야 어디가 느린지 알아요.
개념 설명
원리
두 지표
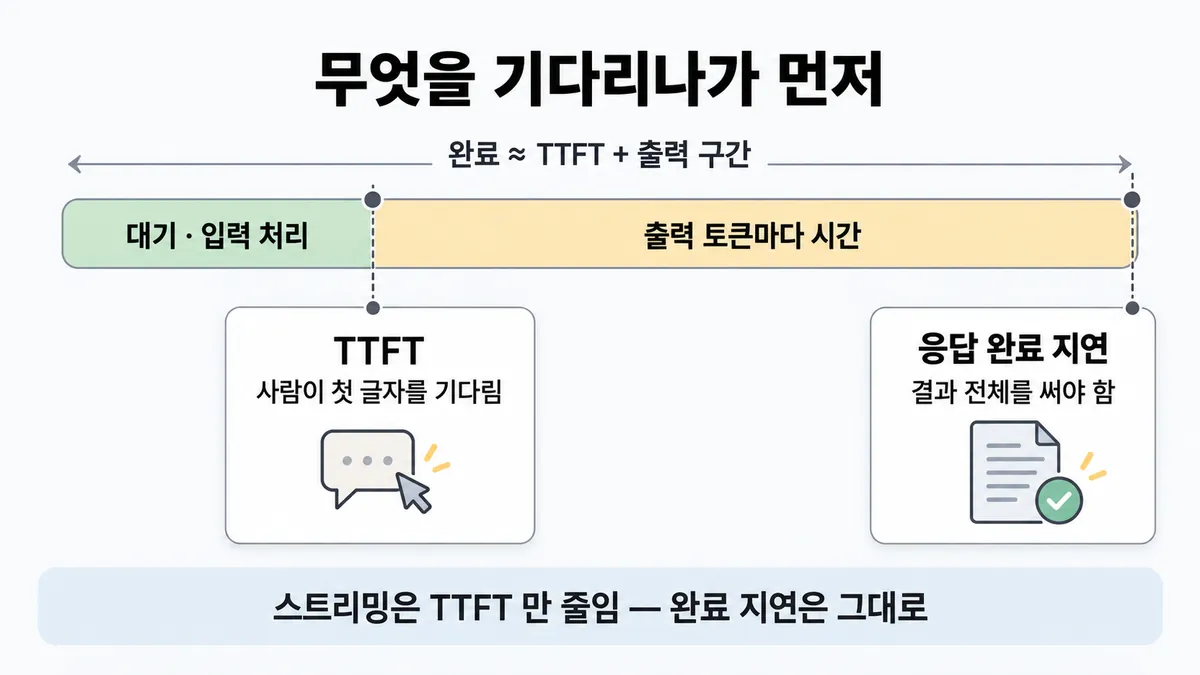
- TTFT : 프롬프트를 보낸 뒤 첫 토큰이 나올 때까지의 시간이다. 대기열 + 입력 처리(prefill) 구간이다.
- 응답 완료 : 마지막 토큰까지의 시간이다. TTFT 에 출력 토큰을 하나씩 만드는 시간(decode)을 더한 것이다.
- OTel 정의를 거꾸로 풀면 완료 ≈ TTFT + 출력 토큰 수 × 토큰당 시간이다 (계산).
- 그래서 TTFT 는 입력 쪽(프롬프트 복잡성 · 모델 · 네트워크)에 좌우된다. 완료는 거기에 출력 길이까지 얹혀 좌우된다. 공식 용어집도 TTFT 요인에는 "프롬프트 복잡성"만 넣는다. 지연(latency) 요인에는 "생성된 응답의 복잡성"까지 넣는다.
스트리밍이 바꾸는 것
- 출력이 다 끝나기 전에 보내기 시작한다. 그래서 사용자가 실시간으로 본다. 그 결과 체감(perceived) 반응성이 크게 좋아진다.
- 생성할 토큰 수는 그대로다. 그래서 마지막 토큰 시각도 그대로다 (업계 일반 — 공식은 "perceived"라고만 씀).
- 그래서 스트리밍 뒤에 "TTFT 는 좋아졌는데 여전히 느리다"는 말이 나온다.
어느 지표를 거나
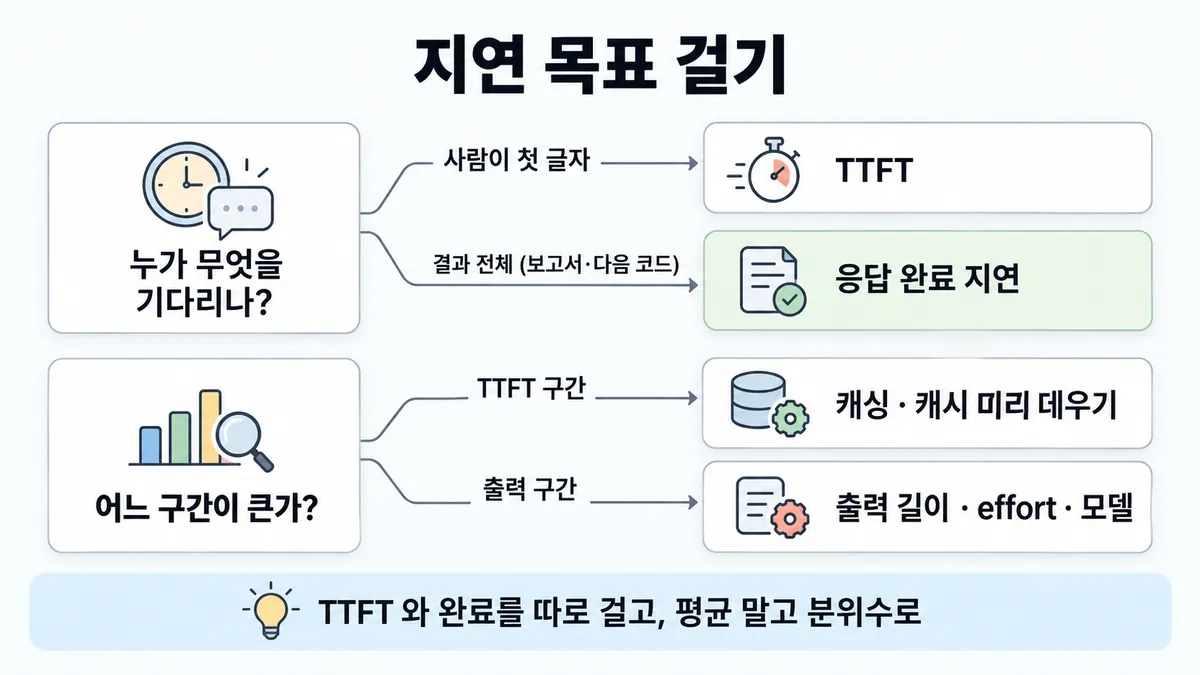
- 기다리는 주체가 기준이다. 사람이 화면에서 첫 글자를 기다리면 TTFT 를 건다. 결과 전체가 필요하면(보고서 · 다음 단계 코드) 완료를 건다.
- 대부분은 둘 다 따로 건다. 공식 eval 예시도 time_to_first_token · output_tokens_per_sec · time_to_last_token 을 나란히 추적한다.
- 숫자는 분위수로 건다 (공식 예 "응답 95% 가 200ms 미만").
핵심 질문 두 개
- 불만이 "시작이 늦다"인가, "끝이 늦다"인가?
- 완료 시간에서 TTFT 구간과 출력 구간 중 어느 쪽이 큰가?
규칙과 판단
갈림길
누가 기다리나 [4.1②]
TTFT
TTFT 는 보낸 뒤 첫 토큰까지의 시간이다. 스트리밍으로 바로 반응하는 느낌을 줄 때 특히 중요하다
응답 완료 지연
응답 완료 지연은 마지막 토큰까지의 시간이다. 출력이 길면 이것만 늘어난다 업계 일반
따로 건다
TTFT 와 완료 지연을 따로 정의하고 따로 측정한다
지표 걸기 [4.1②]
완료도 건다
스트리밍은 TTFT 만 좋게 만든다. 그래서 완료 지연 위반을 가린다 업계 일반
분위수로
공식 예는 "응답 95% 가 200ms 미만" 이다
다음 물음 — 어느 구간이 큰가?
느린 구간 찾기 [4.1②] [3.3①]
캐싱 · 캐시 미리 채우기(warming)
TTFT 를 줄이는 공식 수단이다
출력 길이 · effort · 모델
완료 지연 쪽 수단이다. 자세한 것은 ■ 지연 줄이기 lever 에 있다
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 요청 → 모델 → 화면
규칙 (모델) : 완료 ≈ TTFT + 출력 토큰 수 × 토큰당 시간
질문 : 기다리는 쪽은 무엇을 기다릴까?
① 첫 글자를 기다리는 채팅은 TTFT ✓
- 시작 : 요청 — 말 : “제 주문 어디쯤 왔어요?”
- 보냄 : 요청 → 모델 : 대기열 + 입력 처리(prefill) — 쪽지 : 질문 + 주문 조회 결과
- 첫 토큰 : 모델 → 화면 : 보낸 뒤 첫 토큰까지 = TTFT — 말 : “주문하신…”
- 끝 : 사람이 첫 글자를 기다리는 채팅에는 TTFT 를 건다. 스트리밍으로 바로 반응하는 느낌을 줄 때 특히 중요하다
② 긴 보고서를 TTFT 로만 본다 ≠
- 시작 : 요청 — 쪽지 : "상담 기록으로 / 주간 보고서 써 줘"
- 보냄 : 요청 → 모델 : 입력 처리 — 쪽지 : 상담 기록 + 지시
- 첫 토큰 : 모델 → 화면 : TTFT 대시보드는 좋아졌다 — 쪽지 : TTFT : 1.2초
- 타이머 : 모델 : 출력 토큰마다 시간(decode)
- 마지막 토큰 : 모델 → 화면 : 완료 = TTFT + 출력 구간 (가정 속도) — 쪽지 : 1.2 + 1,800 ÷ 60 / ≈ 31.2초
- 끝 : 스트리밍은 생성량을 안 줄인다. TTFT 만 보면 긴 출력의 완료 지연이 가려진다
③ 둘 다 따로 잰다 ✓
- 시작 : 요청 — 쪽지 : "상담 기록으로 / 주간 보고서 써 줘"
- 보냄 : 요청 → 모델 : 입력 처리 — 쪽지 : 상담 기록 + 지시
- 첫 토큰 : 모델 : 첫 토큰을 따로 잰다 — 쪽지 : time_to_first_token / 1.2초
- 마지막 토큰 : 모델 → 화면 : 완료도 따로 잰다 — 쪽지 : output_tokens_per_sec : 60 / time_to_last_token / 31.2초
- 끝 : TTFT 와 완료 지연을 따로 정의하고 따로 측정한다
규칙 원문 갈림 기준 지표 거는 법 쪼개 보기 (갈림길로 그린 규칙)
갈림 기준
누가 무엇을 기다리나를 먼저 본다
- TTFT 는 프롬프트를 보낸 뒤 응답 첫 토큰이 나올 때까지의 시간이다. 스트리밍으로 바로 반응하는 느낌을 줄 때 특히 중요하다
- 기본 지연(baseline latency)은 모델이 프롬프트를 처리하고 응답을 생성하는 시간이다(초당 토큰은 따로 세지 않는다). 공식 지연 문서의 두 지표는 이것과 TTFT 다
- 응답 완료(time to last token)는 공식 eval 예시가 TTFT · 초당 출력 토큰과 나란히 따로 추적한다
- 사람이 화면에서 첫 글자를 기다리면 TTFT 를 본다. 결과 전체를 써야 하면(긴 보고서 · 다음 단계 코드) 응답 완료 지연을 본다 업계 일반 공식은 두 지표를 정의만 함
- 스트리밍은 출력이 다 끝나기 전에 보내기 시작한다. 그래서 체감(perceived) 반응성을 크게 올린다. 생성 토큰 수는 그대로다. 그래서 완료 지연도 그대로다 (업계 일반, 본문 = ■ 지연 줄이기 lever · 규칙 ①)
- TTFT 를 좌우하는 것은 모델 크기 · 하드웨어 · 네트워크 · 프롬프트 복잡성이다
- 지연(응답 받기까지)을 좌우하는 것은 여기에 생성된 응답의 복잡성까지 더한 것이다
- 그래서 출력이 길면 완료 지연만 늘어난다 업계 일반
쪼개 보기 (OTel GenAI semconv v1.37.0 · 2026-09-28 조회)
gen_ai.server.time_to_first_token= 첫 토큰까지의 시간이다. 대기열과 prefill 단계 시간을 본다. 스트리밍 요청에 특히 중요하다gen_ai.server.request.duration= 요청 시간이다. 마지막 출력 토큰(time-to-last byte)까지 잰다gen_ai.server.time_per_output_token= (요청 시간 − 첫 토큰 시간) ÷ 첫 토큰 뒤 출력 토큰 수다. decode 단계 성능을 본다- 그래서 완료 ≈ TTFT + 출력 토큰 수 × 토큰당 시간이다 계산 위 정의를 거꾸로 푼 식
- Claude Code 트레이스
claude_code.llm_request스팬도ttft_ms와duration_ms(재시도 포함 wall-clock)를 따로 찍는다
지표 거는 법
- 지연은 성공 기준(success criteria)의 한 차원이다. 받아들일 수 있는 응답 시간은 앱의 실시간 요구와 사용자 기대에 달렸다. 자세한 것은 ■ 성공 기준 에 있다
- 분위수로 건다. 공식 예는 "응답 95% 가 200ms 미만" 이다
- eval 에서도
time_to_first_token·output_tokens_per_sec·time_to_last_token을 따로 추적한다 - TTFT 를 줄이는 공식 수단은 캐싱(샘플 2 해설)과 캐시 사전 워밍(pre-warming)이다. 완료 지연 쪽 수단은 출력 길이 · effort · 모델이다. lever(조절 수단) 본문은 ■ 지연 줄이기 lever 에 있다
- 사람이 안 기다리는 배치에는 TTFT 가 해당하지 않는다. 그래서 캐시 사전 워밍(
max_tokens: 0)이 Message Batches 에서 거부된다
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 등급 | 근거 |
|---|---|---|---|
| 채팅처럼 사람이 첫 글자를 기다린다 | TTFT 를 지표로 건다. 스트리밍을 쓴다 | reduce-latency "It's particularly relevant when you're using streaming" | |
| 첫 토큰은 빨라졌는데 "여전히 느리다" | 응답 완료 지연을 따로 재고 출력 길이를 본다 | (정의) · 업계 일반(진단) | reduce-latency |
| 지연 기준을 성공 기준(success criteria)에 넣는다 | 분위수로 건다 : 응답 95% 가 N ms 미만 | define-success en-full | |
| eval 에서 지연을 추적한다 | TTFT · 초당 출력 토큰 · 마지막 토큰까지를 따로 잰다 | demystifying-evals | |
| 모니터링 지표를 고른다 | gen_ · gen_ · gen_ | OTel semconv v1.37.0 | |
| TTFT 자체가 느리고, 앞부분이 매번 같다 | 캐싱을 쓴다 (첫 요청이면 캐시 사전 워밍도) | 가이드 샘플 2 해설 · prompt-caching | |
| 완료가 느리고, 답이 장황하다 | 출력 길이를 줄인다(짧게 요청 · max_). 자세한 것은 ■ 지연 줄이기 lever 에 있다 | reduce-latency | |
| 배치 작업의 지연 목표 | TTFT 는 해당하지 않는다. 완료 시각(배치 창)으로 건다 | prompt-caching "Pre-warming targets time-to-first-token, which does not apply to batch processing" |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 기다리는 쪽 | 사람 화면 | TTFT 가 체감을 좌우한다 | reduce-latency | |
| 기다리는 쪽 | 뒤 단계 코드 · 배치 | 완료 지연 | 업계 일반 · 확인(배치) | prompt-caching |
| 출력 길이 | 몇 토큰(분류 라벨) | 완료 ≈ TTFT 다. 입력 쪽 lever(조절 수단)를 쓴다 | 계산 | 뒤집히는 때 1 |
| 출력 길이 | 수천 토큰(보고서) | 완료의 대부분이 출력 구간이다. 출력 쪽 lever 를 쓴다 | 계산 | 뒤집히는 때 2 |
| 입력 | 길고 매번 같은 앞부분 | 캐싱이 TTFT 를 줄인다 | 가이드 샘플 2 해설 | |
| 첫 요청 | 캐시 미스 | 캐시 사전 워밍 | prompt-caching | |
| 시스템 모양 | 도구를 여러 번 부르는 에이전트 | 모델 요청 하나의 TTFT 보다 턴 전체 시간을 본다 | 업계 일반 | 뒤집히는 때 3 · monitoring-usage |
| 집계 | 평균 | 가장 느린 몇 %(꼬리 지연)를 가린다. 그래서 분위수를 쓴다 | (공식 예가 95%) · 업계 일반(이유) | define-success en-full |
연습 문제
상담 기록 요약 파이프라인이 1,800토큰짜리 주간 보고서를 만들면 다음 단계 코드가 통째로 받아 쓴다결과 전체. 팀은 스트리밍을 켜 TTFT 가 1.2초로 좋아졌으니 지연(latency) 문제는 해결됐다고 한다. 지연 목표는 무엇으로 걸어야 할까?
시험 대비
함정
- "스트리밍을 켰으니 지연 문제가 해결됐다" 는 함정이다. 스트리밍은 체감(TTFT)만 바꾼다. 완료 지연은 그대로다 업계 일반
- "TTFT 하나로 지연 SLO 를 건다" 는 함정이다. 긴 출력의 완료 시간을 못 본다 업계 일반. 공식 eval 예시는 TTFT 와 완료를 따로 추적한다
- "TTFT 가 좋아졌으니 모델 출력이 빨라졌다" 는 함정이다. TTFT 는 대기 · 입력 처리 구간이다. 출력 속도는 토큰당 시간으로 따로 본다
- 평균 하나로 지연 기준을 거는 것은 함정이다. 공식 예는 "응답 95% 가 200ms 미만" 처럼 분위수로 건다
- 결과를 코드가 통째로 받는 파이프라인에 TTFT 목표를 거는 것은 함정이다. 기다리는 쪽이 코드면 완료 지연이 지표다 업계 일반
- "캐싱은 비용만 줄이고 지연과 무관하다" 는 함정이다. 캐싱은 TTFT 를 줄인다 (샘플 2 해설)
신호
"This metric measures the time it takes for the model to generate the first token of the response, from when the prompt was sent."
"This is the time taken by the model to process the prompt and generate the response, without considering the input and output tokens per second."
"This can significantly improve the perceived responsiveness of your application, as users can see the model's output in real time."
"Factors that can influence TTFT include model size, hardware capabilities, network conditions, and the complexity of the prompt."
"It helps measure the time spent in the queue and the prefill phase."
"Pre-warming targets time-to-first-token, which does not apply to batch processing"
"reducing both time-to-first-token and per-request cost without discarding required context" (가이드 샘플 2)
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
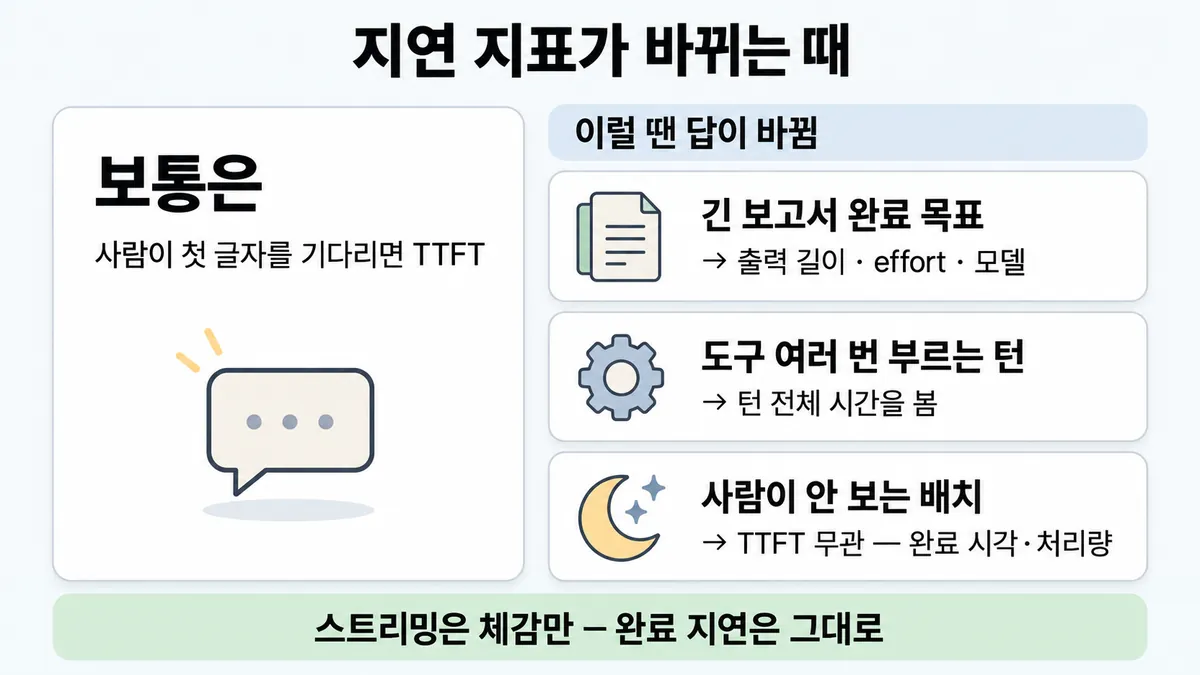
뒤집히는 때
1. 출력이 몇 토큰뿐이면 TTFT 가 곧 완료다
- 조건 : 문의를 5개 라벨 중 하나로 분류한다. 출력은 약 5토큰이다. TTFT 0.9초, 토큰당 0.02초라고 치자(가정값).
- 계산 : 완료 ≈ 0.9 + 5 × 0.02 = 1.0초다. 완료의 90% 가 TTFT 구간이다.
- 판단 : 여기서는 "TTFT vs 완료"를 가를 필요가 거의 없다. 스트리밍 이득도 작다(보여 줄 것이 한 단어다). 줄일 곳은 입력 쪽이다. 앞부분이 매번 같으면 캐싱을 쓰고, 아니면 모델을 본다.
- 전제 : 가정값이다. 토큰당 시간은 일정하다.
- 등급 : 계산 (식은 OTel 정의에서)
- 근거 : OTel semconv · 가이드 샘플 2 해설
2. 긴 보고서는 TTFT 를 반으로 줄여도 그대로다
- 조건 : 보고서 출력은 1,800토큰이다. TTFT 1.2초, 초당 출력 60토큰이라고 치자(가정값). 완료 목표는 15초다.
- 계산 : 완료 ≈ 1.2 + 1,800 ÷ 60 = 31.2초다. 캐싱으로 TTFT 를 0.6초로 줄여도 30.6초라 목표에 못 미친다. 출력을 700토큰으로 줄이면 1.2 + 700 ÷ 60 ≈ 12.9초라 목표 안이다.
- 판단 : 스트리밍과 캐싱으로는 완료 목표를 못 맞춘다. 출력 길이(짧게 요청 ·
max_tokens) · effort · 모델 쪽을 본다. - 전제 : 가정값이다. 출력을 줄여도 품질 기준(eval)을 지킨다.
- 등급 : 계산
- 근거 : OTel semconv · reduce-latency · ■ 지연 줄이기 lever
3. 에이전트는 요청 하나의 TTFT 가 체감이 아니다
- 조건 : 한 턴에 도구를 4번 부르는 지원 에이전트다. 요청마다 TTFT 는 짧다.
- 판단 : 사용자가 기다리는 것은 턴 전체(요청 여러 개 + 도구 실행)다. 요청 하나의 TTFT 만 보면 느린 도구와 호출 횟수를 놓친다. Claude Code 트레이스도 턴 전체(
interaction.duration_ms)와 요청별(ttft_ms·duration_ms)을 따로 찍는다. 어디서 느린지 가르기는 ■ observability 세 신호 에 있다. - 등급 : (필드) · 업계 일반(판단)
- 근거 : monitoring-usage
4. 사람이 안 보는 배치
- 조건 : 밤새 도는 문서 요약 배치다.
- 판단 : TTFT 는 해당하지 않는다. 공식도 캐시 사전 워밍을 배치에서 거부하며 "TTFT 는 배치와 무관"이라고 쓴다. 지표는 전체 완료 시각(배치 창)과 처리량이다.
- 근거 : prompt-caching · ◆ Batch API vs 동기 호출
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "스트리밍을 켰으니 지연 문제 해결" | 글자가 바로 뜨니 빨라진 것 같다 | 체감(TTFT)만 바뀐다. 생성 토큰 수가 같아서 완료는 그대로다 | 업계 일반 | reduce-latency ("perceived") |
| "TTFT 하나로 지연 SLO 를 건다" | 대표 지연 지표로 알려져 있다 | 긴 출력의 완료 시간을 못 본다. 공식 eval 예시는 따로 추적한다 | (따로 추적) | demystifying-evals |
| "TTFT 가 좋아졌으니 모델 출력 속도가 빨라졌다" | 빨라진 숫자가 하나 보인다 | TTFT 는 대기 · 입력 처리 구간이다. 출력 속도는 토큰당 시간이다 | OTel semconv | |
| "평균 응답 시간 N초 미만" | 흔한 표기다 | 공식 예는 분위수(95%)다 | define-success en-full | |
| "완료가 느리니 캐싱부터" | 캐싱이 지연을 줄인다고 들었다 | 캐싱은 TTFT 쪽이다. 출력 구간이 크면 효과가 작다 | 계산 | 뒤집히는 때 2 |
| "배치에도 TTFT 목표를" | 모든 호출에 같은 지표를 쓰고 싶다 | 배치에는 TTFT 가 해당하지 않는다 | prompt-caching | |
| "지연 지표로 pass^k 를 고른다" (반대 방향 혼동) | 둘 다 "지표 고르기" 문항이다 | pass^k 는 신뢰성 지표다. 자세한 것은 ◆ pass@k vs pass^k 에 있다 | demystifying-evals |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 4.1 공식 시험 가이드 v1.0
- 샘플 2 공식 시험 가이드 v1.0
- reduce-latency
- glossary
- OTel GenAI semconv v1.37.0
- demystifying-evals
- define-success
- prompt-caching
- monitoring-usage
상태
- 계산 1줄(완료 식)
- 업계 일반 5줄
미해결
- 공식 지연 문서(reduce-latency)는 "응답 완료까지"를 이름으로 따로 정의하지 않는다. 가까운 것은 셋이다. 기본 지연(baseline latency, 초당 토큰은 따로 안 셈), eval 예시의
time_to_last_token, OTelgen_ai.server.request.duration이다. 카드의 "응답 완료 지연"은 이 셋을 묶은 이름이다. - extended thinking 을 켜면 첫 토큰이 thinking(사고) 블록일 수 있다. 그러면 "사용자가 보는 첫 글자"와 TTFT 가 어긋날 수 있다. 받은 원문에 이 관계를 말한 문장은 없다. Claude Code 의
first_content_ms(첫 content 블록까지)가ttft_ms와 따로 있는 것만 확인했다(monitoring-usage). - 목록 4.1② 의 규칙 "TTFT 자체를 줄이는 공식 수단은 캐싱(샘플 2 해설)"은 확인했다. 목록의 영어 신호 두 문장도 reduce-latency에서 찾았다.
- "사람이 보면 TTFT, 코드가 받으면 완료"라는 갈림 자체는 공식 문장이 없다(업계 일반). 공식은 TTFT 가 스트리밍·반응성에 특히 중요하다고만 쓴다.