■ moderation 위험 등급
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 5.3 사람 검증 전략 · D5 규정·안전 14%Apply human-in-the-loop validation strategies
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 5.3③ 검열 분류기가 "고위험" 판정 — 사람 대기열로 넘길까? — 위험 등급별 처리 (자동 차단 / 사람 검토 / 통과)
한눈에
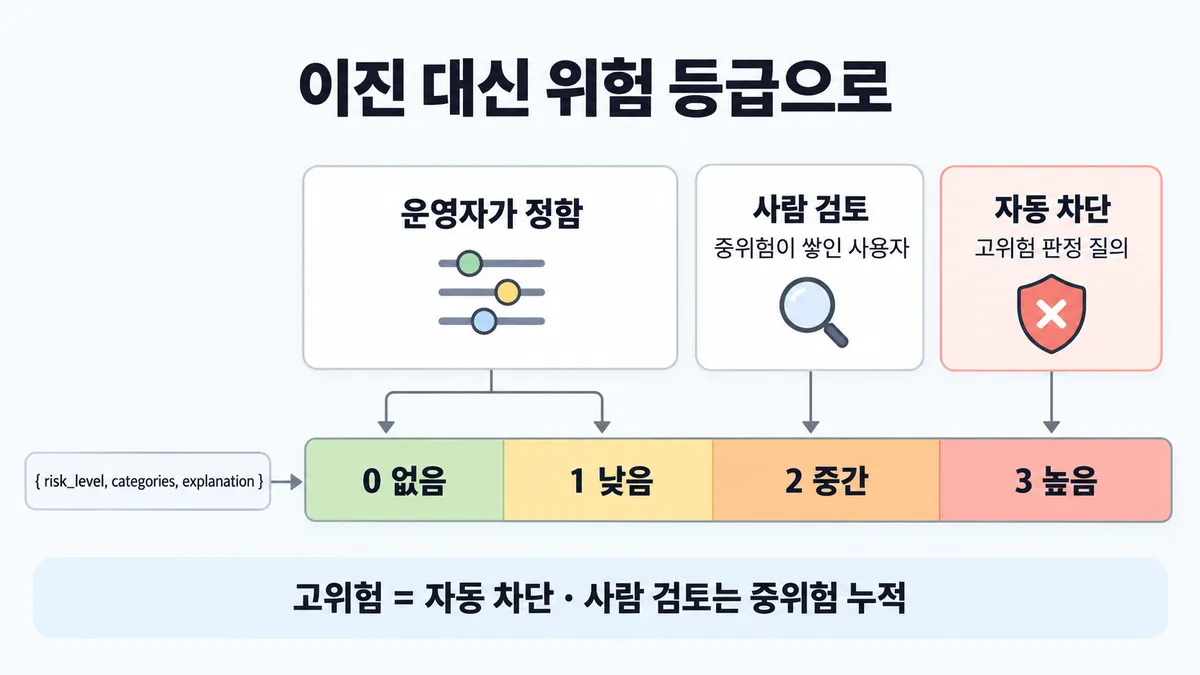
사용자 콘텐츠 moderation(유해 콘텐츠 검토)을 허용/차단 이진 분류 대신 여러 위험 등급으로 나눈다. 그러면 moderation 강도를 조절할 수 있다. 예를 들어 고위험(high-risk) 판정 질의는 자동 차단한다. 중위험 질의가 많은 사용자는 사람 검토 대상으로 표시(flag)한다 (2026-09-28 조회)
판정은 JSON(위험 등급 · 위반 범주 · 설명)으로 받고 코드가 분기한다
공식 예시 등급은 0 없음 · 1 낮음 · 2 중간 · 3 높음이다. 기준은 "걸러내야(moderated) 한다는 확신" 이다. 설명은 0 보다 클 때만 붙인다
비유 명백한 공격 트래픽은 WAF 가 자동 차단한다. 애매한 요청이 쌓인 IP 는 보안 관제 분석가 큐로 보낸다
ELI5
학교 게시판에 붙는 쪽지를 고르는 방법이에요.
- 누가 봐도 무서운 협박 쪽지는 바로 떼요.
- 애매한 쪽지를 자꾸 붙이는 아이는 선생님이 따로 봐요.
- 모든 쪽지를 선생님이 다 보면 선생님이 못 따라가요.
- 떼인 쪽지 주인에게는 왜 떼였는지 알려 줘요.
개념 설명
원리
moderation(유해 콘텐츠 검토)은 분류 문제다
- 그래서 분류와 같은 방법으로 정확도를 측정한다. 정밀도(precision)·재현율(recall)을 쓴다.
- 이진(허용/차단)은 lever(조절 수단)가 하나뿐이다. 등급을 나누면 "어디서부터 막나" 를 조절하는 다이얼이 생긴다.
등급의 뜻은 확신이다
- 공식 예시 프롬프트는 등급을 "걸러내야(moderated) 한다는 확신" 으로 매긴다(0 없음 · 1 낮음 · 2 중간 · 3 높음).
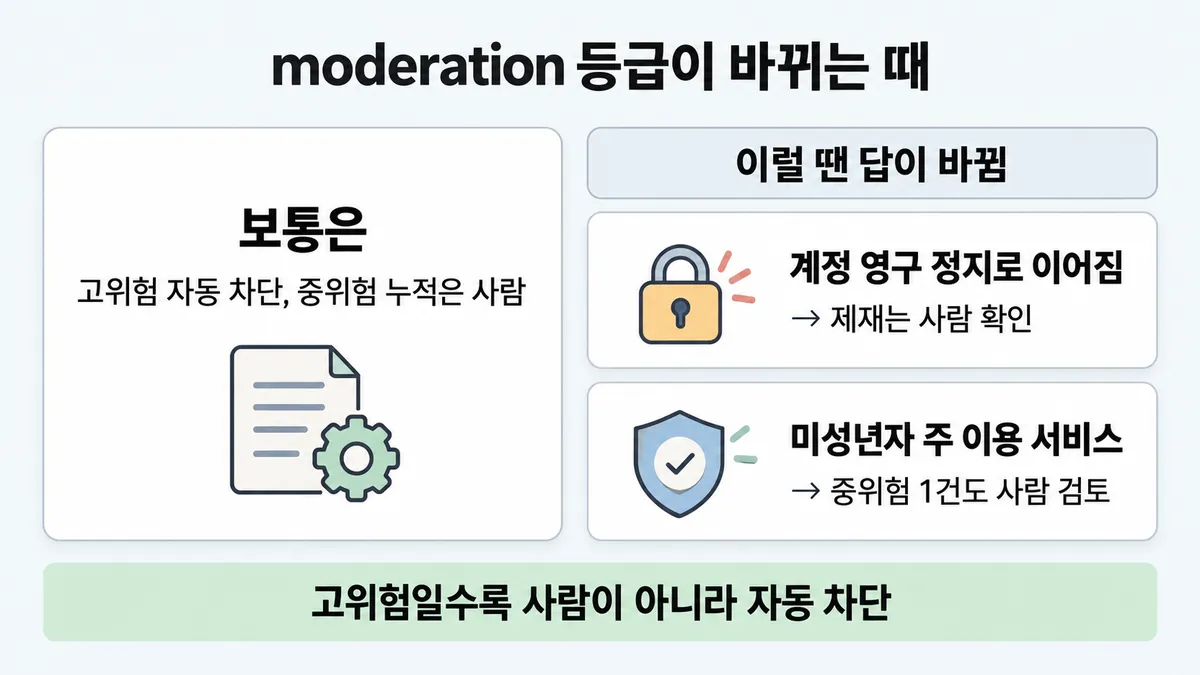
- 고위험(high-risk)은 확신이 높다. 사람이 봐도 결론이 안 바뀐다. 그래서 자동 차단이 맞다.
- 중위험은 애매하다. 한 건으로는 판정이 흔들린다. 그래서 쌓인 사용자를 사람이 본다.
에이전트 행동 승인과 반대인 이유
- 행동 승인(■ human-in-the-loop 게이트 위치)은 "틀리면 되돌릴 수 없는 행동" 앞에 사람을 둔다.
- moderation 차단은 이유를 알려 주고 다시 쓰게 할 수 있다. 그래서 자동으로 막아도 비용이 작다 (추론).
- 그래서 같은 "고위험" 이라도 행동이면 사람이 보고, 콘텐츠면 자동 차단한다.
돈과 속도
- moderation 은 양이 많다. 그래서 작은 모델(Haiku 4.5)이 기본 선택지다.
- 실시간이 아니면 여러 메시지를 한 호출에 묶어 더 싸게 한다(품질은 조금 내려갈 수 있다).
핵심 질문 두 개
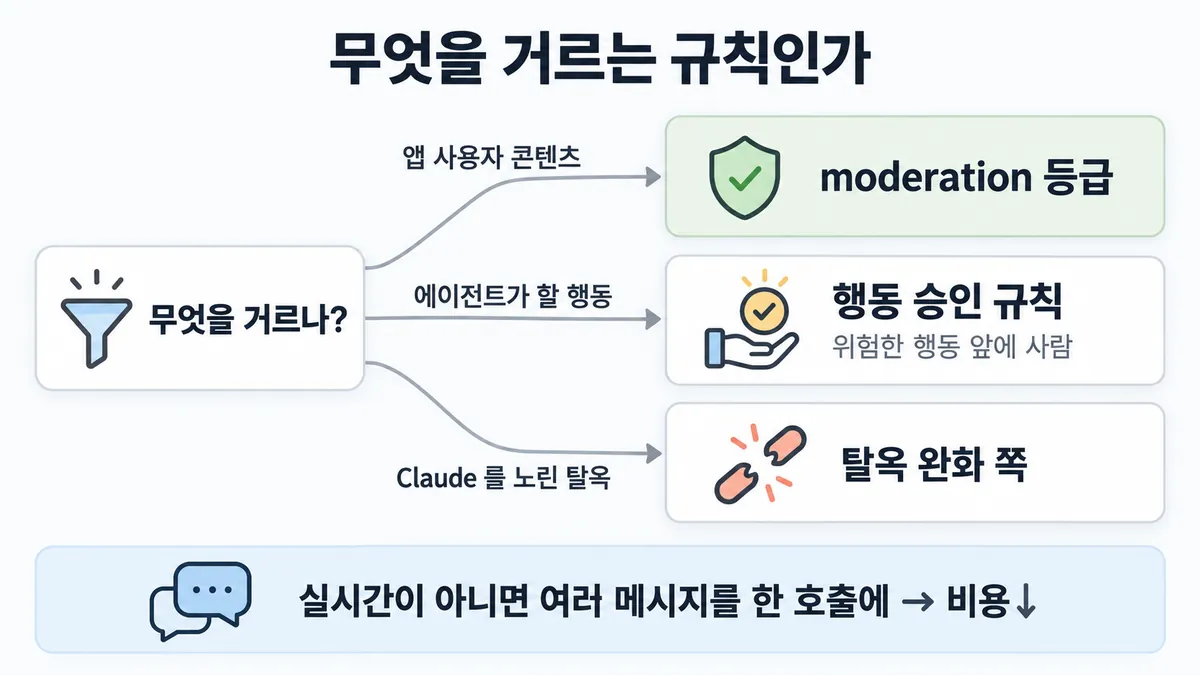
- 거르는 대상이 앱 사용자의 콘텐츠인가, 에이전트의 행동인가, Claude 를 노린 공격인가?
- 판정 확신이 높은가(자동), 애매한가(쌓이면 사람)?
규칙과 판단
갈림길
①② 등급별 처리 [5.3③]
risk_level 0~3자동 차단
고위험 판정 질의는 자동 차단한다
사람 검토
중위험 질의가 많은 사용자는 사람 검토 대상으로 표시한다
운영자가 정한다
공식 예시는 중위험 질의가 많은 사용자를 다룬다. 그 밖 등급(중위험 한 건 · 없음·낮음)은 공식 예시에 처리법이 없다. 그래서 등급별 강도(문턱)는 운영자가 정한다
운영자가 정한다
그 밖 등급(중위험 한 건 · 없음·낮음)은 공식 예시에 처리법이 없다. 그래서 등급별 강도(문턱)는 운영자가 정한다
⑤ 어느 규칙인가 [5.3③] [5.3①]
moderation 등급
고위험은 자동 차단한다
에이전트 행동 승인 규칙
'위험한 행동 앞에 사람' 은 이 규칙이다. 자세한 것은 ■ human-in-the-loop 게이트 위치 에 있다
탈옥 완화 쪽
이 가이드는 사용자 생성 콘텐츠용이다. Claude 와의 상호작용 moderation 은 탈옥·인젝션 완화 문서가 다룬다
③④ 비용·속도 [5.3③]
여러 메시지를 한 호출에
비용이 준다. 배치가 클수록 품질이 조금 내려간다
배치하지 못한다
실시간이 필요 없을 때만 배치한다
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 댓글 → Claude 판정 → 코드 분기 → 사람 대기열
규칙 (코드 분기) : 고위험은 자동 차단한다 · 중위험 질의가 많은 사용자는 사람이 검토한다
질문 : 가장 위험한 댓글은 누가 처리할까?
① 고위험은 자동 차단 ✓
- 시작 : 댓글 — 쪽지 : 댓글: 너희 가족 사는 곳 안다. 찾아간다.
- 판정 : 댓글 → Claude 판정 : 공식 예로는 고위험이다 — 쪽지 : { "risk_level": 3, / "categories": ["위협"], / "explanation": "…" }
- 분기 : Claude 판정 → 코드 분기 : 등급으로 분기한다 — 쪽지 : if risk_level == 3 / → 자동 차단
- 건너뜀 : 사람 대기열
- 끝 : 고위험은 자동 차단한다. 사람 대기열로 안 간다
② 중위험이 쌓이면 사람에게 ✓
- 시작 : 댓글 — 쪽지 : 댓글: 5G 기지국이 바이러스를 퍼뜨린대.
- 판정 : 댓글 → Claude 판정 : 공식 예로는 중간이다 — 쪽지 : { "risk_level": 2, / "categories": ["허위 정보"] }
- 분기 : Claude 판정 → 코드 분기 : 사용자별 누적을 센다 — 쪽지 : user_42 / 이번 주 중위험 14건
- 표시 : 코드 분기 → 사람 대기열 : 중위험 질의가 많은 사용자를 표시한다 — 쪽지 : 검토 요청 / user_42 · 중위험 14건
- 끝 : 중위험 질의가 많은 사용자는 사람이 검토한다
③ 고위험도 사람 대기열로 ≠
- 시작 : 댓글 — 쪽지 : 댓글: 너희 가족 사는 곳 안다. 찾아간다.
- 판정 : 댓글 → Claude 판정 : 확신이 높은 고위험이다 — 쪽지 : { "risk_level": 3 }
- 분기 : Claude 판정 → 코드 분기 : 등급과 상관없이 사람에게 보낸다 — 쪽지 : if risk_level >= 2 / → 사람 대기열
- 표시 : 코드 분기 → 사람 대기열 : 명백한 위협까지 보낸다 — 쪽지 : 대기 1,240건 / 명백한 위협 포함
- 끝 : 명백한 것까지 사람 대기열에 쌓인다. 검토자가 밀린다
나머지 규칙
-
운영 : 운영할 때 아래를 챙긴다
- 막거나 표시한 이유와 다시 쓰는 법을 사용자에게 알린다(
explanation필드) - 표시된 콘텐츠 유형을 추적한다
- 정밀도·재현율로 계속 평가한다
- 범주마다 정의를 붙인다. 그러면 나아진다(금 투자 권유 댓글이 정의 추가 뒤 Specialized Advice 위반으로 잡혔다)
- 막거나 표시한 이유와 다시 쓰는 법을 사용자에게 알린다(
-
규칙 기반·기존 ML 대신 LLM 을 고를 신호는 아래와 같다
- 싸고 빠르게 구현해야 한다
- 의미를 이해하면서 빠르게 결정해야 한다
- 정책을 일관되게 적용해야 한다
- 정책이 자주 바뀐다(재라벨링 없이)
- 설명 가능한 근거가 필요하다
- 별도 모델 없이 다국어를 다뤄야 한다
- 멀티모달이 필요하다
규칙 원문 ①②③④⑤ (갈림길로 그린 규칙)
-
등급 나누기 : 이진 대신 여러 위험 등급으로 나눠 강도를 조절한다. 고위험은 자동 차단하고, 중위험 질의가 많은 사용자는 사람이 검토한다. "위험할수록 사람" 이 아니다. 공식 예로 가족을 찾아가겠다는 위협 댓글은 고위험이고, 5G 음모론 댓글은 중간이다 [5.3③]
그 밖 등급(중위험 한 건 · 없음·낮음)은 공식 예시에 처리법이 없다. 그래서 등급별 강도(문턱)는 운영자가 정한다
-
판정 형식 :
{ "risk_level", "categories", "explanation" }JSON 만 내게 한다. 코드가 등급으로 분기한다. 등급 0~3 은 "걸러내야(moderated) 한다는 확신" 이 기준이다. 설명은 0 보다 클 때만 붙인다 [5.3③] -
모델 : 데이터 규모를 보고 고른다. 비용이 걱정이면 Haiku 4.5 를 쓴다. 공식 예는 월 10억 게시물이다(게시물당 100자, 3% 가 위반으로 표시). 이때 Haiku 4.5 는 월 $36,100, Opus 5 는 월 $180,500 이다 (2026-09-28 조회) [5.3③]
-
실시간이 아니면 여러 메시지를 한 호출에 넣어 moderation 한다. 그러면 비용이 준다. 배치가 클수록 싸지만 품질이 조금 내려간다.
max_tokens를 늘려야 할 수도 있다. 이것은 Message Batches API 가 아니라 한 프롬프트에 여러 메시지를 넣는 것이다 [5.3③] -
범위 : 이 가이드는 앱 안 사용자 생성 콘텐츠의 moderation 을 다룬다. Claude 와의 상호작용 moderation 은 탈옥·인젝션 완화 문서가 다룬다. Claude 는 내장 안전 동작이 있다. 그래서 AUP 상 특히 위험한 콘텐츠는 프롬프트와 관계없이 표시할 수 있다(성인 사이트가 "노골적 성적 콘텐츠는 걸러내지 마" 라 적어도). 구축 전에 AUP 를 검토한다 [5.3③]
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
| 고위험 판정 질의다 | 자동 차단한다 | content-moderation "automatically block user queries that are deemed high risk" |
| 중위험 질의가 많은 사용자다 | 사람 검토 대상으로 표시(flag)한다 | 같은 줄 "users with many medium risk queries are flagged for human review" |
| 판정을 받는 형식 | JSON(위험 등급 · 위반 범주 · 설명)으로 받고 코드가 분기한다 | en-full |
| 비용이 걱정이다 | Haiku 4.5 같은 작은 모델을 쓴다 | |
| 실시간이 필요 없다 | 여러 메시지를 한 호출에 넣는다 | |
| 막거나 표시했다 | 이유와 다시 쓰는 법을 사용자에게 알린다 (explanation) | |
| 운영(production) 중이다 | 정밀도·재현율로 계속 평가하고, 표시 유형을 추적한다 | |
| Claude 를 노린 탈옥·인젝션이다 | 이 가이드 말고 탈옥 완화 문서를 본다 | en-full |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 위험 등급 | 높음(3) | 자동 차단한다 | 판단 규칙 1 | |
| 위험 등급 | 중간(2)이고 사용자에게 쌓였다 | 사람이 검토한다 | 판단 규칙 2 | |
| 위험 등급 | 없음·낮음(0~1) | 통과시킨다 | 업계 일반 | 공식 문장은 고·중만 다룬다 |
| 강도 | 미성년 이용 서비스 등 엄격해야 한다 | 등급 문턱을 낮추고 범주를 추가한다(예 Underage Posting) | "adjust the aggressiveness" | |
| 실시간 여부 | 실시간 | 배치 대신 작은 모델을 쓴다 | ||
| 실시간 여부 | 나중에 해도 된다 | 여러 메시지를 한 호출에 넣는다 | ||
| 정책 변화 | 자주 바뀐다 | LLM 쪽이다 (재라벨링 없이 적응한다) | en-full | |
| 운영자 정책 | 노골적 성적 콘텐츠를 허용한다 | Claude 가 그래도 표시할 수 있다. AUP 를 먼저 검토한다 | en-full | |
| 범주 정의 | 이름만 있다 | 놓침이 생긴다 | (금 투자 댓글) | |
| 범주 정의 | 정의·문구까지 있다 | 더 잘 잡는다 |
연습 문제
커뮤니티 앱이 새 댓글 판정을 risk_level 2(중간)중간로 받았다. 이 댓글을 쓴 사용자는 이번 주에만 중위험 댓글이 14건 쌓였다누적. 운영팀은 "위험할수록 사람이 봐야 하니 고위험만 사람에게 보내자" 고 한다. 이 사용자는 어떻게 처리할까?
시험 대비
함정
- "고위험일수록 사람이 검토한다" 는 함정이다. moderation 에서는 고위험을 자동 차단한다. '위험한 행동 앞에 사람' 은 에이전트 행동 승인 규칙이다. 자세한 것은 ■ human-in-the-loop 게이트 위치 에 있다
- "허용·차단 이진 분류" 는 함정이다. 등급으로 강도를 조절한다
- 명백한 것까지 사람 대기열에 보내는 것은 함정이다. 검토자가 밀린다 업계 일반
- "중위험 한 건마다 사람이 본다" 는 함정이다. 공식 예시는 중위험 질의가 많은 사용자를 사람에게 보낸다
- "프롬프트에 '성인 콘텐츠는 걸러내지 마' 라 적으면 된다" 는 함정이다. 내장 안전 동작으로 여전히 표시될 수 있다
- "비용을 줄이려고 실시간 moderation 도 큰 배치로 묶는다" 는 함정이다. 배치는 실시간이 필요 없을 때만 쓴다. 배치가 크면 품질이 조금 내려간다
- "이유 없이 차단만 한다" 는 함정이다. 이유와 다시 쓰는 법을 알려 준다
신호
"instead of treating content moderation as a binary classification problem, you may instead create multiple categories to represent various risk levels."
"Creating multiple risk levels allows you to adjust the aggressiveness of your moderation."
"you might want to automatically block user queries that are deemed high risk, while users with many medium risk queries are flagged for human review."
"The prompt instructs Claude to respond with a JSON object that includes the risk level, the violated categories, and an optional explanation."
"If costs are a concern, a smaller model such as Claude Haiku 4.5 is an excellent choice because of its cost-effectiveness."
"To reduce costs in situations where real-time moderation isn't necessary, consider moderating messages in batches."
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
1. 작은 모델이 답이 아닌 때가 있나 — 월 3억 게시물, 숫자로
- 조건 : 월 게시물 3억, 게시물당 140자, 3% 가 위반으로 표시, 표시 건당 출력 50토큰이다 (공식 예시의 식을 그대로 쓴다).
- 계산 : 입력 = 3억 × 140 ÷ 3.5 = 120억 토큰(12,000 MTok). 출력 = 3억 × 0.03 × 50 = 4.5억 토큰(450 MTok).
- Haiku 4.5 ($1 / $5) 는 $12,000 + $2,250 = 월 $14,250 이다
- Opus 5 ($5 / $25) 는 $60,000 + $11,250 = 월 $71,250 이다 (5배)
- 판단 : 비용이 제약이면 작은 모델을 쓴다. 큰 모델이 이기려면 월 $57,000 차이를 사람 검토 감소 같은 다른 이득으로 메워야 한다. 그 이득의 공식 숫자는 없다.
- 전제 : 3.5자 = 1토큰은 공식 예시의 가정이다. 한국어는 글자당 토큰이 다를 수 있다. 가격은 2026-09-28 조회값이다(예시 문서 표기).
- 등급 : 계산
- 근거 : content-moderation
2. 고위험도 사람에게 보내면
- 조건 : 하루 댓글 40만, 고위험 0.3%(1,200건), 중위험 2.5%(1만 건)이다. 검토자 1명이 하루 500건을 본다고 가정한다.
- 계산 : 고위험을 사람 큐로 보내면 검토자 2.4명 몫이 명백한 건에 쓰인다. 이 건들은 확신이 높아 사람이 봐도 결론이 거의 안 바뀐다. 그만큼 애매한 중위험 사용자 검토가 밀린다.
- 판단 : 고위험은 자동 차단하고, 중위험이 쌓인 사용자만 사람이 본다. 공식 예시와 같은 방향이다.
- 등급 : 처방은 확인 · 인원 계산은 가정 숫자라 계산(예시)
- 근거 : en-full(등급 = 확신)
3. 고위험인데 사람이 필요한 때
- 조건 : 판정 결과가 댓글 차단이 아니라 계정 영구 정지 같은 제재로 이어진다.
- 판단 : 콘텐츠 차단은 자동으로 둔다. 하지만 되돌리기 어려운 제재는 사람이 확인한다. 이것은 콘텐츠 규칙이 아니라 행동 규칙(■ human-in-the-loop 게이트 위치)으로 넘어간 것이다.
- 등급 : 업계 일반 (공식 moderation 가이드는 제재를 다루지 않는다)
- 근거 : —
4. 중위험 1건이라도 사람에게
- 조건 : 미성년자가 주 이용자인 서비스다.
- 판단 : 등급을 나누는 목적이 강도 조절이라 문턱은 운영자가 정한다. 엄격한 서비스는 중위험 1건도 사람 검토로 보낼 수 있다. 공식 예시("많은")는 기본값이지 상한이 아니다.
- 등급 : (원칙 : 강도 조절) · 구체 문턱은 공식 숫자가 없다
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "고위험일수록 사람이 검토" | 에이전트 승인 규칙과 헷갈린다 | moderation 에서는 고위험을 자동 차단한다 | ||
| "허용·차단 이진 분류" | 단순하다 | 강도를 조절할 lever 가 없다 | ||
| "모든 표시 건을 사람 대기열에" | 신중해 보인다 | 명백한 건까지 쌓여 검토자가 밀린다 | 업계 일반 | 뒤집히는 때 2 |
| "중위험 한 건마다 사람" | 놓치지 않을 것 같다 | 공식 예시는 중위험이 많은 사용자를 본다 (단 엄격한 서비스는 가능하다. 뒤집히는 때 4) | ||
| "프롬프트에 '성인 콘텐츠는 걸러내지 마'" | 운영자가 정책을 정한다고 본다 | 내장 안전 동작이 우선할 수 있다. AUP 를 먼저 본다 | en-full | |
| "moderation 에 가장 큰 모델" | 정확할 것 같다 | 양이 많아 비용이 5배다. 비용이 걱정이면 Haiku 4.5 를 쓴다 | ||
| "실시간 채팅도 큰 배치로" | 비용이 준다 | 실시간이 필요 없을 때만 쓴다. 배치가 크면 품질이 내려간다 | ||
| "Claude 를 노린 탈옥도 이 moderation 파이프라인으로" | 같은 'moderation' 이라는 말이다 | 이 가이드는 사용자 생성 콘텐츠용이다. 탈옥·인젝션은 별도 문서가 다룬다 | en-full | |
| "이유는 안 알려 주고 차단만" | 우회를 막을 것 같다 | 공식 모범 사례는 이유와 다시 쓰는 법을 알려 준다 |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
미해결
- 목록 5.3③ "'위험할수록 사람' 은 에이전트 행동 승인(5.3①)의 규칙" : 원문과 대조했다. auto mode 는 "위험할수록 사람" 이라기보다 "되돌릴 수 없는 행동은 막고, 거부가 쌓이면 사람" 이다 (claude-code-auto-mode). 방향은 같지만 문장은 목록의 요약이다.
- 없음·낮음(0~1) 처리와 "많은(many)" 의 기준 숫자는 원문에 없다.
- 한국어판은 "인간 검토"·"중간 위험 쿼리" 라고 쓴다. 뜻은 영어판과 같다.
- 비용 예시에 Opus 4.8 과 Opus 5 가 같은 가격($5/$25)으로 나란히 있다. 문서가 모델 목록을 덧붙여 온 흔적이다. 시험은 "작은 모델 = 비용 효율" 방향만 물을 가능성이 있다(추론).
- 공식 예시 코드는 JSON 을 프롬프트 지시로만 받는다. 스키마 보장(구조화 출력)을 쓰라는 문장은 이 문서에 없다.