■ 질의 패턴별 검색
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 3.6 데이터 모양에 맞는 검색 · D3 연결 19%Apply retrieval strategies matched to data shape and query pattern
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 3.6② '반품 기한은?'·'A·B 요금제 차이'·'내 주문 배송사 규정은?' 이 섞여 온다 — 검색을 하나로 통일하나? — 질의 패턴에 맞춰 검색 노력 조절 (hybrid+리랭킹 기본 · 분해 · 다단계 · 라우팅 · 범위 제한)
- 3.3③ 리랭커를 붙이자 답은 좋아졌는데 p95 지연이 목표를 넘는다 — 몇 개를 리랭킹하나? — 검색 품질 vs 지연·비용 (리랭킹 개수 · 양자화 · 질의 라우팅)
한눈에
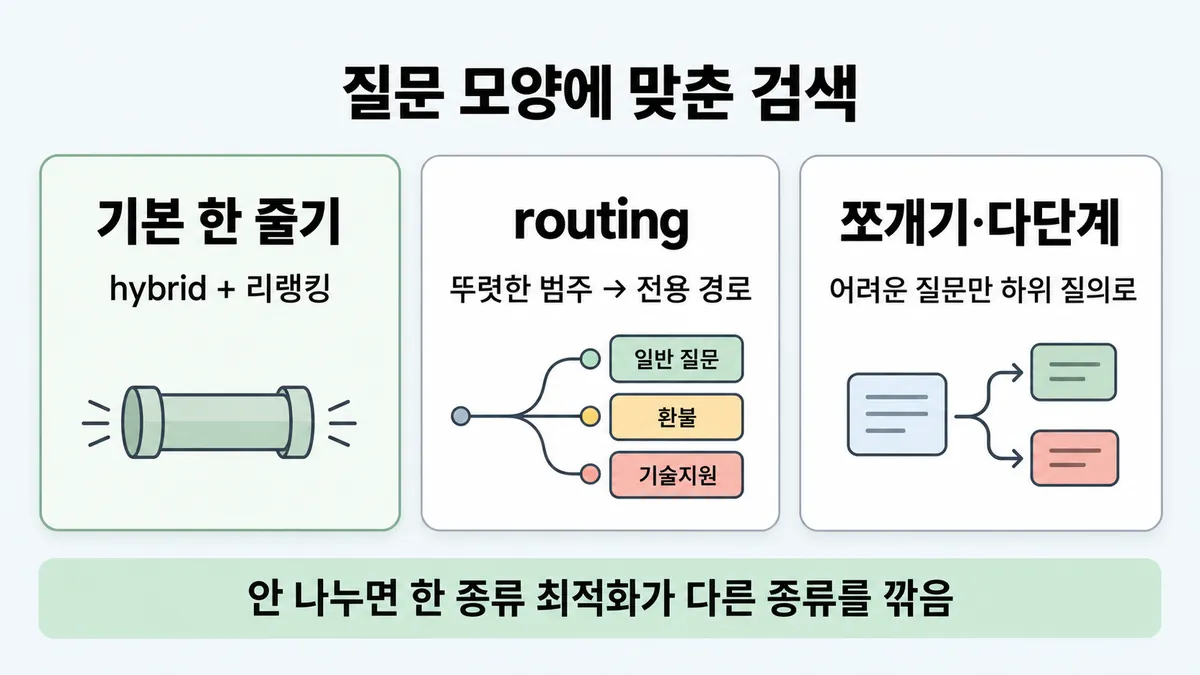
질문 종류에 맞춰 검색(retrieval) 노력을 조절한다. 기본은 hybrid + 리랭킹 단일 파이프라인이다. 질문 모양이 뚜렷이 갈릴 때만 경로를 나눈다. 어려운 질문만 쪼개거나 여러 번 검색한다
비유 L7 로드밸런서의 경로별 라우팅과 같다. 비교 질문은 대시보드 둘을 따로 조회해 나란히 놓는 것과 같다
ELI5
동네 병원 접수대를 떠올려 보세요.
- 감기면 바로 1층 진료실로 보내요.
- 두 약을 비교해 달라면 약 하나씩 따로 알아본 뒤 나란히 놓아요.
- 먼저 검사 결과를 봐야 다음 과를 정할 수 있으면, 순서대로 두 번 가요.
- 감기 환자를 종합검진에 보내면 시간과 돈만 들어요.
- 이 쪽은 "언제 한 줄로 두고, 언제 나누나"를 모아 둔 곳이에요.
개념 설명
원리
기본 줄기
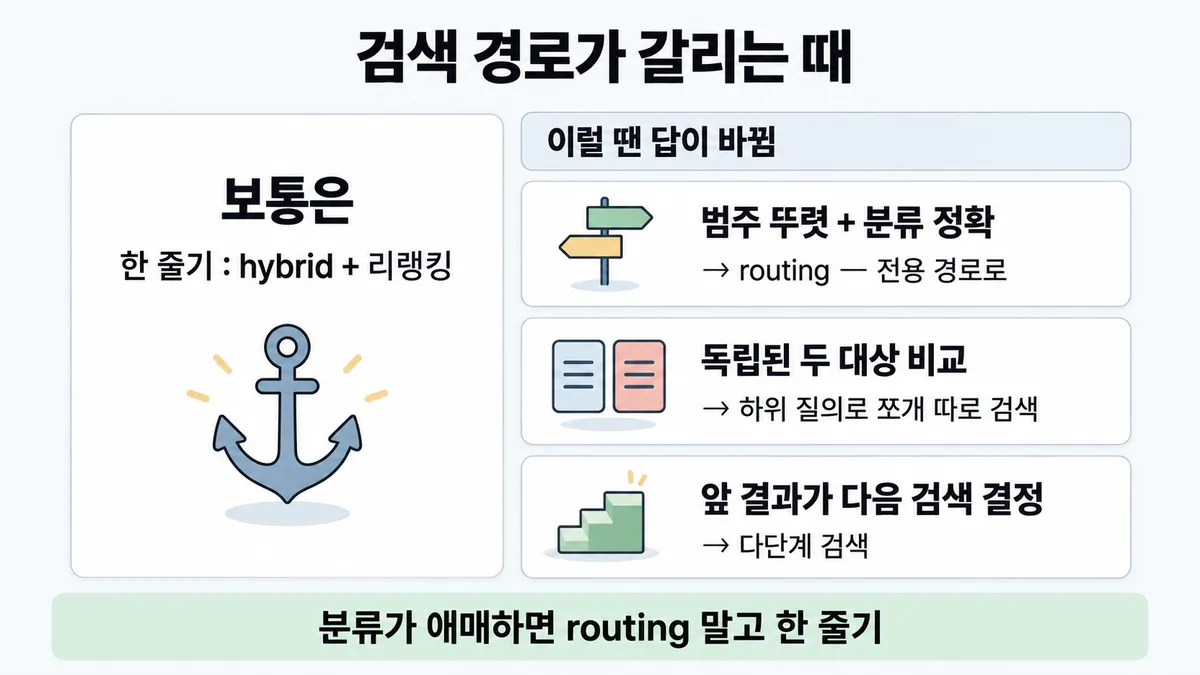
- 섞인 실제 지원 질문의 기본은 hybrid 검색(retrieval) + 리랭킹 하나다. 이득이 쌓인다.
routing(라우팅)
- 입력을 분류해 전용 프롬프트·도구·모델로 보낸다. 그러면 한 종류에 맞춘 최적화가 다른 종류를 깎는 것을 막는다.
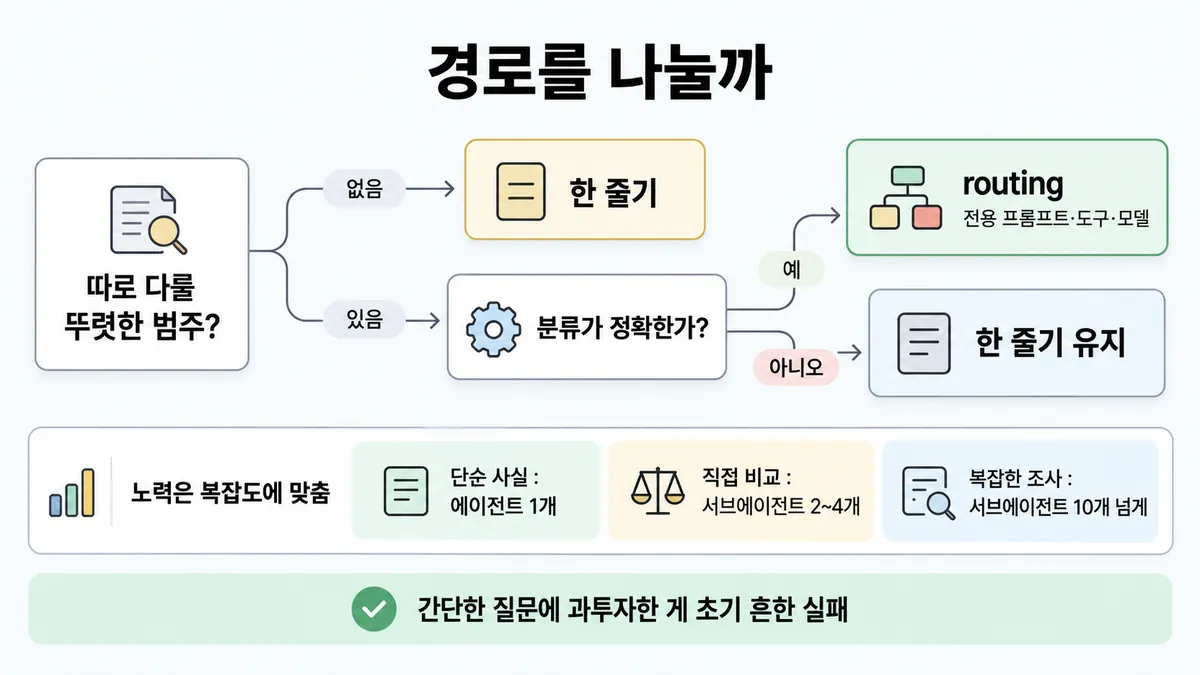
- 조건은 두 개다. 따로 다루는 게 나은 뚜렷한 범주가 있어야 한다. 그리고 분류가 정확해야 한다.
- 비용 쪽으로도 쓴다. 쉽고 흔한 질문은 작고 싼 모델로 보내고, 어렵고 드문 질문은 강한 모델로 보낸다.
쪼개기 · 다단계
- 쪼개기 : 어려운 질문을 작은 하위 과제로 나눈다. 비교 질문은 서로 독립인 하위 질의 둘로 나눈다.
- 다단계 : 정적 RAG 는 비슷한 chunk 를 한 번 가져온다. 다단계는 그 대신 결과를 보고 다음 검색을 정한다. 둘째 검색어가 첫 결과에 달려 있으면 이것을 쓴다.
- 노력은 복잡도에 맞춘다. 단순 사실은 에이전트 1개가 3~10회 호출한다. 비교는 서브에이전트 2~4개를 쓴다. 간단한 질문에 과투자한 것이 초기의 흔한 실패였다.
범위 필터
- 테넌트·날짜·권한은 검색 단계에서 메타데이터 필터나 네임스페이스로 거른다 (업계 일반).
핵심 질문 두 개
- 이 질문을 답하려면 검색이 몇 번, 어떤 순서로 필요한가?
- 질문 종류가 뚜렷이 갈리고, 그 분류를 정확히 할 수 있는가?
규칙과 판단
갈림길
①② 나눌까 [3.6②] [3.3③]
단일 파이프라인
기본값은 hybrid + 리랭킹이다. 이득이 쌓인다
routing
입력을 분류해 전용 프롬프트·도구·모델로 보낸다
routing 말고 단일 파이프라인
잘못 보낸 질문은 전용 경로에서 틀린다 (추론). routing 의 조건은 '분류가 정확할 때' 다
③④ 얼마나 검색 [3.6②]
에이전트 1개
도구를 3~10회 호출한다
서브에이전트 2~4개
서브에이전트마다 10~15회 호출한다
다단계 검색
결과를 보고 다음 검색을 정한다. 이것이 다단계 검색이다
서브에이전트 10개 넘게
간단한 질문에 과투자한 것이 초기의 흔한 실패였다
⑤⑥ index · 조회 · 필터 [3.6②]
그때 조회한다
index(색인)에 넣지 않는다. 질문마다 도구로 그때 조회한다(just in time). index 는 아무리 자주 다시 만들어도 낡을 수 있다
index + 검색 단계에서 막는다
문서는 index 에 넣는다 (나누는 방식은 추론). 테넌트·날짜 범위·접근 권한은 검색 단계에서 메타데이터 필터·네임스페이스로 강제한다 업계 일반
문서는 index 에 넣는다
문서는 index 에 넣고, 살아 있는 상태는 조회로 나눈다(나누는 방식은 추론)
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 질문 → 분류 → 전용 경로
블록 : 일반 질문, 환불, 기술지원
질문 : 이 질문은 어느 경로로 가야 할까?
① 뚜렷한 범주 ✓
- 시작 : 질문 — 말 : “어제 산 이어폰 환불하고 싶어요”
- 분류 : 환불 → 분류 : 입력을 분류한다 — 쪽지 : { 범주: "환불" }
- 보내기 : 분류 → 전용 경로 : 전용 프롬프트·도구·모델로 보낸다 — 쪽지 : 환불 프롬프트 / + 주문 조회 도구
- 끝 : 따로 다루는 게 나은 뚜렷한 범주가 있고, 분류가 정확하다. 그래서 전용 경로로 보낸다
② 분류가 애매 ≠
- 시작 : 질문 — 말 : “이어폰이 한쪽만 / 들려요. 환불돼요?”
- 분류 : 질문 → 분류 : 분류가 애매하다 — 쪽지 : { 범주: "기술지원" }
- 보내기 : 분류 → 전용 경로 : 잘못 보낸 질문은 틀린다 (추론) — 말 : “초기화 방법을 / 알려 드릴게요”
- 끝 : 환불 요청이 기술지원 경로로 가서 답이 빗나갔다. routing 의 조건은 '분류가 정확할 때' 다
규칙 원문 ①②③④⑤⑥ (갈림길로 그린 규칙)
-
기본값은 hybrid + 리랭킹이다. 이득이 쌓인다 [3.6②]
자세한 것은 ◆ 임베딩 vs BM25 vs hybrid · ■ RAG 파이프라인 에 있다
-
routing(라우팅) : 입력을 분류해 전용 프롬프트·도구·모델로 보낸다. 조건은 두 개다. 따로 다루는 게 나은 뚜렷한 범주가 있어야 한다. 그리고 분류가 정확해야 한다 [3.6②] [3.3③]
예를 들어 일반 질문·환불·기술지원을 서로 다르게 처리한다. 쉬운 질문은 작고 싼 모델(Haiku 4.5)로, 어렵거나 드문 질문은 강한 모델로 보낸다
안 나누면 한 종류에 맞춘 최적화가 다른 종류의 성능을 깎을 수 있다
-
쪼개기(decomposition)·다단계(multi-step) : 어려운 질문은 작은 하위 과제로 쪼갠다. 정적 RAG 는 비슷한 chunk 를 한 번 가져온다. 그 대신 결과를 보고 다음 검색을 정하는 다단계 검색을 쓴다 (둘 다 Research 에이전트 글이다. 에이전트 검색 맥락이다)
적용 예 : 'A·B 요금제 차이' 는 하위 질의 둘로 쪼갠다. '내 주문의 배송사 규정' 은 주문 조회로 배송사를 먼저 알아낸 뒤 규정을 검색한다 (적용 예는 업계 일반)
검색어는 짧고 넓게 시작해서 좁혀 간다
-
노력은 질문 복잡도에 맞춘다 (Research 시스템 프롬프트 규칙)
- 단순 사실 : 에이전트 1개 · 도구 호출 3~10회
- 직접 비교 : 서브에이전트 2~4개 · 각 10~15회
- 복잡한 조사 : 서브에이전트 10개 넘게
에이전트를 여럿 쓸지는 ◆ 단일 vs 멀티 에이전트 에서 다룬다. 간단한 질문에 과투자한 것이 초기의 흔한 실패였다
-
범위 필터 : 테넌트·날짜 범위·접근 권한은 검색 단계에서 메타데이터 필터·네임스페이스로 강제한다 업계 일반 공식 RAG 글에 없음. 권한 원칙은 ■ 최소 권한 에 있다
-
매 순간 바뀌는 운영 데이터(재고·잠금 상태·주문 상태)는 index 에 넣지 않는다. 질문마다 도구로 그때 조회한다(just in time). index 는 아무리 자주 다시 만들어도 낡을 수 있다
문서는 index 에 넣고, 살아 있는 상태는 조회로 나눈다(나누는 방식은 추론)
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 등급 | 근거 |
|---|---|---|---|
| 뜻 질문과 코드 질문이 섞인 일반 지원 질의다 | hybrid + 리랭킹 단일 파이프라인을 쓴다 | contextual-retrieval "All these benefits stack" | |
| 뚜렷한 범주가 있고 분류가 정확하다 | routing 한다 | building-effective-agents | |
| 쉬운 질문이 대부분이고 비용 압박이 있다 | 쉬운 것은 작은 모델로, 어려운 것은 강한 모델로 routing 한다 | building-effective-agents | |
| 비교 질문이다 | 하위 질의로 쪼갠다 | (원리) · 적용은 업계 일반 | multi-agent-research-system "decomposing difficult questions into smaller tasks" |
| 둘째 검색이 첫 결과에 달렸다 | 다단계 검색을 쓴다 | (원리) · 적용은 업계 일반 | multi-agent-research-system |
| 단순 사실 질문이다 | 가벼운 검색 1회로 끝낸다. 무거운 다단계 에이전트는 쓰지 않는다 | multi-agent-research-system | |
| 테넌트나 권한이 갈린다 | 검색 단계에서 필터나 네임스페이스로 거른다 | 업계 일반 | — (권한 원칙은 ■ 최소 권한) |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 질문 종류 | 한 종류뿐이다 | routing 이 필요 없다. 단일 파이프라인을 쓴다 | routing 조건 | |
| 분류 정확도 | 낮다 | routing 효과가 줄어든다. 잘못 보낸 질문이 전용 경로에서 틀린다 | 계산 | 뒤집히는 때 1 |
| 쉬운 질문 비율 | 높다 (예 70%) | 모델 routing 으로 비용이 약 절반이 된다 | 계산 | 뒤집히는 때 1 |
| 하위 질의 사이 관계 | 서로 독립이다 (A·B 비교) | 쪼개서 나란히 검색한다(병렬 가능) | 업계 일반 | 뒤집히는 때 3 |
| 하위 질의 사이 관계 | 앞 결과가 뒤 검색어를 정한다 | 순서대로 다단계로 검색한다 | 업계 일반 | 뒤집히는 때 3 |
| 테넌트 수 | 많다 | 검색 전 필터가 꼭 있어야 한다 (검색 후 거르면 남는 게 거의 없다) | 계산 | 뒤집히는 때 4 |
| 에이전트 수 | 여러 개를 검토한다 | 토큰이 채팅 대비 약 15배다. 자세한 것은 ◆ 단일 vs 멀티 에이전트 에 있다 | multi-agent-research-system |
연습 문제
쇼핑몰 지원 챗봇에 환불 · 기술지원 · 일반 질문이 뚜렷이 갈려 들어온다뚜렷한 범주. 환불 쪽 프롬프트를 다듬었더니 기술지원 답이 나빠졌다. 시험해 본 분류기는 1,000건 중 985건을 맞게 분류했다분류 정확. 운영팀은 "파이프라인 하나로 통일해야 운영이 쉽다"고 한다. 어떻게 해야 하나?
시험 대비
함정
- "모든 질문에 가장 무거운 다단계 에이전트 검색을 쓴다" 는 함정이다. 노력은 복잡도에 맞춘다. 초기 Research 에이전트의 실패가 바로 "간단한 질문에 서브에이전트 50개" 였다
- "파이프라인 하나로 통일해야 운영이 쉽다" 는 함정이다. 뚜렷이 갈리는 입력을 한 경로로 몰면 서로 성능을 깎는다. 단 기본 검색 줄기(hybrid+리랭킹)는 하나로 둬도 된다
- "분류가 애매한데도 routing 한다" 는 함정이다. routing 의 조건은 '분류가 정확할 때' 다. 잘못 보낸 질문은 전용 경로에서 틀린다 (추론)
- "권한 없는 문서는 답을 만든 뒤 걸러낸다" 는 함정이다. 문서는 가져오는 순간 컨텍스트에 들어간다. 그래서 검색 단계에서 막는다 업계 일반
- "비교 질문도 한 번에 검색한다" 는 함정이다. 한 질의로는 양쪽 chunk 가 다 안 올 수 있다. 그래서 쪼갠다 업계 일반
신호
"All these benefits stack"
"Routing works well for complex tasks where there are distinct categories that are better handled separately, and where classification can be handled accurately"
"Without this workflow, optimizing for one kind of input can hurt performance on other inputs."
"Routing easy/common questions to smaller, cost-efficient models"
"our architecture uses a multi-step search that dynamically finds relevant information, adapts to new findings, and analyzes results to formulate high-quality answers."
"Simple fact-finding requires just 1 agent with 3-10 tool calls, direct comparisons might need 2-4 subagents with 10-15 calls each"
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
1. 모델 routing — 싸지지만 분류가 흔들리면 손해
- 조건 : 하루 1만 질문이 오고, 쉬운 질문이 70% 다. 질문당 입력 3천 토큰, 출력 500 토큰이다. 백만 토큰당 가격은 다음과 같다.
- 강한 모델 : Opus 5.5($4 / $20)
- 작은 모델 : Haiku 4.5($1 / $5)
- 계산 :
- 전부 Opus 5.5 로 보내면 3천 × $4 + 500 × $20 = $0.012 + $0.010 = 질문당 $0.022 다.
- routing 하면 Haiku 4.5 는 질문당 $0.003 + $0.0025 = $0.0055 다. 섞으면 0.7 × $0.0055 + 0.3 × $0.022 = $0.01045 다. 분류기(Haiku 4.5, 입력 400 · 출력 10) $0.00045 를 더하면 $0.0109 다. 약 50% 가 줄어든다.
- 분류 정확도가 90% 면 어려운 질문 3천 건 중 약 300건이 작은 모델로 간다. 그 품질 손해가 절감을 넘는지는 eval 로 잰다.
- 등급 : 계산 (가격 = 2026-09-28 조회값 · routing 조건은 확인)
- 전제 : 두 모델의 출력 길이는 같다. 캐싱과 Batch 는 없다. 쉬운 질문은 작은 모델로도 품질이 유지된다.
- 근거 : ko-pricing · building-effective-agents
2. "모든 질문에 다단계 에이전트 검색"이 맞아 보이는 때
- 조건 : 질문 대부분이 chunk 하나면 답이 나오는 단순 사실이다.
- 판단 : 공식 Research 시스템도 단순 사실은 에이전트 1개 · 호출 3~10회로 제한한다. 멀티 에이전트는 채팅 대비 약 15배 토큰을 쓴다. 그래서 간단한 질문에는 과투자다. 무거운 경로는 비교형과 조사형에만 쓴다.
- 근거 : multi-agent-research-system
3. 쪼갤까, 순서대로 두 번 갈까
- 조건 A : "베이직·프로 요금제 차이" 를 묻는다. 두 요금제 chunk 는 서로 독립이다. 그래서 하위 질의 둘을 따로(동시에) 검색해 나란히 놓는다.
- 조건 B : "내 주문의 배송사 반품 규정" 을 묻는다. 배송사를 알아야 규정을 찾는다. 그래서 주문 조회, 배송사 확인, 규정 검색을 순서대로 한다.
- 판단 : 하위 질의가 독립이면 쪼갠다. 앞 결과가 뒤 검색어를 정하면 다단계로 검색한다.
- 등급 : 업계 일반 (쪼개기·다단계 원리 자체는 확인 — Research 글)
- 근거 : multi-agent-research-system
4. 테넌트 필터를 검색 뒤에 걸면
- 조건 : 테넌트 50곳의 문서를 한 index(색인)에 둔다. 상위 20개를 뽑은 뒤 내 테넌트 것만 남긴다.
- 계산 : 관련도가 테넌트와 무관하게 고르게 퍼져 있다고 둔다. 그러면 상위 20개 중 내 테넌트 몫은 평균 20 ÷ 50 = 0.4개다. 대부분 빈손이다. 검색 전에 필터(또는 테넌트별 네임스페이스)를 걸어야 상위 20개가 전부 내 것이 된다.
- 판단 : 권한 필터는 검색 단계에서 건다. 이유는 둘이다. 남의 문서가 컨텍스트에 들어가지 않게 하는 보안 때문이다. 그리고 재현율 때문이다.
- 등급 : 계산 (균등 분포 가정) · 필터 위치 원칙은 업계 일반
- 근거 : — (공식 RAG 글에 없다)
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "모든 질문에 가장 무거운 다단계 에이전트 검색" | 가장 강력한 방법이면 다 잡을 것 같다 | 노력은 복잡도에 맞춘다. 초기 실패가 바로 간단한 질문에 서브에이전트 50개를 쓴 것이다 | multi-agent-research-system | |
| "파이프라인 하나로 통일해야 운영이 쉽다" | 운영을 단순하게 하려는 습관이다 | 뚜렷이 갈리는 입력을 한 경로로 몰면 서로 성능을 깎는다 | building-effective-agents | |
| "분류가 애매해도 일단 routing" | 나누면 전문화될 것 같다 | 조건은 '분류가 정확할 때' 다. 잘못 보낸 질문은 전용 경로에서 틀린다 | (조건) | building-effective-agents |
| "쉬운 질문도 가장 강한 모델로 (품질 우선)" | 품질이 걱정된다 | 공식 예가 바로 쉬운 질문을 작은 모델로 보내는 routing 이다 | building-effective-agents | |
| "권한 없는 문서는 답을 만든 뒤 걸러냄" | 후처리가 쉬워 보인다 | 가져오는 순간 컨텍스트에 들어간다. 그리고 상위 K 가 비어 버린다 | 업계 일반 · 계산 | 뒤집히는 때 4 |
| "비교 질문도 한 번에 검색" | 질문이 한 문장이라서다 | 한 질의로는 양쪽 chunk 가 다 안 올 수 있다 | 업계 일반 | 뒤집히는 때 3 |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 3.6 공식 시험 가이드 v1.0
- 가이드 목표 3.3 공식 시험 가이드 v1.0
- Contextual Retrieval 글
- building-effective-agents
- multi-agent-research-system
- effective-context-engineering (⑥)
상태
- 고침 1곳(③ 쪼개기·다단계 : 목록 '일반 관행' 을 Research 글로 확인했다)
- 업계 일반 1줄(⑤)과 적용 예
미해결
- 쪼개기·다단계의 공식 근거는 Research(멀티 에이전트 웹 검색) 글이다. 단일 RAG 파이프라인 안의 query decomposition(질의 분해)을 다룬 Anthropic 문서는 못 찾았다 (검색 범위 = 받아 둔 raw 원문 전체).
- 메타데이터 필터·네임스페이스 : 받아 둔 공식 원문에서 검색 단계 권한 필터 문장을 못 찾았다(grep "metadata filter|tenant|namespace"). 걸린 파일은 MCP 인증(authentication)·SDK 배포 문서뿐이고, RAG 맥락이 아니다. 그래서 업계 일반으로 둔다.
- 목록 3.6② 는 쪼개기·다단계를 "일반 관행 — 근거 확인 필요"로 적었다. Research 글로 원리를 확인해 등급을 올렸다(적용 예는 업계 일반으로 둔다).