◆ pass@k vs pass^k
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 4.1 평가 지표 정하기 · D4 평가 16%Define evaluation metrics (accuracy, latency, cost, safety, security)
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 4.1③ 재시도 없는 고객 대면 에이전트 — pass@k 인가 pass^k 인가? — 비결정성을 담는 신뢰성 지표 고르기
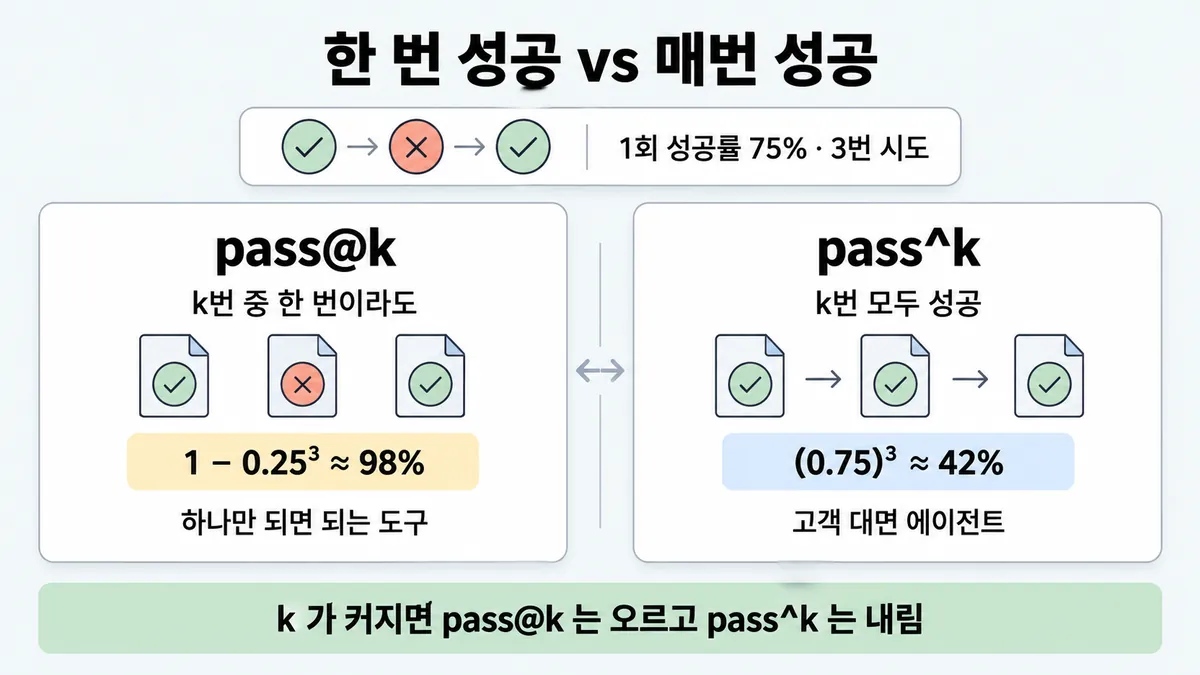
한눈에
ELI5
농구 자유투를 떠올려 보세요.
- "세 번 던져서 한 번만 들어가면 돼"는 쉬운 시험이에요.
- "세 번 던져서 세 번 다 들어가야 해"는 어려운 시험이에요.
- 같은 선수여도 어떤 시험이냐에 따라 점수가 크게 달라요.
- 손님을 상대하는 일은 매번 들어가야 하는 쪽이에요.
개념 설명
원리
왜 여러 번 돌리나
- 에이전트는 같은 과제도 실행마다 결과가 다르다. 한 번 통과한 과제가 다음에는 실패할 수 있다.
- 그래서 과제마다 여러 번 시도(trial)한다. 그리고 "얼마나 자주" 성공하는지를 본다.
- 과제마다 성공률도 다르다(어떤 것은 90%, 어떤 것은 50%).
두 지표
- pass@k : k번 중 적어도 한 번 성공할 확률이다. k 가 커질수록 오른다("슛 기회"가 많을수록).
- pass^k : k번 모두 성공할 확률이다. k 가 커질수록 내린다(일관성 요구가 커진다).
- k = 1 이면 둘 다 1회 성공률로 같다. k = 10 이면 pass@k 는 100% 쪽, pass^k 는 0% 쪽으로 간다. 두 지표가 정반대 이야기를 한다.
고르는 기준은 제품 요구다
- 후보를 여러 개 내고 하나만 맞으면 되는 일에는 pass@k 를 쓴다.
- 사용자가 매번 믿을 만한 동작을 기대하는 고객 대면 에이전트에는 pass^k 를 쓴다.
- 코딩은 첫 시도 해결(pass@1)을 가장 중시한다.
숫자가 믿을 만하려면
- 시도가 서로 독립이어야 한다. 깨끗한 환경에서 시작하지 않으면 남은 파일·캐시·자원 고갈로 같이 실패할 수 있다. 또는 앞 시도의 흔적을 보고 점수가 부풀려진다.
- 프런티어 모델이 여러 번 다 0% 면 대개 과제가 잘못된 것이다.
핵심 질문 두 개
- 사용자(또는 다음 단계)가 받는 것은 k번 중 가장 좋은 하나인가, 매번의 결과인가?
- 이 k번은 서로 독립인가?
규칙과 판단
갈림길
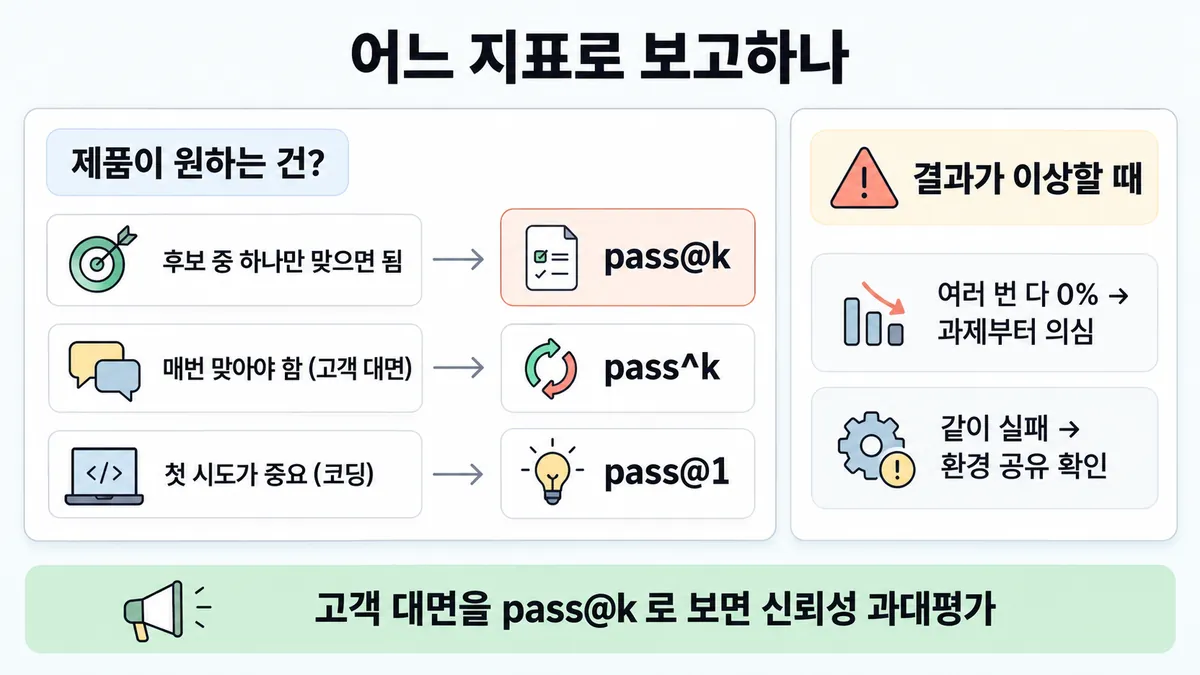
어느 지표 [4.1③]
pass@k
pass@k 는 k번 중 적어도 한 번 성공할 확률이다. 하나만 되면 되는 도구에 쓴다
pass^k
pass^k 는 k번 모두 성공할 확률이다. 일관성이 핵심인 에이전트에 쓴다
pass@1
코딩은 첫 시도 해결을 가장 중시한다
숫자 읽기 [4.1③]
오른다
기회가 많을수록 한 번은 성공할 확률이 오른다. k=10 이면 100% 에 다가간다
내린다
모두 성공해야 해서 더 어렵다. k=10 이면 0% 로 내려간다
같다
둘 다 1회 성공률과 같다
결과가 이상할 때 [4.1③] [4.2]
과제부터 의심한다
프런티어 모델에서 여러 시도가 0% 면 대개 과제가 잘못된 것이다. 에이전트가 못해서가 아니다. 그래서 과제 명세와 grader(채점기)를 확인한다
환경 공유를 확인한다
시도마다 깨끗한 환경에서 시작한다. 공유 상태가 있으면 인프라 때문에 같이 실패한다(독립이 아니다)
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 과제 → 시도 k번 → 판정
규칙 (판정) : pass@k 는 한 번이라도 · pass^k 는 k번 모두
질문 : 3번 중 몇 번 성공해야 통과일까?
① 하나만 되면 되는 도구는 pass@k ✓
- 시작 : 과제 — 쪽지 : 상담원용 답 초안 / 후보 3개 중 하나만 쓰면 됨
- 시도 : 과제 → 시도 k번 : 3번 · 1회 성공률 75% — 쪽지 : 시도 1 ✓ / 시도 2 ✗ / 시도 3 ✓
- 판정 : 시도 k번 → 판정 : 한 번이라도 성공하면 통과한다 — 쪽지 : 이 과제 : ✓ 있음 / → 통과
- 셈 : 판정 : k번 중 적어도 한 번 성공할 확률 — 쪽지 : pass@3 = 1 − 0.25³ / ≈ 98%
- 끝 : 후보 중 하나만 맞으면 되는 도구에는 pass@k 를 쓴다. pass@3 ≈ 98% 다
② 고객 대면 에이전트는 pass^k ✓
- 시작 : 과제 — 쪽지 : 고객 문의에 바로 답함 / 재시도 없음
- 시도 : 과제 → 시도 k번 : 3번 · 1회 성공률 75% — 쪽지 : 시도 1 ✓ / 시도 2 ✗ / 시도 3 ✓
- 판정 : 시도 k번 → 판정 : k번 모두 성공해야 통과한다 — 쪽지 : 이 과제 : ✗ 하나 / → 통과 못 함
- 셈 : 판정 : k번 모두 성공할 확률 — 쪽지 : pass^3 = (0.75)³ / ≈ 42%
- 끝 : 매번 맞아야 하는 고객 대면 에이전트에는 pass^k 를 쓴다. pass^3 ≈ 42% 다
③ 고객 대면을 pass@k 로 본다 ≠
- 시작 : 과제 — 쪽지 : 고객 문의에 바로 답함 / 재시도 없음
- 시도 : 과제 → 시도 k번 : 3번 · 1회 성공률 75% — 쪽지 : 시도 1 ✓ / 시도 2 ✗ / 시도 3 ✓
- 판정 : 시도 k번 → 판정 : 한 번이라도 성공하면 통과한다 — 쪽지 : 이 과제 : ✓ 있음 / → 통과
- 보고 : 판정 : 한 번 성공 기준으로 보고한다 — 쪽지 : 보고서 : "pass@3 ≈ 98%"
- 끝 : 고객 대면을 pass@k 로 보면 높게 나온다. 그래서 신뢰성을 과대평가한다. 사용자는 매번 믿을 만한 동작을 기대한다
반복
과제 100개를 k번씩 모의로 돌려 보기
가정1회 성공률 75% 는 공식 글의 예시 값이다. 과제마다 같고 시도끼리 독립이라고 본다. 실제 측정값이 아니다
1회 성공률 75% 과제 100개 — 과제마다 k 번 시도 (모의)
성공한 시도실패한 시도칸 하나 = 과제 하나 · 막대 하나 = 시도 하나
굵은 테두리 = 고른 지표로 통과한 과제 · 세로 눈금 = 계산값(pass@k = 1 − 0.25k · pass^k = 0.75k). 칸은 75% 확률로 만든 모의 시행이라 다시 돌리면 조금씩 달라요.
규칙 원문 갈림 기준 셈 시도 믿기 (갈림길로 그린 규칙)
갈림 기준
제품이 "한 번 성공"을 원하나, "매번 성공"을 원하나?
- 에이전트 동작은 실행마다 다르다. 그래서 한 번 돌려서 판단하지 않는다. 과제마다 여러 번 시도(trial)한다
- pass@k 는 k번 시도 중 적어도 한 번 맞을 확률이다. 하나만 되면 되는 도구에 쓴다. 여러 해답을 내고 하나만 맞으면 되는 일에도 쓴다
- pass^k 는 k번 모두 맞을 확률이다. 일관성이 핵심인 에이전트에 쓴다. 사용자가 매번 믿을 만한 동작을 기대하는 고객 대면 에이전트에는 특히 중요하다
- 코딩은 첫 시도 해결, 곧 pass@1 을 가장 중시한다
- 둘 다 쓸모 있다. 고르는 기준은 제품 요구다
셈
- pass^k = p^k (1회 성공률 p) : 75% 로 3번이면 (0.75)³ ≈ 42% 다
- pass@k = 1 − (1 − p)^k 다. 75% 로 3번이면 1 − 0.25³ ≈ 98% 다 계산 공식은 식 없이 정의만, 시도 독립 가정
- k = 1 이면 둘 다 1회 성공률과 같다. k = 10 이면 pass@k 는 100% 로, pass^k 는 0% 로 간다
- "50% pass@1" 은 첫 시도에 과제 절반을 성공했다는 뜻이다
시도 믿기 (과제·환경 만들기 본문 = ■ 첫 eval 셋 만들기)
- 시도마다 깨끗한 환경에서 시작한다. 남은 파일 · 캐시 데이터 · 자원 고갈 같은 공유 상태가 있으면, 에이전트가 아니라 인프라 때문에 같이 실패한다(독립이 아니다). 앞 시도의 git 기록을 보고 점수가 부풀기도 한다
- 프런티어 모델이 여러 시도에서 0%(0% pass@100)면 대개 과제가 잘못된 것이다. 과제 명세와 grader 를 확인한다. 과제마다 참고 해답(reference solution)을 둔다
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 등급 | 근거 |
|---|---|---|---|
| 에이전트 성능을 잴 때 | 과제마다 여러 번 시도한다 | demystifying-evals | |
| 하나만 성공하면 되는 도구다 · 여러 해답 중 하나만 맞으면 된다 | pass@k | demystifying-evals | |
| 매번 성공해야 하는 고객 대면 에이전트다 | pass^k | demystifying-evals "This metric especially matters for customer-facing agents where users expect reliable behavior every time." | |
| 코딩 에이전트다 | pass@1 을 중시한다 | demystifying-evals | |
| 1회 성공률 p 로 k번 모두 성공한다 | p^k (75% 로 3번이면 ≈ 42%) | demystifying-evals | |
| 1회 성공률 p 로 적어도 한 번 성공한다 | 1 − (1 − p)^k | 계산 | 정의에서 (시도 독립 가정) |
| 여러 시도가 전부 0% 다 | 과제 명세와 grader(채점기)부터 확인한다 | demystifying-evals | |
| 시도끼리 같이 실패한다 | 환경 공유 상태를 없앤다. 시도마다 깨끗한 환경에서 시작한다 | demystifying-evals |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 결과를 받는 쪽 | 사용자가 매 상호작용을 받는다 | pass^k | demystifying-evals | |
| 결과를 받는 쪽 | 여러 후보 중 맞는 것을 고를 수 있다 | pass@k | demystifying-evals | |
| 성공 판별 | 자동으로 할 수 있다(테스트 통과 · 스키마 검증) | 자동 재시도와 pass@k 가 설 자리가 있다 | 업계 일반 | 뒤집히는 때 1 |
| k | 1 | 두 지표가 같다 | demystifying-evals | |
| k | 크게(10) | pass@k 는 100% 로, pass^k 는 0% 로 간다 | demystifying-evals | |
| 과제별 성공률 | 들쭉날쭉하다 | 과제마다 계산한 뒤 평균한다 | 계산 | 뒤집히는 때 3 |
| 환경 | 시도 사이에 공유 상태가 있다 | 숫자를 믿지 못한다 | demystifying-evals |
연습 문제
고객지원 Agent 가 재시도 없이 고객에게 바로 답한다매번 성공. 과제마다 3번씩 돌려 보니 1회 성공률이 75% 였다. 팀원은 보고서에 "pass@3 ≈ 98%" 라고 적자고 한다. 무엇으로 보고해야 할까?
시험 대비
함정
- 재시도 없는 고객 대면 에이전트를 pass@k 로 보는 것은 함정이다. 높게 나와서 신뢰성을 과대평가한다. pass^k 를 쓴다
- "몇 번 돌려 한 번 되면 됐다" 는 함정이다. 그건 pass@k 다. 매번 돼야 하면 pass^k 를 쓴다
- 실행 1회 정확도로 판단하는 것은 함정이다. 실행마다 달라서 여러 번 시도한다
- pass^k 를 "k번의 평균 성공률"로 읽는 것은 함정이다. pass^k 는 모두 성공할 확률이다. k 가 커질수록 내려간다
- "pass@k 가 올랐으니 에이전트가 좋아졌다" 는 함정이다. k 만 늘려도 오른다
- 신뢰성을 물었는데 TTFT 같은 지연(latency) 지표를 고르는 것은 함정이다. 다른 차원이다. 자세한 것은 ◆ TTFT vs 응답 완료 지연 에 있다
- 0% pass@100 을 "모델이 못 한다"로 읽는 것은 함정이다. 과제 결함부터 본다
신호
"pass@k for tools where one success matters, pass^k for agents where consistency is essential."
"This metric especially matters for customer-facing agents where users expect reliable behavior every time."
"If your agent has a 75% per-trial success rate and you run 3 trials, the probability of passing all three is (0.75)³ ≈ 42%."
"In coding, we’re often most interested in the agent finding the solution on the first try—pass@1."
"At k=1, they're identical (both equal the per-trial success rate)."
"Because model outputs vary between runs, we run multiple trials to produce more consistent results."
"With frontier models, a 0% pass rate across many trials (i.e. 0% pass@100) is most often a signal of a broken task, not an incapable agent"
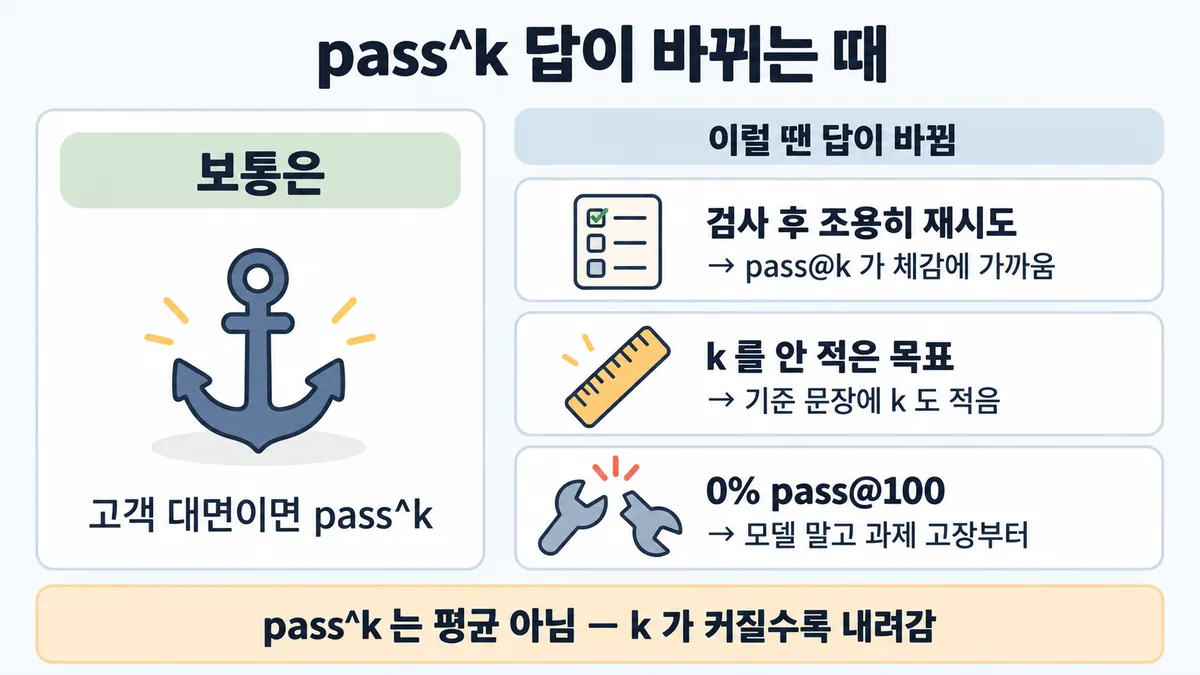
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
1. 고객 대면인데 pass@k 가 설 자리가 있는 때
- 조건 : 아래가 모두 맞다.
- 에이전트가 사용자에게 내보내기 전에 결과를 자동으로 검사할 수 있다(예 : 환불 금액이 규칙 범위 안인지, 응답이 스키마를 통과하는지)
- 실패하면 시스템이 조용히 다시 돌린다. 최대 3번이다
- 1회 성공률은 70% 다
- 계산 : 사용자가 받는 결과의 성공률 = 1 − 0.3³ = 97.3% 다. 평균 호출 수 = 1 + 0.3 + 0.09 = 1.39번이다.
- 판단 : 사용자가 받는 것은 "검사를 통과한 하나"다. 그래서 pass@3 이 사용자 체감에 가깝다. 단 검사기가 성공을 정확히 가려야 한다. 그리고 호출 수만큼 비용과 지연(latency)이 늘어난다. 검사기가 없으면 원래대로 pass^k 를 쓴다.
- 전제 : 시도는 독립이다. 검사기는 오판하지 않는다.
- 등급 : 계산 · 업계 일반(공식 글은 이 경우를 말하지 않음)
- 근거 : demystifying-evals
2. k 를 안 적은 pass^k 목표는 뜻이 없다
- 조건 : "pass^k 80% 이상"을 목표로 적었다. 1회 성공률은 90% 다.
- 계산 : pass^2 = 0.81 이라 통과한다. pass^5 = 0.9⁵ ≈ 0.59 라 불합격이다. pass^10 = 0.9¹⁰ ≈ 0.35 다. 같은 에이전트가 k 에 따라 합격하기도 하고 불합격하기도 한다.
- 판단 : 기준 문장에 k 를 함께 적어야 한다(■ 성공 기준 의 "측정 가능"). 공식 그림도 k 가 커질수록 두 지표가 벌어지는 것을 보여 준다.
- 등급 : 계산
- 근거 : demystifying-evals
3. 과제 평균 성공률로 pass^k 를 셈하면 틀린다
- 조건 : 과제 A 성공률은 95%, 과제 B 는 45% 다(평균 70%). k = 3 이다.
- 계산 : 평균으로 세면 0.7³ ≈ 34% 다. 과제마다 세면 (0.95³ + 0.45³) ÷ 2 = (0.857 + 0.091) ÷ 2 ≈ 47% 다.
- 판단 : 성공률은 과제마다 다르다. 그래서 과제별로 pass^k 를 구한 뒤 평균한다. 그리고 B 처럼 낮은 과제를 따로 봐야 어디서 깨지는지 보인다.
- 등급 : 계산 (과제마다 성공률이 다르다는 것은 확인)
- 근거 : demystifying-evals
4. 0% 인데 모델 탓이 아닐 때
- 조건 : 과제 하나가 100번 시도 모두 실패했다(0% pass@100).
- 판단 : 프런티어 모델에서 이것은 대개 과제 결함 신호다. 예를 들어 과제 설명에 없는 파일 경로를 grader 가 기대한다. 모델을 바꾸기 전에 과제 명세와 grader 를 본다. 그리고 참고 해답이 grader 를 통과하는지 확인한다.
- 근거 : demystifying-evals
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 근거 |
|---|---|---|---|
| 재시도 없는 고객 대면 에이전트에 pass@k | 숫자가 높고 흔히 들어 본 지표다 | pass@k 는 한 번 성공이 중요한 도구용이다. 매번 성공해야 하면 pass^k 를 쓴다 | demystifying-evals |
| 실행 1회 정확도로 판단 | 간단하다 | 실행마다 결과가 달라서 여러 번 시도해야 한다 | demystifying-evals |
| "pass^k 는 k번 성공률의 평균" | 이름이 평균처럼 보인다 | 모두 성공할 확률이다. k 가 커질수록 내린다 | demystifying-evals |
| "75% 로 3번이면 pass^3 = 75%" | 1회 성공률을 그대로 옮겼다 | (0.75)³ ≈ 42% 다 | demystifying-evals |
| "pass@k 가 올랐으니 개선" | 점수가 올랐다 | k 만 늘려도 오른다 | demystifying-evals |
| 신뢰성 문항에서 TTFT 같은 지연 지표 | 같은 "지표 고르기" 목표(4.1)다 | 다른 차원이다. 자세한 것은 ◆ TTFT vs 응답 완료 지연 에 있다 | reduce-latency |
| "0% 면 모델이 못 하는 것" | 결과가 명확해 보인다 | 대개 과제 결함이다 | demystifying-evals |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
미해결
- 목록 4.1③ 은 pass@k 를 "재시도 가능한 도구", pass^k 를 "재시도 없음"으로 적었다. 공식 문장은 "one success matters" · "consistency is essential" · "reliable behavior every time" 이고, "재시도"라는 말은 없다. 목록의 재시도 표현은 해석이다.
- pass@k 식 1 − (1 − p)^k 는 공식 글에 없다(정의만 있다. 링크된 2019 논문은 받지 않았다). 시도 독립을 가정한다.
- 목록 4.1③ 의 영어 신호 두 문장은 원문에서 찾았다. "pass^3 ≈ 42%" 와 "코딩은 pass@1" 도 확인했다.
- 한국어판은 없다 (anthropic.com/engineering 글). 영어 원문만 본다.