◆ effort 조정 vs 모델 교체
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 2.1 모델 고르기 · D2 모델·프롬프트 13%Select appropriate Claude models based on trade-offs
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 2.1② 품질이 조금 모자라거나 비용이 남는다 — 모델을 바꿀까, effort 를 바꿀까? — 조절 수단 순서 (effort → 모델 교체 → 섞인 요청은 모델 조합·라우팅)
- 3.3① 상담원이 "답 초안이 늦게 뜬다"고 한다 — 모델부터 바꾸나? — 지연 lever 고르기 (스트리밍 · 캐싱 · 출력 길이 · effort · 모델 교체)
- 4.5② 보기마다 다른 최적화 — 이 시나리오의 레버는 무엇 하나? — 시나리오 단서 → 레버 하나 (캐싱 · 배치 · 라우팅/effort · 스트리밍)
한눈에
ELI5
자전거로 언덕을 못 오르면 자전거를 새로 사기 전에 기어부터 바꿔 봐요.
- 기어를 바꾸는 건 공짜고 금방 해 볼 수 있어요.
- 기어를 다 바꿔도 안 되면 그때 더 좋은 자전거를 사요.
- 길 대부분이 평지고 언덕이 가끔이면, 언덕에서만 힘센 친구에게 밀어 달라고 해요.
- 그런데 친구를 불러야 할 때 안 부르면 소용없어요.
개념 설명
원리
effort 가 하는 일
- effort 는 한 모델 안에서 지능과 지연(latency)·비용을 맞바꾸는 lever(조절 수단)다. 요청의
output_config.effort로 정한다 (2026-09-28 조회). - effort 는 모든 출력 토큰에 걸린다. 텍스트 · 도구 호출 · thinking(사고)이 다 든다. 낮추면 도구 호출도 적어지고 짧아진다. adaptive thinking 에서는 얼마나 자주, 얼마나 깊게 생각할지도 정한다.
- 비용은 모델이 하는 일(thinking·도구 호출·자기 검증)에 비례한다. 정확도는 과제가 필요로 하는 만큼만 오른다. 그래서 모델 한계 아래에서 높은 effort 는 과제가 쓰지 않는 깊이에 비용을 치른다.
왜 effort 가 먼저인가
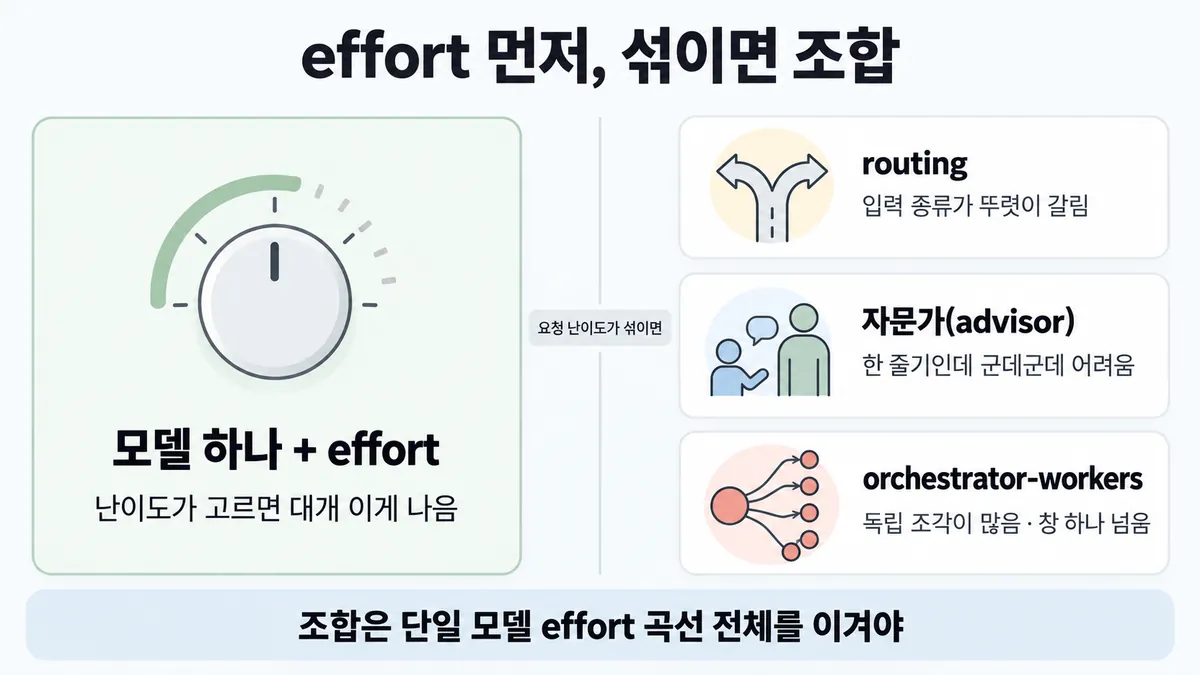
- 가장 싼 실험이다. 대부분의 워크로드는 여기서 끝난다.
- 공식 측정에서 "기본 설정 모델 하나보다 싸 보였던 다중 모델 구성"이 같은 모델을 낮은 effort 로 돌린 것보다 비쌌다. 한 벤치마크에서는
low가 Sonnet 5 worker 를 둔 orchestrator 구성과 같은 점수를 29% 싸게 냈다. 그래서 "effort 낮추기가 구조 변경을 이긴다".
곡선 모양은 워크로드마다 다르다 (Anthropic 내부 측정, 방향성)
- 연구·지식 작업은 거의 평평하다.
low는 1~3점 손해에 과제당 비용을 3분의 1~절반 아낀다(원래 비용의 절반~3분의 2 만 든다).medium은 기본과 같은 정확도에 비용이 70~87% 다. - 긴 코딩은 가파르다. Opus 5.5 를
high와 비교하면 아래와 같다.medium(기본) : 약 −2.5점, 비용 약 70%low: 약 −8점, 비용 약 3분의 1(약 3분의 2 절감)xhigh: 약 +1.4점, 비용 2.5배
- 그래서 과제 설명만으로는 어느 쪽인지 모른다. 2~3단계를 자기 트래픽 표본으로 잰다. 단계마다 세션을 따로 둔다. 중간에 바꾸면 캐시가 깨져 비교가 흐려진다.
모델 조합은 "섞임"이 있을 때만
- 쉬운 일과 어려운 일이 섞여 있으면 최상위 모델은 어려운 곳에만 쓴다. 대부분의 토큰은 싼 모델 단가로 낸다.
- 섞임이 없으면(난이도가 일정하거나 순차 의존 체인) 잘 맞춘 모델 하나가 대개 낫다.
- 두 전략은 누가 루프를 쥐는지로 갈린다.
- 자문가(advisor) : 싼 실행자가 루프를 쥔다. 막히면 최상위 모델에 묻는다. 이득은 "모델 격차"와 "실행자가 실제로 묻는 비율(자문 비율)"이 정한다.
- orchestrator : 최상위 모델이 루프를 쥐고 계획·분배·통합을 한다. worker 가 대량 탐색을 흡수한다. 넘길 대량 작업(독립 조각 · 컨텍스트 창 하나 초과)이 있어야 쓸 만하다.
- routing(라우팅)은 입력을 분류해 쉬운 질문은 작은 모델에, 어려운 질문은 강한 모델에 보낸다. 뚜렷한 범주와 정확한 분류가 조건이다. 자세한 것은 ■ 워크플로 5패턴 에 있다.
규칙과 판단
갈림길
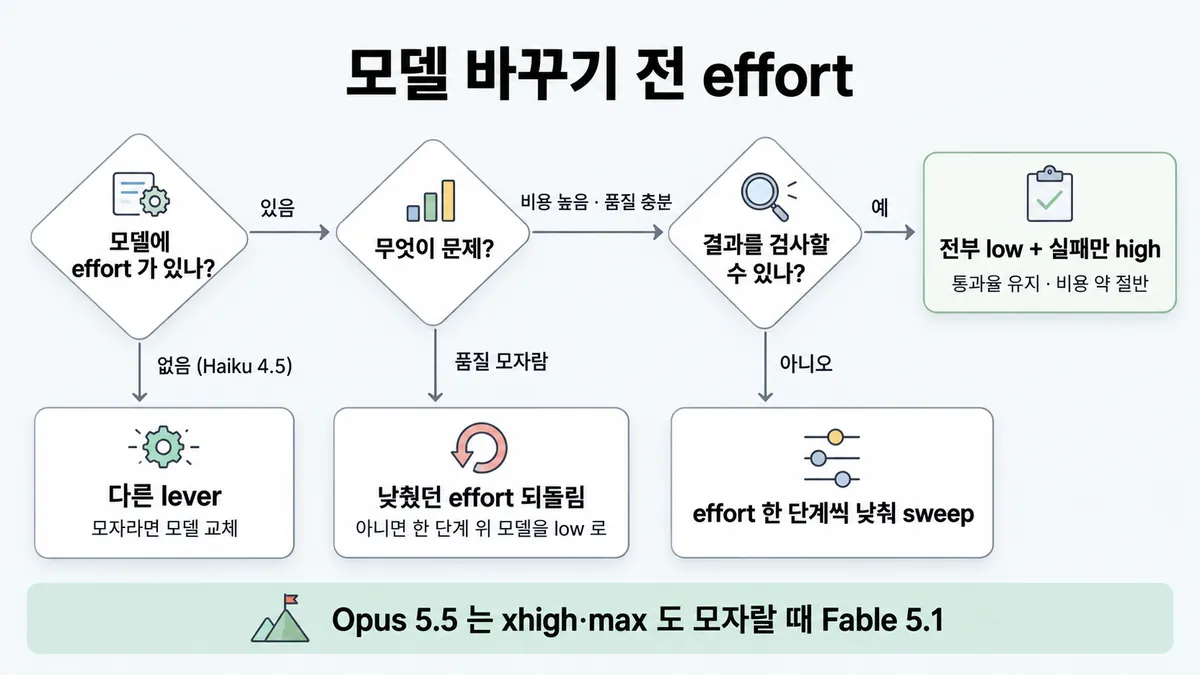
먼저 effort [2.1②]
다른 lever 를 쓴다
이 모델은 effort 를 지원하지 않는다. thinking(사고) 양은 ■ 모델별 thinking 제어 에 있다. 모자라면 모델을 바꾼다 업계 일반
전부 low + 실패만 high
전부 low 로 돌리고 실패한 것만 high 로 다시 돌린다. 통과율은 유지되고 비용은 약 절반이 된다
effort 를 낮춘다
지금 모델에서 effort 를 한 단계씩 낮춰 가며 시험한다(sweep)
되돌린다
낮췄던 effort 를 되돌린다
xhigh·max 를 먼저 쓴다
Opus 5.5 는 xhigh·max 도 모자랄 때 Fable 5.1 로 올린다
한 단계 위 모델로 간다
한 단계 위 모델을 low effort 로 돌린다
섞인 요청 [2.1②]
모델 하나를 쓴다
잘 맞춘 모델 하나가 대개 낫다
routing
쉬운 질문은 작은 모델에, 어려운 질문은 강한 모델에 보낸다. 자세한 것은 ■ 워크플로 5패턴 에 있다
자문가(advisor)
싼 실행자가 루프를 돌고 어려운 결정만 최상위 모델에 묻는다
orchestrator-workers
최상위 모델이 계획하고 통합한다. worker 가 대량 작업을 맡는다. 자세한 것은 ■ orchestrator-worker 위임 에 있다
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 요청 → 라우터 → 싼 모델 → 최상위 모델
질문 : 어느 모델이 답해야 할까?
① 섞인 요청 → routing ✓
- 시작 : 요청 — 쪽지 : 질문 1: 비밀번호 재설정은? / 질문 2: 약관 7조 위약금 / 이사 가면 면제돼요?
- 분류 : 요청 → 라우터 : 쉬운 질문과 어려운 질문을 가른다 — 쪽지 : 질문 1 = 쉬움 / 질문 2 = 어려움
- 쉬움 : 라우터 → 싼 모델 : 대부분의 토큰을 싼 단가로 낸다 — 말 : “설정 > 보안에서 재설정하세요.”
- 어려움 : 라우터 → 최상위 모델 : 최상위 모델은 중요한 곳에만 쓴다 — 말 : “7조 2항에 따라 이사는 면제 사유예요.”
- 끝 : 입력 종류가 뚜렷이 갈리고 분류가 정확할 때 쓴다
② 자문가(advisor) ✓
- 시작 : 요청 — 쪽지 : 과제: 결제 모듈 버그 수정 / 20단계 순차 작업
- 실행 : 요청 → 싼 모델 : 싼 실행자가 루프를 돌린다 — 쪽지 : 1~12단계 완료 / 13단계: 락 순서가 애매
- 자문 : 싼 모델 → 최상위 모델 : 어려운 결정만 묻는다 — 말 : “락은 주문 먼저, 결제는 그다음.”
- 끝 : 최상위 모델 비용은 자문할 때만 든다
③ 실행자 effort 를 낮추면 자문이 끊긴다 ≠
- 시작 : 요청 — 쪽지 : 과제: 결제 모듈 버그 수정 / 20단계 순차 작업
- 실행 : 요청 → 싼 모델 :
loweffort 로 돌린다 — 쪽지 : effort: "low" / 13단계 그냥 진행 - 자문 : 싼 모델 : 막힌 것을 못 알아챈다 ≠ — 쪽지 : 자문 요청 0번 / 13단계 락 순서 틀림
- 건너뜀 : 최상위 모델
- 끝 : 실행자 혼자보다 점수가 낮아질 수 있다
규칙 원문 갈림 기준 (갈림길로 그린 규칙)
갈림 기준
같은 모델의 effort 를 먼저 본다 (2026-09-28 조회)
먼저 effort : 같은 모델에서 effort 를 2~3단계 훑어(sweep) eval 곡선을 본다. 모델 바꾸기보다 나은 경우가 많다. 대부분의 워크로드는 여기서 끝난다
- 비용이 높고 품질은 충분하면 지금 모델에서 effort 를 한 단계씩 낮춰 가며 시험한다(sweep)
- 품질이 모자라면 낮췄던 effort 를 되돌린다. 낮춘 적이 없으면 한 단계 위 모델을
loweffort 로 돌린다. Opus 5.5 는xhigh·max도 모자랄 때 Fable 5.1 로 올린다 - 결과를 검사할 수 있으면(테스트·검증기) 전부
low로 돌리고 실패한 것만high로 다시 돌린다. 통과율은 유지되고 비용은 약 절반이 된다 (실패한 건은 두 번 도는 만큼 지연(latency)이 늘어난다) - effort 미지원 모델(Haiku 4.5)에는 이 lever(조절 수단)가 없다. thinking 양은 ■ 모델별 thinking 제어 에 있다. 모자라면 모델을 바꾼다 업계 일반
- 요청 난이도가 섞이면 조합을 쓴다. 싼 모델과 최상위 모델을 짝지어 대부분의 토큰을 싼 단가로 낸다. 최상위 모델은 중요한 곳에만 쓴다
- 입력 종류가 뚜렷이 갈리고 분류가 정확하면 routing(라우팅)을 쓴다. 쉬운 질문은 작은 모델에, 어려운 질문은 강한 모델에 보낸다. 자세한 것은 ■ 워크플로 5패턴 에 있다
- 순차 작업인데 군데군데 어려우면(코딩 에이전트·다단계 연구) 자문가(advisor)를 쓴다. 싼 실행자가 루프를 돌고 어려운 결정만 최상위 모델에 묻는다. 최상위 모델 비용은 자문할 때만 든다
- 서로 독립인 조각이 많으면 orchestrator-workers 를 쓴다. 특히 컨텍스트 창 하나를 넘을 때다. 최상위 모델이 계획하고 통합한다. worker 가 대량 작업을 맡는다. 자세한 것은 ■ orchestrator-worker 위임 에 있다
- 요청이 섞이지 않았으면(난이도가 일정하거나 순차 의존 체인) 잘 맞춘 모델 하나가 대개 낫다. 자문가는 계획할 것이 없는 단발 Q&A 에 맞지 않는다
- 조합을 구성하기 전 기준선은 더 강한 모델 하나를
loweffort 로 돌린 비용이다. 조합은 단일 모델의 effort 곡선 전체를 이겨야 한다 - effort 값 (2026-09-28 조회) : 요청의
output_config.effort에low·medium·high·xhigh·max를 넣는다. 기본값은 대부분high다. Opus 5.5 는medium이고, Haiku 4.5 는 지원하지 않는다. effort 는 모든 출력 토큰(텍스트·도구 호출·thinking)에 걸린다 - 시험 뒤 변경 Opus 5.5 기본
medium2026-09-22 ·xhigh는 2026-04-16 Opus 4.7 부터 - 캐시를 쓰는 대화 중간에 요청 단위(top-level) effort 를 바꾸면 캐시가 깨진다. 그래서 워크로드 단위로 바꾸거나 메시지별 effort(베타)를 쓴다. 속도용 effort 는 ■ 지연 줄이기 lever 에 있다
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
| 모델을 바꿀까 고민 중이다 | 같은 모델에서 effort 부터 본다 | choosing-a-model en-2026-09-28 "Tuning effort is often a better lever than switching models." |
| 비용이 높고 품질은 충분하다 | 지금 모델에서 effort 를 한 단계씩 낮춰 가며 시험한다(sweep) | optimizing-cost-intelligence "Sweep effort down on your current model" |
| 품질이 모자란다 | 낮췄던 effort 를 되돌린다. 낮춘 적이 없으면 한 단계 위 모델을 low effort 로 돌린다 | optimizing "If you lowered effort, restore it; otherwise try the next tier up at low effort" |
Opus 5.5 가 xhigh·max 에서도 까다로운 추론(reasoning)과 장기 에이전트 작업에 모자란다 | Fable 5.1 로 올린다 | choosing-a-model |
| 결과를 검사할 수 있다 (테스트·검증기) | 전부 low 로 돌리고, 실패한 것만 high 로 다시 돌린다 | optimizing |
| 요청 난이도가 섞였고 범주가 뚜렷하다. 분류도 정확하다 | routing 을 쓴다 (쉬운 질문은 작은 모델, 어려운 질문은 강한 모델) | building-effective-agents |
| 순차 작업인데 군데군데 어렵다 (코딩 에이전트 · 컴퓨터 사용 · 다단계 연구) | 자문가를 쓴다 | optimizing |
| 독립 조각이 많다. 특히 컨텍스트 창 하나를 넘는다 | orchestrator-workers 를 쓴다 | optimizing |
| 난이도가 일정하다. 또는 순차 의존 체인이나 단발 Q&A 다 | 잘 맞춘 모델 하나를 쓴다 | optimizing |
| 조합을 구성하기 전이다 | 더 강한 모델 하나를 low effort 로 돌린 비용이 이겨야 할 기준이다 | optimizing |
상황 변수
| 변수 | 값 | 답 쪽 | 근거 |
|---|---|---|---|
| 모델 | Haiku 4.5 | effort 를 지원하지 않아 이 lever 가 없다. thinking 양은 ■ 모델별 thinking 제어 에 있다 | models overview en-2026-09-28-full |
| 모델 | Opus 5.5 | 기본은 medium 이다. thinking 을 끌 수 없어 effort 가 주 제어다 | effort en-2026-09-28 |
| 모델 이전 | Opus 5 에서 Opus 5.5 로 옮기며 effort 를 생략한다 | 한 단계 낮게(high 대신 medium) 실행된다. effort sweep 을 다시 한다 | effort |
| 워크로드 | 연구·지식 작업 | effort 를 낮춰도 손해가 작다 | optimizing |
| 워크로드 | 긴 코딩 | effort 를 올리면 정확도가 실제로 오른다 | optimizing |
| 지연 | 실패 재실행을 쓰면 실패 건은 두 번 도는 시간이 걸린다 | 지연에 민감하면 불리하다 | optimizing |
| 자문가의 실행자 effort | low | 자문 비율이 무너질 수 있다. 자문 비율을 재 보고, 무너졌으면 실행자 effort 를 되돌린다 | optimizing |
| 자문 비율 | 대부분의 과제에서 자문한다 | 자문가 모델을 단독으로 돌리는 것이 더 싸다 | optimizing |
| 긴 캐시 대화 | 요청 단위(top-level) effort 를 중간에 바꾼다 | 캐시가 깨진다. effort 를 고정하거나 메시지별 effort(베타 · Fable 5.1·Mythos 5.1·Opus 5.5·Opus 5)를 쓴다 | effort |
연습 문제
고객지원 챗봇 문의는 대부분 "비밀번호 재설정" 같은 쉬운 질문이고, 일부만 약관 해석 같은 어려운 질문난이도 섞임이다. 분류기는 둘을 정확히 가른다분류 정확. 팀은 "싼 실행자에 최상위 모델을 자문가로 붙이자"고 한다. 어떤 구성이 맞을까?
시험 대비
함정
- "Opus 에서 Sonnet 으로 통째로 내린다" 는 함정이다. effort 낮추기를 건너뛴 것이다. 먼저 지금 모델에서 effort sweep 을 한다
- "모자라니 바로 Fable 로 올린다" 는 함정이다. 한 단계 위 모델을
loweffort 로 돌린다. Opus 5.5 는xhigh·max가 먼저다 - "조합(자문가·orchestrator)이 모델 하나보다 항상 싸다" 는 함정이다. 같은 모델을 낮은 effort 로 돌린 것이 더 쌌던 경우가 많다
- "사내 Q&A 에 자문가를 붙인다" 는 함정이다. 계획할 것이 없는 단발 Q&A 에는 맞지 않는다. 쉬운 질문과 어려운 질문이 뚜렷이 갈리면 routing 을 쓴다
- 자문가를 붙이고 실행자 effort 를 낮추는 것은 함정이다. 실행자가 막힌 것을 못 알아채 자문이 끊기고, 실행자 혼자보다 점수가 낮아질 수 있다
- Opus 5 설정을 그대로 Opus 5.5 로 옮기는 것은 함정이다. effort 를 생략하면 기본
medium이라 한 단계 낮게 실행된다. 옛 설정을 옮기지 말고 effort sweep 을 다시 한다 - Haiku 4.5 문항에서 "effort 를 낮춘다" 를 고르는 것은 함정이다. 이 모델은 effort 를 지원하지 않는다
- "어려운 일이니 무조건 high" 는 함정이다. 어려워도 effort 가 점수를 못 올리는 워크로드가 있다. 곡선을 재 봐야 알 수 있다
adaptive를 effort 값으로 쓰는 것은 함정이다.adaptive는 thinking 모드이지 effort 단계가 아니다
신호
"Tuning effort is often a better lever than switching models."
"Multi-model strategies pair a lower-cost model with a frontier model so that most tokens are billed at the lower rate."
"If you lowered effort, restore it; otherwise try the next tier up at low effort"
"Sweep effort on your current model first."
"a single well-tuned model is usually the better choice"
"It fits poorly when every turn genuinely needs frontier capability, when there is nothing to plan (single-turn Q&A)"
"Hard work does not automatically need high effort."
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
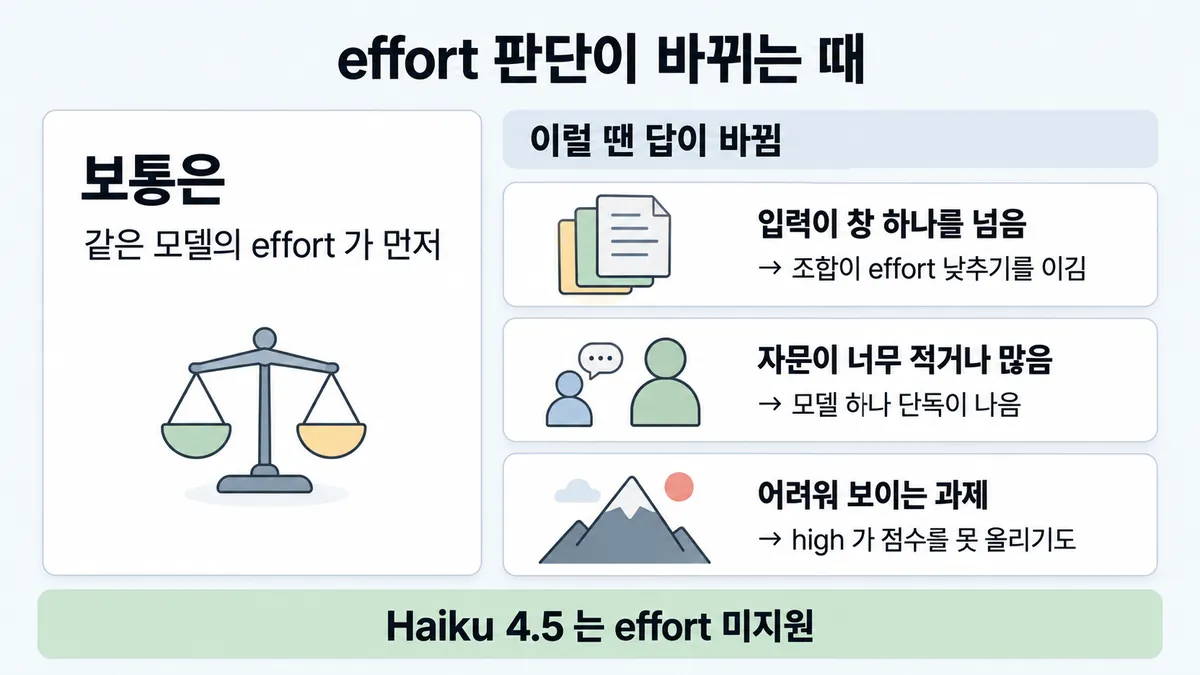
1. 조합이 effort 낮추기를 이기는 때 — 컨텍스트 창 하나를 넘는 입력
- 조건 : 입력이 어떤 컨텍스트 창에도 들어가지 않는다.
- 판단 : 이때 청구액은 입력을 "읽는 비용" 자체다. 그래서 effort 를 낮춰도 줄지 않는다. 공식 측정(2,160만 토큰 코드 묶음)은 아래와 같다.
- Fable 5.1 단독은 effort 셋 모두 에피소드당 $468~$552 였다.
- orchestrator(Fable 5.1) + worker(Sonnet 5) 25개 구성은 약 절반 비용에 10~12점 낮았다.
- 걸린 시간은 약 2.3시간 vs 15~20시간이었다.
- 등급 : (Anthropic 내부 측정)
- 근거 : optimizing
2. 자문가가 손해인 때 — 자문 비율
- 조건 : 자문가를 붙였는데 실행자가 너무 적게, 또는 너무 많이 묻는다.
- 너무 적게 : Opus 5.5
low실행자 + Fable 5.1 자문가가 300개 중 1개만 물었다. 그 결과 Opus 5.5 단독보다 7점 낮았다 (확인). - 너무 많이 : 식은 조합 과제당 비용 = 실행자 비용 + 자문 비율 × 자문 횟수 × 자문 1회 비용 이다. 예로 실행자 $0.30 · 자문 1회 $0.20 · 물을 때 3회 · 강한 모델 단독
low= $0.66 이라 하자. 손익 자문 비율 = (0.66 − 0.30) ÷ (3 × 0.20) = 60% 다. 60% 넘게 물으면 강한 모델 단독이 싸다. - 전제 : 자문을 받아 실행자가 아끼는 토큰은 뺐다(공식은 일부 상쇄된다고 한다). 숫자는 가정이다.
- 등급 : 계산 (현상은 확인)
- 근거 : optimizing
3. 실패 재실행이 안 맞는 때
- 조건 : 결과를 기계적으로 검사할 수 없다. 또는 검사기가 나쁜 결과를 통과시킨다.
- 식 : 과제당 비용 =
low1회 비용 + 실패율 ×high1회 비용 이다. 예로low$0.08 ·high$0.25 · 실패율 25% 면 0.08 + 0.0625 ≈ $0.14 다 (전부high$0.25 대비 약 43% 절감). 손익 실패율 = (0.25 − 0.08) ÷ 0.25 = 68% 다. - 판단 : 실패 신호가 없으면 성립하지 않는다. 실패 건은 두 번 도는 시간이 걸린다. 그래서 지연 목표가 빡빡하면 불리하다.
- 등급 : 계산 (조건 두 개는 확인)
- 근거 : optimizing
4. 어려운 일이니 high? — 안 오르는 워크로드
- 조건 : 과제가 어려워 보여 effort 를 올렸다.
- 판단 : 공식 측정에서 Fable 5.1 은 긴 연구 과제에서
low·medium·high점수가 거의 같았다. 과제당 비용만 $4.66 에서 $7.12 로 늘었다. 어려운 일이 곧 높은 effort 는 아니다. 곡선을 재 봐야 알 수 있다. - 근거 : optimizing
5. 대화 중간에 effort 를 바꿔 아끼려는 때
- 조건 : 긴 캐시 대화 도중 요청 단위 effort 를 낮춘다.
- 판단 : 요청 단위 effort 를 바꾸면 그 지점부터 캐시가 깨진다. 10만 토큰 앞부분 기준으로 한 번 깨질 때 값은 아래와 같다. 지원 모델이면 메시지별 effort(베타)가 캐시를 지킨다.
- Opus 5.5 : $0.50 vs 읽기 $0.02 (25배)
- Fable 5.1 : $1.25 vs $0.03 (50배)
- 근거 : optimizing · effort
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 근거 |
|---|---|---|---|
| "Opus 에서 Sonnet 으로 통째로 내린다" | 단가가 절반이라 바로 싸진다 | effort sweep 을 건너뛴다. 어려운 몇 % 의 품질을 통째로 잃을 수 있다 | choosing-a-model · optimizing |
| "모자라니 바로 Fable 5.1 로 올린다" | 최상위면 해결될 것 같다 | 한 단계 위를 low effort 로 돌린다. Opus 5.5 는 xhigh·max 가 먼저다 | optimizing · choosing-a-model |
| "사내 Q&A 에 자문가·orchestrator 를 붙인다" | 조합이 "대부분의 토큰을 싼 단가로"라는 말과 맞아 보인다 | 자문가는 계획할 것이 없는 단발 Q&A 에 맞지 않는다. orchestrator 는 넘길 대량 작업이 있어야 한다. 쉬운 질문과 어려운 질문이 뚜렷이 갈리면 routing 을 쓴다 | optimizing · building-effective-agents |
| "조합이 모델 하나보다 항상 쌈" | 대부분의 토큰이 싼 단가라서 | 창 안에 들어가는 일에서는 같은 모델을 낮은 effort 로 돌린 것이 매번 더 쌌다 | optimizing |
| "effort 를 낮추면 답이 짧아진다" | 적게 쓰라는 설정 같다 | effort 가 정하는 것은 thinking 양 쪽이다. 답 길이는 프롬프트로 정한다. 자세한 것은 ■ 지연 줄이기 lever 에 있다 | effort en-2026-09-28 (Opus 5) |
"Haiku 4.5 의 effort 를 low 로" | 모든 모델에 있을 것 같다 | Haiku 4.5 는 effort 를 지원하지 않는다 | overview full |
"Opus 5.5 에 budget_ 로 thinking 상한" | 옛 방식이다 | Opus 5.5 는 thinking 을 enabled·disabled 로 보내면 400 이 난다. effort 로 정한다. 자세한 것은 ■ 모델별 thinking 제어 에 있다 | 릴리스 노트 |
"max 가 언제나 가장 정확" | 최대니까 | 대부분 워크로드에서 max 는 작은 품질 이득에 큰 비용이 든다. 구조화 출력 같은 일에는 thinking 이 과하다 (Opus 4.7 안내) | effort |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 2.1 공식 시험 가이드 v1.0
- choosing-a-model
- effort
- models overview
- optimizing-cost-intelligence
- building-effective-agents
- 릴리스 노트
상태
- 업계 일반 1줄(Haiku 4.5 에서 다른 lever)
- 시험 뒤 변경 1곳(Opus 5.5 기본 medium)
미해결
- 목록 2.1② 의 정답 규칙은 섞인 요청의 예로 "자문가 위임·orchestrator-workers" 를 들었다. 문제 상황은 "사내 Q&A" 였다. 공식은 자문가가 단발 Q&A 에 맞지 않고 orchestrator 는 대량 조각이 있어야 한다고 쓴다. 그래서 카드는 routing 과 모델 하나로 고쳤다.
- 가이드(2026-07) 시점에는 Opus 5.5 가 없었다. 그래서 "기본 effort =
medium" 은 시험 뒤 변경(2026-09-22)이다. 시험이 기본값을 물으면 "대부분high" 가 안전하다 (추론). - routing 공식 예문의 모델명은 Haiku 4.5 ↔ Sonnet 4.5 다 (옛 이름, building-effective-agents). 현행 이름으로 된 routing 예문은 못 찾았다.
- 공식 문장은 "often"(자주)이다. effort 가 늘 먼저라는 뜻은 아니다. 아래 경우에는 모델 교체가 맞는 답일 수 있다. 어느 신호에서 시험이 교체를 정답으로 삼는지는 공식 샘플에 없다.
- Haiku 4.5 처럼 effort 가 없는 경우
- 입력이 창을 넘는 경우
- 곡선이 이미 한계인 경우
- 측정 수치는 모두 Anthropic 내부 벤치마크이고 방향성이다 (optimizing).
- 목록 영어 신호 2개("Tuning effort…" · "Multi-model strategies…")는 원문에서 모두 찾았다. 못 찾은 인용은 없다.