◆ 100% 약속 vs 측정된 SLO + 사람 안전망
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 6.3 피드백과 기대 맞추기 · D6 사람·문서 14%Manage stakeholder feedback loops and expectation alignment (including SLAs)
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 6.3① "AI 답변이 항상 정확하다고 계약서에 넣어 달라" — 무엇을 약속하나? — 기대치 맞추기 (100% 대신 측정된 SLO + 사람 안전망)
한눈에
ELI5
날씨 예보관이 "내일 절대 비 안 와요"라고 약속하지 않는 것과 같아요.
- 예보관은 "비 올 확률 20%"처럼 재 본 숫자를 말해요.
- 그래도 틀릴 수 있으니 우산을 챙기라고 알려 줘요.
- AI 도 가끔 틀려요. 그래서 "항상 맞아요" 대신 "이만큼 맞았어요"를 약속해요.
- 중요한 답은 사람이 한 번 더 봐요. 그게 우산이에요.
개념 설명
원리
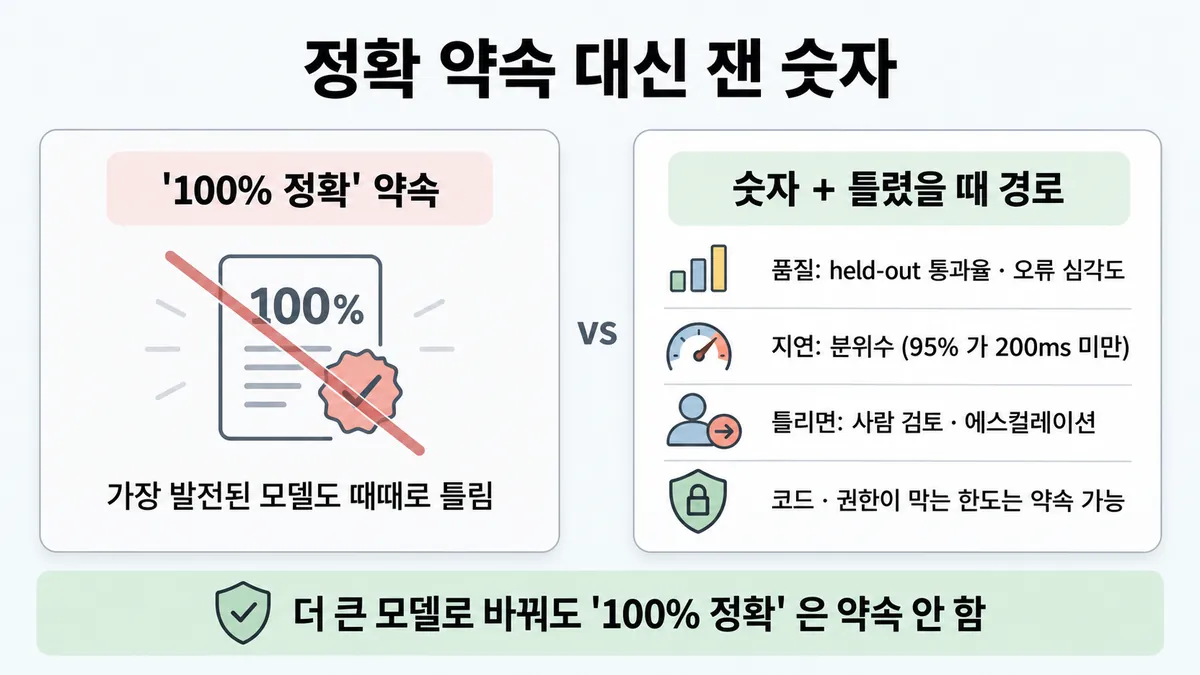
왜 100% 를 약속 못 하나
- 가장 발전된 모델도 때때로 사실과 다른 답을 낸다 (공식). 모델을 키워도 이 문장은 바뀌지 않는다.
- 에이전트는 실행마다 결과가 다르다 (공식). 같은 질문도 매번 같게 나오지 않는다.
- 그래서 "정확하다" 는 약속할 수 없다. 약속할 수 있는 것은 잰 값(통과율·분위수)과 틀렸을 때의 경로다.
무엇을 약속하나
- 품질 : held-out 평가셋 통과율과 오류 심각도를 약속한다. 한 차원이 아니라 여러 차원으로 잰다.
- 지연 : 평균이 아니라 분위수로 약속한다 ("응답 95% 가 200ms 미만").
- 가용성 : 내가 올라탄 윗단(API)이 무엇을 약속하는지부터 본다. Standard 티어는 best-effort 다. Priority Tier 는 99.5% 가동이 목표다.
- 틀렸을 때 : 아래 경로를 약속한다.
- 위험 등급별 사람 검토
- 에스컬레이션
- "모르겠다" 허용
숫자를 거는 순서 (업계 일반 — SRE 습관)
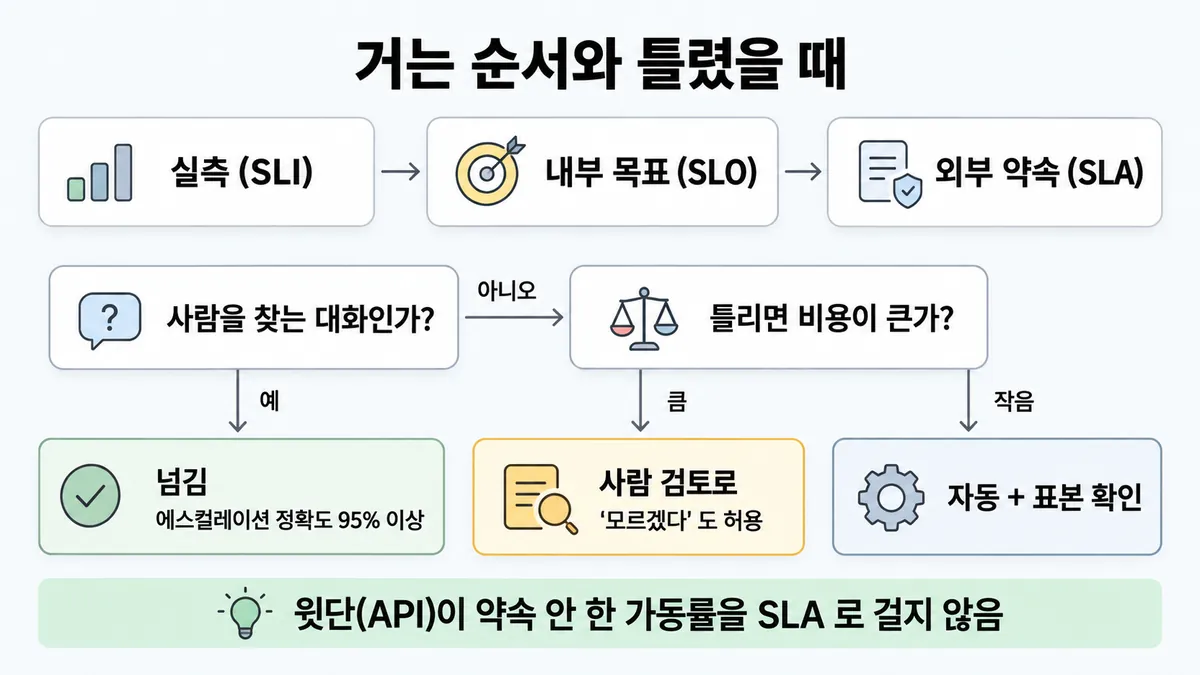
- 순서는 SLI(실제로 잰 값), SLO(내부 목표), SLA(어기면 결과가 따르는 외부 약속)다.
- 재기 전에 숫자를 흔드는 요인을 확인한다.
- effort 기본값 : 모델마다 다르다.
- rate limit(속도 제한) : 보장이 아니라 최대치다. 짧은 폭주에도 429 가 난다.
- 인프라
핵심 질문 두 개
- 이 숫자를 실제로 재 봤나, 그리고 흔드는 요인을 확인했나?
- 틀렸을 때 누가, 어떤 경로로 잡나?
규칙과 판단
갈림길
무엇을 약속 [6.3①]
약속하지 않는다
가장 발전된 모델도 때때로 사실과 다른 답을 낸다. 에이전트는 실행마다 결과가 다르다
약속할 수 있다
모델 행동이 아니라 결정적(deterministic) 장치가 보장한다 (코드·권한 검사로 넓힌 것은 해석이다). CLAUDE.md 지시는 권고다. hook 은 결정적이고 반드시 실행된다
평가셋 통과율로 건다
held-out 평가셋 통과율과 오류 심각도로 건다
분위수로 건다
예 : "응답 95% 가 200ms 미만"
윗단(API)보다 센 약속은 하지 않는다
윗단이 약속하지 않은 가동률을 내 SLA 로 걸지 않는다 업계 일반. Standard 티어는 best-effort 가용성이다
99.5% 는 윗단(API) 목표다
이 가동률을 약속으로 걸려면 대비책(재시도·대체 경로)부터 만든다 업계 일반. Priority Tier 는 99.5% 가동을 목표로 한다. 약정을 넘는 요청은 Standard 로 간다. Opus 5.5 · Sonnet 5 · Fable 5.1 등은 Priority Tier 를 지원하지 않는다
걸기 전에 [6.3①]
먼저 잰다
실측(SLI), 내부 목표(SLO), 외부 약속(SLA) 순서로 간다 업계 일반
변동을 확인한다
effort 를 명시한다. rate limit(속도 제한)은 보장된 최소가 아니라 허용 최대치다. 짧은 폭주에도 429 가 난다
약속으로 건다
잰 값보다 여유를 두고 건다 업계 일반
틀렸을 때 [6.3①] [5.3]
넘긴다
사람에게 넘길 대화를 붙잡지 않게 한다. 에스컬레이션 놓침을 따로 센다. 에스컬레이션 정확도 95% 이상을 목표로 한다
사람 검토로 보낸다
위험 등급을 나눠 사람 검토 대상으로 표시한다. "모르겠다" 를 허용한다. 불확실하다고 말해도 된다고 분명히 허용하면 거짓 정보를 크게 줄일 수 있다. 자세한 것은 ■ moderation 위험 등급 에 있다
자동 + 표본 확인
자동으로 처리하고 표본을 확인한다 업계 일반
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : Claude → 라우팅 → 사람 검토 → 고객
규칙 (라우팅) : 틀리면 비용이 큰 결과는 사람 검토
질문 : 이 답은 바로 고객에게 가도 될까?
① 위험 등급으로 나눈다 ✓
- 시작 : Claude — 쪽지 : A 배송 조회 링크 / B 환불 58,000원
- 답 : Claude → 라우팅 : 위험 등급을 나눈다 — 쪽지 : A = 낮음 / B = 높음 / (돈이 나감)
- 통과 : 라우팅 → 고객 : 틀려도 비용이 작은 결과다 — 말 : “배송 조회는 이 링크에서 돼요.”
- 검토 : 라우팅 → 사람 검토 : 틀리면 비용이 큰 결과다 — 쪽지 : B 환불 58,000원 / 상담원 확인 대기
- 끝 : 약속하는 것은 잰 숫자와 틀렸을 때의 경로다
② "100% 정확" 약속 ≠
- 시작 : Claude — 쪽지 : 계약서: / "100% 정확" / → 검토 단계 없음
- 시작 : Claude — 쪽지 : B 환불 58,000원
- 건너뜀 : 라우팅
- 건너뜀 : 사람 검토
- 답 : Claude → 고객 : 사람 검토 없이 간다 — 말 : “58,000원 환불됐어요.”
- 틀림 : 고객 : 가장 발전된 모델도 때때로 틀린다 ≠ — 쪽지 : 규정대로면 / 52,000원
- 끝 : "100% 정확"은 약속하지 않는다
③ 넘길 대화를 붙잡는다 ≠
- 시작 : Claude — 쪽지 : 대화: / "사람 바꿔 줘요" / (같은 말 3번째)
- 답 : Claude → 라우팅 : 사람에게 넘길 대화다 — 쪽지 : 분류: / 자동 응대 계속
- 건너뜀 : 사람 검토
- 붙잡음 : 라우팅 → 고객 : 에스컬레이션을 놓친다 ≠ — 말 : “제가 계속 도와드릴게요.”
- 끝 : 넘길 대화를 붙잡았다. 에스컬레이션 놓침은 따로 센다 (목표 : 에스컬레이션 정확도 95% 이상)
규칙 원문 갈림 기준 거는 순서 사람 안전망 (갈림길로 그린 규칙)
갈림 기준
약속하는 것은 잰 숫자와 틀렸을 때의 경로다. "정확하다"는 약속하지 않는다
- "100% 정확"은 약속하지 않는다. 가장 발전된 모델도 때때로 사실과 다른 답을 낸다. 에이전트는 실행마다 결과가 다르다. 더 큰 모델로 바꿔도 이 문장은 그대로다
- 대신 거는 것은 셋이다
- 품질 : held-out 평가셋 통과율과 오류 심각도다(공식 예 "오류의 90% 는 불편 수준")
- 지연(latency) : 분위수다(예 "응답 95% 가 200ms 미만")
- 틀렸을 때 : 사람 검토 · 에스컬레이션 경로다
- 기준 문장 쓰는 법은 ■ 성공 기준 에 있다
- "약속하지 않는다" 는 모델 행동에만 해당한다. 코드·권한이 강제하는 한도는 그 장치를 근거로 약속해도 된다. 권한 없는 자격증명이나 서비스 쪽 검사가 막는 금액·동작이 그런 한도다. CLAUDE.md 지시는 권고다. hook 은 결정적이고 반드시 실행된다 (코드·권한 검사로 넓힌 것은 해석이다)
- 프롬프트 지시로 막은 한도는 권고일 뿐이다. 그래서 약속 근거가 되지 못한다
- 목표는 현재 프런티어 모델 역량에 비춰 현실적으로(달성 가능하게) 잡는다. 대부분은 여러 차원으로 잰다
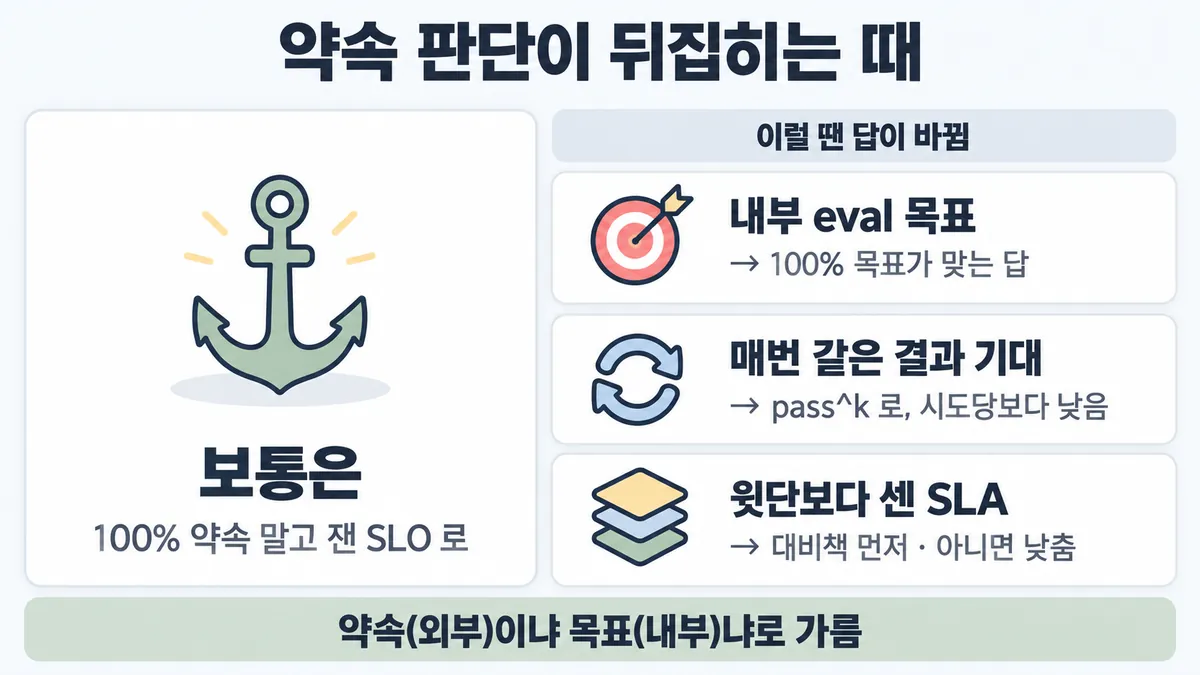
- "매번 맞아야" 하는 고객 대면이면 pass^k 로 잰다. 시도당 75% 면 3번 모두 성공은 ≈ 42% 다. 자세한 것은 ◆ pass@k vs pass^k 에 있다
- 내부 eval 목표 100% 는 다른 말이다. regression(회귀) eval 은 거의 100% 통과가 정상이다. 맥락에 준 회사·상품 정보 정확도는 100% 를 목표로 한다. 이것은 고객 약속이 아니라 평가 목표다
- SLA 를 아예 없애는 것도 답이 아니다. 가이드 목표 6.3 에 "(including SLAs)" 가 있다. 1.6 value pillars(핵심 가치 항목)에도 성능 SLA 가 있다. 자세한 것은 ■ value pillars 5개 에 있다
거는 순서
순서는 실측(SLI), 내부 목표(SLO), 외부 약속(SLA) 이다. SLA 는 어기면 보상 등 결과가 따르는 약속이다. 용어와 순서는 업계 일반이다. Anthropic 문서에는 SLA/SLO 정의가 없다
지연은 모델 크기 · 프롬프트 복잡성 · 기반 인프라에 따라 달라진다
그래서 재 보기 전의 숫자는 믿지 못한다
effort 를 명시한다. low effort 는 응답 시간과 비용을 크게 줄일 수 있다
effort 를 생략하면 모델 기본값이 쓰인다. Opus 5.5 는 medium, Opus 5 이전은 high 다. 그래서 모델만 바꿔도 지연·품질이 움직인다 시험 뒤 변경 Opus 5.5 출시 2026-09-22. 자세한 것은 ■ 지연 줄이기 lever 에 있다
rate limit 은 보장된 최소가 아니라 허용 최대치다. 넘으면 429 와 함께 어느 한도인지와 retry-after 가 온다. 짧은 폭주에도 429 가 난다. 자세한 것은 ■ rate limit 에 있다
가용성 : Standard 티어는 best-effort 가용성이다. Priority Tier 는 99.5% 가동을 목표로 한다. 약정(분당 입력·출력 토큰 · 1/3/6/12개월 · 특정 모델 버전)을 넘는 요청은 Standard 로 간다. Opus 5.5 · Sonnet 5 · Fable 5.1 등은 Priority Tier 를 지원하지 않는다 (2026-09-28 조회)
윗단(API)이 약속하지 않은 가동률을 내 SLA 로 걸지 않는다. 그 가동률을 약속으로 걸려면 대비책(재시도·대체 경로)부터 만든다 업계 일반
변동을 확인한 뒤에는 잰 값보다 여유를 두고 건다 업계 일반 에러 버짓 개념
사람 안전망
틀리면 비용이 큰 결과는 사람이 검토한다. 위험 등급을 나눈다. 고위험(high-risk)은 자동으로 차단한다. 중위험이 쌓이면 사람 검토 대상으로 표시한다
자세한 것은 ■ moderation 위험 등급 에 있다. 행동 앞 승인은 ■ human-in-the-loop 게이트 위치 에 있다
"모르겠다" 를 허용한다. 불확실을 인정할 권한을 명시적으로 주면 거짓 정보를 크게 줄일 수 있다. 주장마다 인용을 달게 해 감사할 수 있게 한다
사람에게 넘길 대화를 붙잡지 않게 한다(에스컬레이션 놓침을 따로 센다). 에스컬레이션 정확도 95% 이상을 목표로 한다
틀려도 비용이 작은 결과는 자동으로 처리하고 표본을 확인한다 업계 일반
기대는 계약 전에 eval 로 드러낸다. 초기 테스트에서 "되는" 기능이 말하지 않은 기대를 못 채워 몇 주를 날릴 수 있다
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 등급 | 근거 |
|---|---|---|---|
| 고객이 "항상 정확 · 100%" 를 계약에 넣자고 한다 | 약속하지 않는다. 잰 통과율과 사람 안전망(safety net)으로 바꾼다 | reduce-hallucinations "Even the most advanced language models, like Claude, can sometimes generate text that is factually incorrect" · demystifying-evals "agent behavior varies between runs" | |
| "더 큰 모델이면 확실" 이라고 한다 | 그렇지 않다 | reduce-hallucinations (most advanced 도 틀림) | |
| 품질 약속 문장을 쓴다 | held-out 평가셋 통과율과 오류 심각도로 쓴다. 여러 차원으로 잰다 | define-success en-full | |
| 지연(latency) 약속 문장을 쓴다 | 분위수로 쓴다 | define-success en-full "95% response time < 200ms" | |
| 목표치를 정한다 | 현재 프런티어 모델 역량에 비춰 현실적으로 정한다 | define-success | |
| 가용성을 약속한다. Standard 티어다 | 윗단은 best-effort 다. 대비책이 없으면 내 SLA 를 그보다 세게 걸지 않는다 | (티어 성격) · 업계 일반(판단) | service-tiers "best-effort availability" |
| 가용성을 약속한다. Priority Tier 약정이다 | 윗단 목표는 99.5% 가동이다. 약정을 넘는 요청은 Standard 로 간다 | service-tiers | |
| 처리량을 약속한다 | rate limit 은 최대치일 뿐이다. 초 단위 폭주에도 429 가 난다 | rate-limits | |
| 지연 숫자를 걸기 전이다 | effort 를 명시하고 잰다 (기본값이 모델마다 다르다) | effort (Opus 5.5 기본 medium — 시험 뒤 변경) | |
| 틀리면 비용이 큰 결과다 | 위험 등급별로 사람이 검토한다 | content-moderation | |
| 모델이 확신하지 못한다 | "모르겠다" 를 허용하고 사람에게 넘긴다 | reduce-hallucinations | |
| 사람에게 넘길 대화다 | 에스컬레이션 정확도 95% 이상을 목표로 한다 | customer-support-chat-full | |
| SLI, SLO, SLA 의 순서를 묻는다 | 먼저 재고, 내부 목표를 정한 뒤, 외부 약속을 건다 | 업계 일반 | Anthropic 문서에 SLA/SLO 정의가 없다 (미해결 1) |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 약속 대상 | 정확성 자체다 ("틀리지 않음") | 약속하지 않는다 | 판단 규칙 1 | |
| 약속 대상 | 잰 통과율과 분위수 지연이다 | 여유를 두고 약속할 수 있다 | (형식) · 업계 일반(여유) | define-success en-full |
| 약속 대상 | 내부 eval 목표다 | 100% 도 된다 (약속이 아니다) | 뒤집히는 때 1 | |
| 고객 대면 · 매번 맞아야 | pass^k 로 잰다 | 시도당 비율보다 훨씬 낮게 나온다 | 계산 | 뒤집히는 때 2 |
| 가용성 목표 | 99.5% 를 넘는다 | 윗단 목표보다 세다. 대비책이 없으면 지키지 못한다 | 계산 | 뒤집히는 때 3 |
| 트래픽 모양 | 짧은 폭주다 | 분당 한도 안이어도 429 가 난다 | rate-limits · 뒤집히는 때 4 | |
| 모델 교체 | Opus 5 에서 Opus 5.5 로 바꾸고 effort 를 생략한다 | 한 단계 낮은 effort 로 돈다. 그래서 지연·품질이 달라진다. 다시 잰다 | 시험 뒤 변경 | effort · 뒤집히는 때 5 |
| 오류 비용 | 돈 · 법 · 안전 | 사람이 검토한다 | content-moderation | |
| 오류 비용 | 작다 | 자동으로 처리하고 표본을 확인한다 | 업계 일반 | — |
연습 문제
고객지원 Agent 가 환불 금액을 확정해 안내한다. 금액이 틀리면 고객에게 돈이 잘못 나간다비용이 큼. 영업은 "더 큰 모델로 바꾸고 계약서에 '100% 정확' 을 넣자"100% 약속고 한다. 틀린 답은 어떻게 다룰까?
시험 대비
함정
- "더 큰 모델로 바꾸면 100% 가 된다" 는 함정이다. 가장 발전된 모델도 때때로 틀린다
- 사람 검토 없이 "100% 정확" 을 약속하는 것은 함정이다. 틀린 답이 그대로 고객에게 간다 업계 일반. 틀리면 비용이 큰 결과는 사람이 검토한다
- "'빠르고 정확함'을 마케팅 문구로 약속" 은 함정이다. 숫자가 없는 말이다. 기준은 구체적이고 측정 가능해야 한다 (■ 성공 기준)
- "약속이 위험하니 SLA 자체를 없앤다" 는 함정이다. 잰 숫자로 거는 것이 답이다 업계 일반. 가이드 목표가 SLA 를 관리 대상으로 둔다
- "regression eval 이 거의 100% 통과하니 서비스 정확도 100% 약속" 은 함정이다. regression eval 은 예전에 되던 과제를 아직 하는지 본다. 고객 약속과 다른 말이다
- 반대쪽 함정도 있다. "모델은 보장 못 하니 어떤 것도 약속 안 함 · 정확도 숫자만 제시" 는 함정이다. 코드·권한이 막는 한도는 그 장치를 근거로 약속할 수 있다 (적용은 해석이다)
- "프롬프트를 다듬었으니 정책대로 동작한다고 약속" 은 함정이다. 프롬프트 지시는 권고다
- "평균 지연 2초 약속" 은 함정이다. 지연은 분위수로 건다
- "rate limit 만큼 처리량 보장" 은 함정이다. rate limit 은 허용 최대치일 뿐이다
- "Standard 티어 위에 99.9% 가동 SLA" 는 함정이다. best-effort 위에 윗단보다 센 약속을 건 것이다 업계 일반 계산 = 설명 쪽
신호
"Even the most advanced language models, like Claude, can sometimes generate text that is factually incorrect or inconsistent with the given context."
"Regardless of agent type, agent behavior varies between runs"
"Your success metrics should not be unrealistic to current frontier model capabilities."
"If you exceed any of the rate limits you will get a 429 error describing which rate limit was exceeded"
"All limits described here represent maximum allowed usage, not guaranteed minimums."
"When latency matters or tasks are straightforward, low effort can significantly reduce response times and costs."
"The API prioritizes these requests alongside all other requests with best-effort availability."
"Priority Tier targets 99.5% uptime with prioritized computational resources."
"Explicitly give Claude permission to admit uncertainty."
"Unlike CLAUDE.md instructions which are advisory, hooks are deterministic and guarantee the action happens."
"Creating multiple risk levels allows you to adjust the aggressiveness of your moderation."
"Manage stakeholder feedback loops and expectation alignment (including SLAs)" (가이드 목표 6.3)
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
1. "100%" 가 맞는 답일 때 — 내부 eval 목표
- 조건 : 지문이 계약 약속이 아니라 내부 평가 목표를 묻는다.
- 판단 : 공식 고객지원 가이드는 맥락에 준 회사·상품 정보 정확도와 견적 정확도에 "100% 목표"를 둔다. regression(회귀) eval 도 거의 100% 통과가 정상이다.
- 근거 : customer-support-chat-full "Target 100% accuracy" · demystifying-evals "should have a nearly 100% pass rate"
- 주의 : "100% 가 나오면 항상 오답" 으로 외우면 여기서 틀린다. 가르는 질문은 이것이다. 약속(외부)인가, 목표(내부)인가?
2. 시도당 정확도가 높아도 "매번" 은 훨씬 낮을 때
- 조건 : 고객 대면 에이전트가 같은 유형 요청을 반복 처리한다. 지문이 "사용자는 매번 같은 결과를 기대"라고 한다.
- 계산 : pass^k = (시도당 성공률)^k 이다. 시도당 92% 이고 k = 5 이면 0.92^5 ≈ 0.659 다. 약 66% 다.
- 전제 : 시도끼리 독립이라고 본다 (공식 예 0.75³ ≈ 42% 와 같은 식).
- 등급 : 계산 (식은 확인)
- 근거 : demystifying-evals
- 뜻 : "정확도 92%" 를 "거의 항상 맞음" 으로 약속하면 사용자 체감과 어긋난다. 그래서 약속 문장에 무엇을 셌는지(시도당 vs k번 모두)를 적는다.
3. 윗단보다 센 가용성 약속
- 조건 : Priority Tier 약정 위에서 고객에게 99.9% 가동 SLA 를 걸려 한다.
- 계산 : 30일은 43,200분이다. 99.5% 면 허용 중단은 216분(3.6시간)이다. 99.9% 면 43.2분이다. 내 약속이 윗단 목표보다 5배 빡빡하다.
- 전제 : 윗단 중단이 곧 내 중단이다(대체 경로가 없다). Standard 티어는 목표 숫자조차 없다(best-effort).
- 등급 : 계산 (99.5% · best-effort 는 확인)
- 근거 : service-tiers
- 처방 : 대비책(재시도 · 대체 모델·경로)을 먼저 설계하거나 약속을 낮춘다 (업계 일반).
4. 분당 한도 안인데 429
- 조건 : 한도는 분당 300 RPM 이다. 평균은 분당 200건이다. 그런데 매시 정각에 1초에 12건이 몰린다.
- 계산 : 공식 예는 "60 RPM 이 초당 1건으로 적용될 수 있음" 이다. 같은 비율이면 300 RPM ≈ 초당 5건이다. 그러면 12건 폭주는 한도를 넘는다.
- 등급 : 계산 (비율 적용은 추론이다. 공식은 60 대 1 예만 든다)
- 근거 : rate-limits
- 뜻 : 처리량 약속은 평균이 아니라 폭주 모양까지 재고 나서 건다.
5. 모델만 바꿨는데 지연 SLO 가 흔들림
- 조건 : Opus 5 에서 effort 를 안 적고 쓰다가 Opus 5.5 로 바꿨다.
- 판단 : Opus 5.5 기본값은 medium 이다 (Opus 5 이전은 high). 그래서 effort 를 생략한 요청은 한 단계 낮게 실행된다. 지연·비용·품질이 함께 움직인다. 이전 설정을 가져오지 말고 effort 를 다시 훑어 본다(스윕).
- 등급 : 시험 뒤 변경 2026-09-22 출시. 시험은 "effort 를 명시해 예상치 못한 지연 피하기" 로 물을 수 있다. 이것은 Sonnet 4.6 문장이다
- 근거 : effort · 릴리스 노트
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "더 큰 모델로 바꾸면 100% 정확을 약속할 수 있다" | 큰 모델이 더 정확할 것 같다 | 가장 발전된 모델도 때때로 틀린다 | reduce-hallucinations | |
| "'빠르고 정확함' 을 마케팅 문구로 약속" | 부드럽고 무난해 보인다 | 숫자·데이터가 없는 말이다. 그래서 측정하지 못한다. 분쟁 때 기준이 없다 | (구체적·측정 가능 원칙) · 업계 일반(분쟁) | define-success |
| "약속이 위험하니 SLA 자체를 없앤다" | 위험을 피할 수 있어 보인다 | 가이드 목표 6.3 은 SLA 를 관리 대상으로 둔다. 잰 숫자로 걸면 된다 | (목표 문구) · 업계 일반(판단) | 가이드 목표 6.3 "(including SLAs)" |
| "regression eval 이 거의 100% 라 서비스 정확도 100% 약속" | 숫자가 100% 에 가깝다 | regression eval 은 예전에 되던 과제를 아직 하는지 본다. 실사용 전체의 정확도가 아니다 | demystifying-evals | |
| "평균 응답 2초를 SLA 로" | 평균이 익숙하다 | 공식 예는 분위수다 | define-success en-full | |
| "rate limit 만큼은 처리량이 보장된다" | 한도가 할당량처럼 보인다 | 보장된 최소가 아니라 허용 최대치다 | rate-limits | |
| "모든 답을 사람이 검토하면 100% 약속 가능" | 사람이 보면 안전할 것 같다 | 사람도 틀린다. 비용과 지연도 커진다. 그래서 위험 등급별로 나눈다 | 업계 일반(사람 오류) · 확인(등급 나누기) | content-moderation |
| "P95 2초 for 99% of requests" 같은 문장 | 숫자가 많아 정밀해 보인다 | 분위수(95%)와 비율(99%)이 섞였다. 분위수 하나에 목표 하나를 둔다 | 업계 일반 | 목록 6.3① 영상 표현 |
참고
함께 보기
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 6.3 공식 시험 가이드 v1.0
- 가이드 목표 1.6 공식 시험 가이드 v1.0
- reduce-hallucinations
- rate-limits
- effort
- reduce-latency
- service-tiers (2026-09-28 새로 받음)
- define-success
- content-moderation
- customer-support-chat-full
- demystifying-evals
- 릴리스 노트
- Claude Code best-practices
상태
- 업계 일반 6줄(SLI→SLO→SLA 순서·용어 · 윗단보다 센 약속 금지 · 여유 두기 · 작은 비용 = 자동+표본 · SLA 없애기 반박)
- 시험 뒤 변경 1곳(Opus 5.5 effort 기본값)
미해결
- SLA · SLO · SLI 의 정의와 순서를 말하는 Anthropic 공식 문장은 없다.
grep -rn -w "SLA\|SLAs\|SLO\|SLOs\|SLI" ccarp/raw/official-docs/로 찾았다. 결과는 advanced-tool-use 1건이고 무관한 예시다 (제외 = 받지 않은 문서). 그래서 카드에서는 업계 일반으로 둔다. - 목록 6.3① 에 "저신뢰 결과를 사람에게 보내는 라우팅" 이 있다. 공식 문서에서 "confidence" 로 라우팅하는 문장은 못 찾았다(en 문서
low confidence\|confidence scoregrep 0건). 공식에 있는 것은 위험 등급별 사람 검토, 에스컬레이션 정확도, "모르겠다" 허용이다. 그래서 카드는 그 셋으로 고쳐 썼다. - 목록의 "지연 변동(effort·thinking)" 중 thinking 이 지연을 흔든다는 직접 문장은 reduce-latency · thinking-troubleshooting 에서 못 찾았다. effort 문장만 확인했다.
- Priority Tier 99.5% 는 "목표(targets)" 다. 계약상 보상 조건 같은 SLA 세부는 받은 문서에 없다.
- 목록 영어 신호 3개는 모두 원문에서 찾았다 (reduce-hallucinations · rate-limits · effort).