◆ capability eval vs regression eval
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 4.3 A/B 테스트와 반복 개선 · D4 평가 16%Conduct A/B testing and iterative improvements
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 4.3② 회귀 suite 가 100% 통과 — 더 어렵게 바꿀까? — 능력(capability) eval 과 회귀(regression) eval 을 다르게 운영
- 4.2② eval 셋, 수백 개가 모일 때까지 기다릴까? — 첫 평가 데이터셋 만들기 (크기·출처·균형·과제 품질)
- 4.3③ 프롬프트 한 줄·모델 버전을 바꿨다 — 무엇을 다시 돌리나? — 반복 개선 루프 (변경 = 시스템 변경, eval 통과 뒤 배포)
한눈에
ELI5
키 재기 벽과 체온계를 떠올려 보세요.
- 키 재기 벽은 아직 못 닿은 높은 곳에 눈금이 있어야 쓸모가 있어요.
- 체온계는 늘 "정상"이 나오는 게 좋은 거예요. 갑자기 높으면 어디가 아픈 거죠.
- 벽 꼭대기까지 다 자라면, 그 벽은 체온계처럼 "여전히 괜찮나" 보는 데 써요.
- 이 쪽은 "100% 가 나왔을 때 좋은 건지 나쁜 건지" 가르는 법이에요.
개념 설명
원리
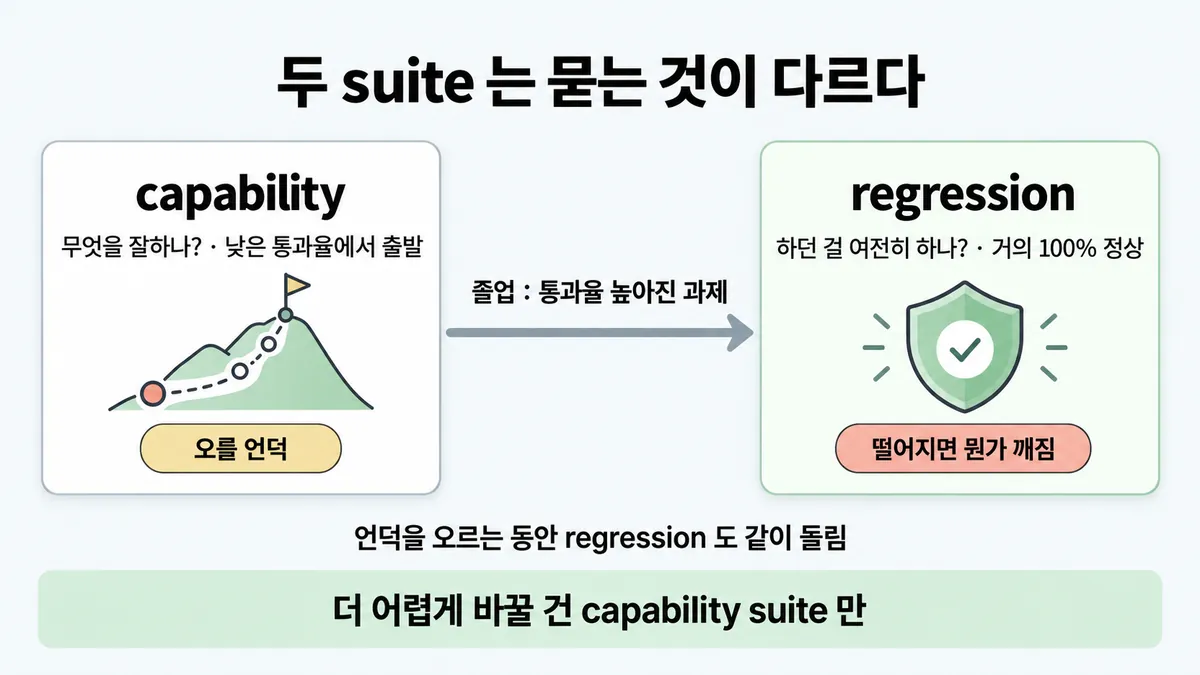
두 suite 는 묻는 질문이 다르다
- capability(능력, "quality") eval 은 "이 에이전트가 무엇을 잘하나?" 를 묻는다. 에이전트가 힘들어하는 과제를 겨눠 낮은 통과율에서 출발한다. 그래서 올려 갈 여지(hill to climb, 통과율을 올려 갈 과제)가 생긴다.
- regression(회귀) eval 은 "하던 걸 여전히 다 하나?" 를 묻는다. 거의 100% 가 정상이다. 점수가 떨어지면 뭔가 깨졌다. 이것이 회귀 신호다.
그래서 같은 100% 가 뜻이 반대다
- regression 100% 는 건강하다는 뜻이다. 계속 돌린다.
- capability 100% 는 포화(saturation)다. 회귀(regression)는 잡아 주지만 더 나아졌는지는 알려 주지 않는다.
이관(graduate)
- 출시·최적화 뒤 통과율이 높아진 capability 과제는 regression suite 로 옮겨 계속 돌린다. 그러면 drift 를 잡는다.
- 같은 과제의 뜻이 "할 수는 있나?"에서 "여전히 믿고 할 수 있나?"로 바뀐다.
- capability 쪽에는 더 어려운 과제와 새 eval 을 채운다. Qodo 는 한 번에 푸는 코딩 eval 이 긴 과제의 향상을 못 잡자 새 에이전트 eval 틀을 만들었다.
포화가 속이는 방식
- 포화에 가까우면 가장 어려운 과제만 남아 진척이 느려 보인다. 그래서 큰 capability 향상이 작은 점수 오름으로 보인다.
점수를 그대로 믿지 않는다
- 점수가 안 오를 때는 transcript 를 읽어 먼저 확인한다. 에이전트 탓인지, eval 탓(채점 버그·모호한 과제·하네스 제약)인지 본다.
- 실례가 있다. CORE-Bench 에서 Opus 4.5 는 처음에 42% 였다. 채점이 "96.124991…" 를 기대해 "96.12" 를 틀림 처리하는 등의 문제를 고쳤다. 그 뒤 95% 가 됐다.
두 suite 를 같이 돌린다
- capability 통과율을 올리는 동안 regression 도 같이 돌린다. 바꾼 것이 다른 곳을 깨지 않았는지 본다.
- Descript 는 품질 벤치마크용과 regression 용 두 suite 를 따로 정기적으로 돌린다.
핵심 질문 두 개
- 이 suite 는 "잘하나"를 묻나, "여전히 하나"를 묻나?
- 점수 변화가 에이전트 때문인가, eval 때문인가?
규칙과 판단
갈림길
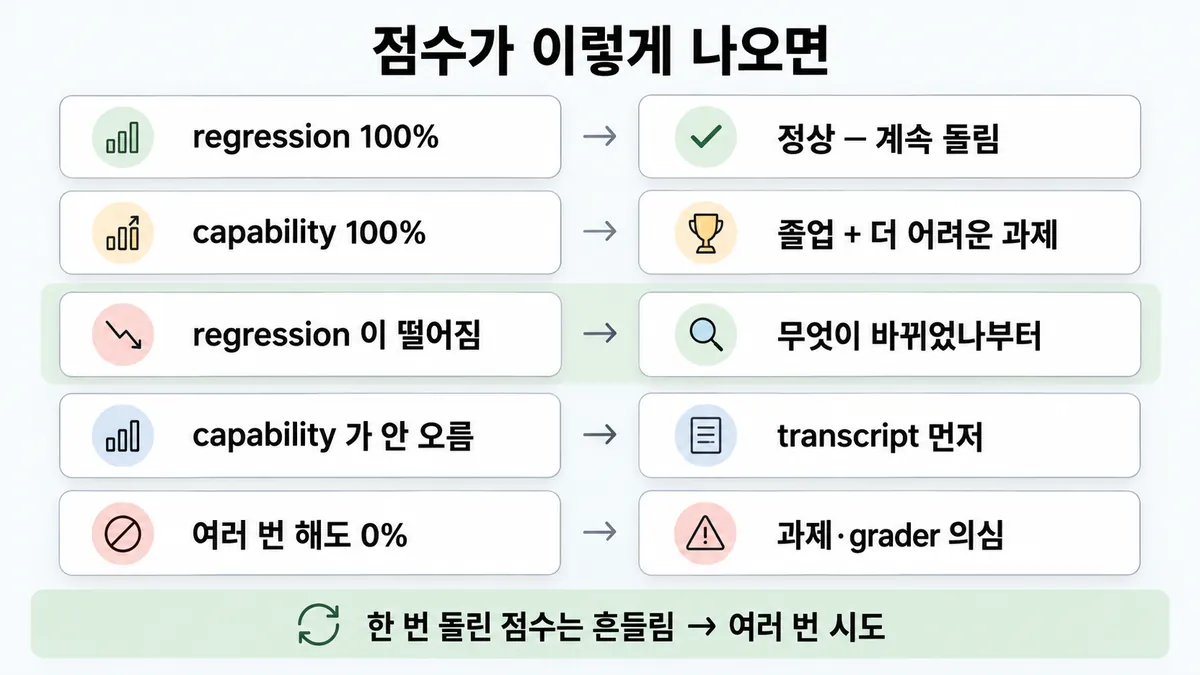
100% 가 나왔다 [4.3②]
정상이니 계속 돌린다
거의 100% 가 정상이다
regression 으로 이관하고 더 어려운 과제를 채운다
통과율이 높아진 capability(능력) 과제는 regression(회귀) suite 로 이관한다. capability 쪽에는 더 어려운 과제와 새 eval 을 채운다
점수가 이상하다 [4.3②]
뭔가 깨졌다
무엇이 바뀌었나부터 본다 (■ 변경부터 묻는 진단)
transcript 먼저
에이전트 탓인지 eval 탓인지 transcript 로 확인한다
과제·grader 를 의심한다
0% pass@100 은 대개 과제 자체의 결함이다 (■ 첫 eval 셋 만들기)
작다고 단정하지 않는다
포화에 가까우면 큰 향상이 작은 점수 오름으로 보인다
여러 번 시도한다
한 번 돌린 점수는 흔들린다. 그래서 여러 번 시도(trial)한다 (◆ pass@k vs pass^k)
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 변경 → capability suite → regression suite
규칙 (capability suite) : 낮은 통과율에서 출발한다. 통과율을 올려 갈 여지가 있다
규칙 (regression suite) : 거의 100% 가 정상이다. 떨어지면 뭔가 깨졌다
질문 : 100% 는 어느 suite 에서 좋은 소식일까?
① 통과율을 올리고 regression 으로 ✓
- 시작 : 변경 — 쪽지 : 프롬프트 v7 / + 교환 규정 3단계 안내
- 출발 : capability suite : 낮은 통과율에서 출발한다 — 쪽지 : 교환 과제 20개 / v6 : 6/20 (30%)
- 돌림 : 변경 → capability suite : 통과율을 올리는 중이다 — 쪽지 : v7 : 19/20 (95%)
- 돌림 : 변경 → regression suite : 다른 곳이 안 깨졌나 본다 — 쪽지 : 환불·배송 과제 60개 / v7 : 60/60
- 이관 : capability suite → regression suite : 통과율이 높아진 과제를 옮긴다 — 쪽지 : 교환 과제 20개 합류 / regression suite 80개
- 끝 : "할 수 있나?" 가 "여전히 믿고 할 수 있나?" 로 바뀐다
② regression 이 떨어진다 ≠
- 시작 : 변경 — 쪽지 : 프롬프트 v8 / 말투 문장 수정
- 돌림 : 변경 → regression suite : 정상은 거의 100% 다 — 쪽지 : v7 : 80/80 / v8 : 71/80 (89%)
- 떨어짐 : regression suite : 떨어지면 뭔가 깨졌다 — 쪽지 : 실패 9개 : 전부 환불 과제
- 끝 : regression 이 떨어지면 뭔가 깨졌다. 무엇이 바뀌었나부터 본다
③ capability 100% 인데 그대로 ≠
- 시작 : 변경 — 쪽지 : 프롬프트 v9
- 돌림 : 변경 → capability suite : 이미 100% 다 — 쪽지 : v8 : 20/20 / v9 : 20/20
- 멈춤 : capability suite : 개선 신호가 없다 — 쪽지 : v9 가 나아졌나? / 점수로는 알 수 없음
- 끝 : 100% 인 capability suite 는 개선 신호가 없다. regression 으로 이관한다. capability 쪽에는 더 어려운 과제와 새 eval 을 채운다
규칙 원문 갈림 기준 점수 읽기 (갈림길로 그린 규칙)
갈림 기준
이 suite 가 무엇을 묻는지 먼저 본다
- capability("quality") eval 은 "무엇을 잘하나?" 를 묻는다. 낮은 통과율에서 출발해 올려 갈 여지(hill to climb)를 준다. 에이전트가 힘들어하는 과제를 겨눈다
- regression eval 은 "하던 걸 여전히 하나?" 를 묻는다. 거의 100% 가 정상이다. 떨어지면 뭔가 깨졌다. 그래서 회귀를 막는다
- capability 통과율을 올리는 동안 regression 도 같이 돌린다. 다른 곳이 안 깨졌나 본다
- 이관(graduate) : 출시·최적화 뒤 통과율이 높아진 capability 과제는 regression suite 로 옮긴다. 거기서 계속 돌려 drift 를 잡는다. "할 수 있나?" 가 "여전히 믿고 할 수 있나?" 로 바뀐다
- 포화(saturation) : 100% 인 eval 은 회귀(regression)는 잡지만 개선 신호가 없다. 포화에 가까우면 큰 향상이 작은 점수 오름으로 보인다. 그래서 capability 쪽에는 더 어려운 과제와 새 eval 을 채운다(Qodo 는 새 에이전트 eval 틀을 만들었다)
- 두 suite 를 따로 운영한다. Descript 는 품질 벤치마크용과 regression 용 두 suite 를 정기적으로 돌린다
- capability eval 은 아직 못 하는 기능에도 먼저 만든다. 그러면 새 모델이 나왔을 때 미리 만든 eval 중 어느 것이 통과하는지(어느 예상이 맞았는지) 보인다
- 자세한 것은 ■ 변경마다 eval 다시 에 있다
점수 읽기
regression 이 떨어지면 뭔가 깨졌다. 무엇이 바뀌었나부터 본다 (■ 변경부터 묻는 진단)
capability 가 안 오르면 점수를 그대로 믿지 않는다. transcript 를 먼저 읽는다. 에이전트 탓인지 eval 탓인지 transcript 로 확인한다
capability 가 여러 번 해도 0% 면 과제와 grader(채점기)를 의심한다. 0% pass@100 은 대개 과제 자체의 결함이다 (■ 첫 eval 셋 만들기)
한 번 돌린 점수는 흔들린다. 그래서 여러 번 시도(trial)한다 (◆ pass@k vs pass^k)
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
| capability eval 을 새로 만든다 | 낮은 통과율에서 출발하게 한다(힘든 과제를 겨눈다) | demystifying-evals "They should start at a low pass rate, targeting tasks the agent struggles with" |
| regression suite 가 거의 100% 다 | 정상이다. 계속 돌린다 | "should have a nearly 100% pass rate" |
| regression 점수가 떨어졌다 | 뭔가 깨졌다. 무엇이 바뀌었나부터 본다 | "a decline in score signals that something is broken" |
| capability 통과율을 올리는 중이다 | regression 도 같이 돌린다 | "it’s important to also run regression evals" |
| capability 과제 통과율이 높아졌다(출시·최적화 뒤) | regression suite 로 이관한다 | "capability evals with high pass rates can “graduate” to become a regression suite" |
| capability eval 이 100% 다 | 개선 신호가 없다. 더 어려운 과제와 새 eval 을 채운다 | "An eval at 100% tracks regressions but provides no signal for improvement" · "Make sure the problems are hard enough for the model." |
| capability 점수가 안 오른다 | transcript 를 먼저 읽는다 | "we do not take eval scores at face value until someone digs into the details of the eval and reads some transcripts" |
| capability 가 여러 번 해도 0% 다 | 과제·grader(채점기) 결함을 의심한다 | "0% pass@100 is most often a signal of a broken task" |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| suite 종류 | regression 이다 | 100% 근처 유지가 목표다. 떨어지면 경보다 | 판단 규칙 2·3 | |
| suite 종류 | capability 다 | 낮게 출발해 오르는 것이 목표다. 100% 가 되면 이관할 때다 | 판단 규칙 1·5·6 | |
| 에이전트 단계 | 출시 전이다 | capability eval 통과율을 올린다. regression 도 같이 돌린다 | ||
| 에이전트 단계 | 출시·최적화 뒤다 | 높아진 capability 과제를 regression 으로 이관한다 | "After an agent is launched and optimized" | |
| 점수 위치 | 포화 근처(90%대)다 | 작은 오름도 큰 향상일 수 있다 | 계산 | 뒤집히는 때 2 |
| regression 하락 폭 | 1~2개가 실패했다 | 잡음(비결정성·환경 흔들림)일 수 있다. 다시 돌려 확인한다 | 계산 | 뒤집히는 때 1 |
| regression 하락 폭 | 여러 개가 실패했다 | 뭔가 깨졌다 | 계산 | 뒤집히는 때 1 |
| 새 모델 출시 | capability suite 가 낮은 상태다 | 새 모델로 돌려, 미리 만든 eval 중 어느 것이 통과하는지(어느 예상이 맞았는지) 본다 |
연습 문제
고객지원 Agent 팀이 환불·배송 조회처럼 이미 잘하던 과제하던 일를 모은 suite 가 이번 주에도 100% 통과했다. 한 팀원이 "100% 면 알려 주는 게 없으니 과제를 전부 더 어렵게 바꾸자" 고 한다. 이 suite 를 어떻게 할까?
시험 대비
함정
- "100% 통과한 suite 는 신호가 없으니 전부 더 어렵게 바꾼다" 는 함정이다. regression 은 거의 100% 가 정상이다. 더 어렵게 바꾸는 것은 capability suite 만이다
- "포화된 capability eval 은 버린다" 는 함정이다. regression suite 로 옮겨 계속 돌린다
- "capability eval 통과율이 낮으니 실패작이다" 는 함정이다. capability 는 낮은 통과율에서 출발하는 것이 정상이다
- "regression suite 도 낮은 통과율로 어렵게 짜야 변별력이 있다" 는 함정이다. regression 은 거의 100% 가 정상이다. 떨어지는 것 자체가 신호다
- "capability 점수가 안 오르니 모델부터 바꾼다" 는 함정이다. transcript 를 먼저 읽는다. eval 탓일 수 있다
- "포화 근처 +2%p 는 작은 향상이다" 는 함정이다. 큰 향상이 작은 점수 오름으로 보일 수 있다
- "capability 통과율만 올리면 된다" 는 함정이다. regression 도 같이 돌린다
신호
"Capability or “quality” evals ask, “What can this agent do well?” They should start at a low pass rate, targeting tasks the agent struggles with and giving teams a hill to climb."
"Regression evals ask, “Does the agent still handle all the tasks it used to?” and should have a nearly 100% pass rate."
"As teams hill-climb on capability evals, it’s important to also run regression evals to make sure changes don’t cause issues elsewhere."
"capability evals with high pass rates can “graduate” to become a regression suite that is run continuously to catch any drift."
"An eval at 100% tracks regressions but provides no signal for improvement."
"This can make results deceptive, as large capability improvements appear as small increases in scores."
"When scores don’t climb, we need confidence that it’s due to agent performance and not the eval."
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
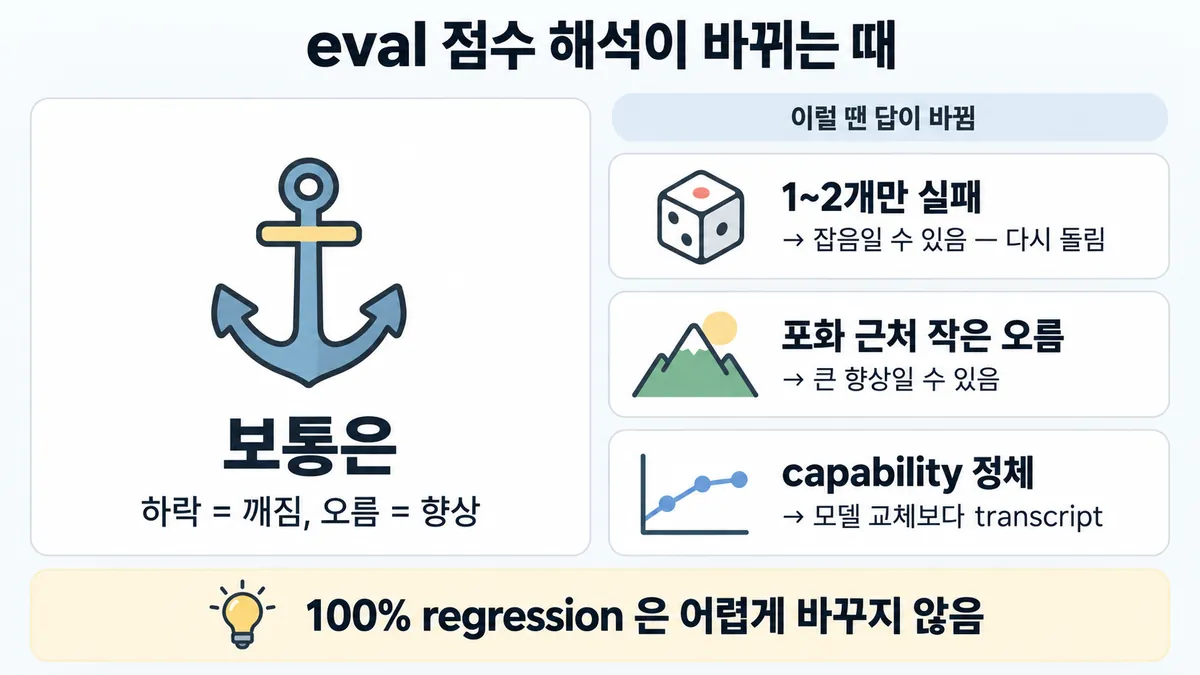
1. regression 이 떨어졌는데 "깨짐"이 아닐 수 있는 때
- 조건 : regression suite 가 250과제다. 평소 과제당 통과 확률이 99.6% 라서 보통 1개쯤 실패한다.
- 계산 : 기대 실패 수 = 250 × 0.004 = 1 이다. 실패 수를 포아송(평균 1)으로 보면 3개 이상 실패할 확률은 ≈ 8% 다. 6개 이상은 ≈ 0.06% 다. 그래서 1~2개 실패는 잡음일 수 있다. 6개(통과율 97.6%)면 우연으로 보기 어렵다. 뭔가 깨진 것이다.
- 전제 : 과제끼리 독립이고 과제당 확률이 같다고 본다. 환경을 공유해 같이 실패하면(CPU 메모리 부족 등) 독립이 아니다. 그러면 이 계산이 안 맞는다.
- 판단 : 적게 떨어지면 여러 번 시도(trial)로 다시 돌려 확인한다(◆ pass@k vs pass^k). 많이 떨어지면 무엇이 바뀌었나부터 본다(■ 변경부터 묻는 진단). 여러 과제가 같은 환경 문제로 떨어지면 에이전트가 아니라 하네스를 본다.
- 등급 : 계산 (비결정성·환경 흔들림은 확인)
- 근거 :(여러 trial) · "a task that passed on one eval run might fail on the next" ·(공유 상태·같은 환경 한계는 독립이 아니다)
2. 포화 근처의 작은 오름이 큰 향상인 때
- 조건 : capability suite 150과제에서 점수가 92% 에서 95.3% 로 올랐다.
- 계산 : 못 풀던 과제가 12개에서 7개로 줄었다. 점수는 +3.3%p 지만, 남은 과제의 5/12 ≈ 42% 를 새로 풀었다.
- 판단 : "작은 향상"으로 읽지 않는다. 동시에 곧 포화된다. 그래서 capability 쪽에 더 어려운 과제를 채울 때다.
- 등급 : 계산 (포화가 속인다는 점은 확인)
- 근거 : "large capability improvements appear as small increases in scores"
3. capability 점수가 낮게 머무는데 에이전트 탓이 아닌 때
- 조건 : capability suite 가 몇 주째 35% 에서 안 움직인다.
- 판단 : 모델을 바꾸기보다 transcript 를 먼저 읽는다. 채점 버그 · 모호한 과제 · 하네스 제약이면 eval 을 고친다. 실례로 CORE-Bench 는 42% 였다가 고친 뒤 95% 가 됐다.
4. 100% 인데 더 어렵게 하면 안 되는 때
- 조건 : regression suite 가 100% 다.
- 판단 : 그대로 둔다. regression 은 거의 100% 가 정상이다. "100% 는 신호가 없다"는 capability eval 에만 맞는 말이다. regression 을 어렵게 바꾸면 "떨어지면 경보" 라는 신호가 사라진다.
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "100% 통과한 suite 는 신호가 없으니 전부 더 어렵게" | 공식 문장 "no signal for improvement" 와 닮았다 | regression 은 거의 100% 가 정상이다. 어렵게 바꾸는 것은 capability suite 만이다 | ||
| "포화된 capability eval 은 버린다" | 더 알려 주는 게 없어 보인다 | regression suite 로 옮겨 계속 돌린다 | ||
| "capability eval 통과율이 30% 라 에이전트가 실패작" | 점수가 낮다 | capability 는 낮게 출발하는 것이 정상이다. 그것이 올려 갈 여지다 | ||
| "regression suite 도 변별력 있게 어려운 과제로" | 시험은 어려워야 변별이 된다는 감이 있다 | regression 은 떨어지는 것 자체가 신호다 | ||
| "capability 점수가 안 오르니 더 큰 모델로 교체" | 모델이 약해 보인다 | transcript 를 먼저 읽는다. eval 탓일 수 있다 | ||
| "92% 가 95% 가 된 것은 미미한 향상" | 3%p 라 작아 보인다 | 포화 근처에서는 큰 향상이 작게 보인다 | 계산 | 뒤집히는 때 2 |
| "capability 통과율만 올리면 된다" | 진척이 보이는 쪽에만 집중한다 | regression 도 같이 돌려야 다른 곳이 안 깨진다 | ||
| "regression 1개 실패 = 즉시 롤백" | 떨어지면 깨졌다고 외웠다 | 1~2개는 비결정성 잡음일 수 있다. 다시 돌려 확인한다 | 계산 | 뒤집히는 때 1 |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
미해결
- 이관 기준 통과율(몇 % 면 regression 으로 옮기나)과 regression "nearly 100%" 의 정확한 선은 공식 숫자가 없다. 원문은 "high pass rates" · "nearly 100%" 뿐이다.
- 뒤집히는 때 1 의 "regression 하락이 잡음인가" 선 긋기는 공식 방법이 없다. 포아송 계산은 이 쪽에서 만든 것이다(계산). 공식은 여러 trial 과 독립 환경만 말한다.
- 목록 4.3② 의 규칙과 영어 신호 2문장은 원문에서 찾았다. 고친 곳은 없다. 영상 "P9 [17:48] 요령" 은 영상을 보지 않아 확인하지 않았다.