■ 지연 줄이기 lever
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 3.3 정확도와 지연 절충 · D3 연결 19%Evaluate accuracy-latency trade-offs and justify configuration decisions
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 3.3① 상담원이 "답 초안이 늦게 뜬다"고 한다 — 모델부터 바꾸나? — 지연 lever 고르기 (스트리밍 · 캐싱 · 출력 길이 · effort · 모델 교체)
- 4.1② 첫 토큰은 빨라졌는데 "여전히 느리다"고 한다 — 지연 지표 고르기 (TTFT vs 응답 완료까지)
- 4.5② 보기마다 다른 최적화 — 이 시나리오의 레버는 무엇 하나? — 시나리오 단서 → 레버 하나 (캐싱 · 배치 · 라우팅/effort · 스트리밍)
- 2.1② 품질이 조금 모자라거나 비용이 남는다 — 모델을 바꿀까, effort 를 바꿀까? — 조절 수단 순서 (effort → 모델 교체 → 섞인 요청은 모델 조합·라우팅)
한눈에
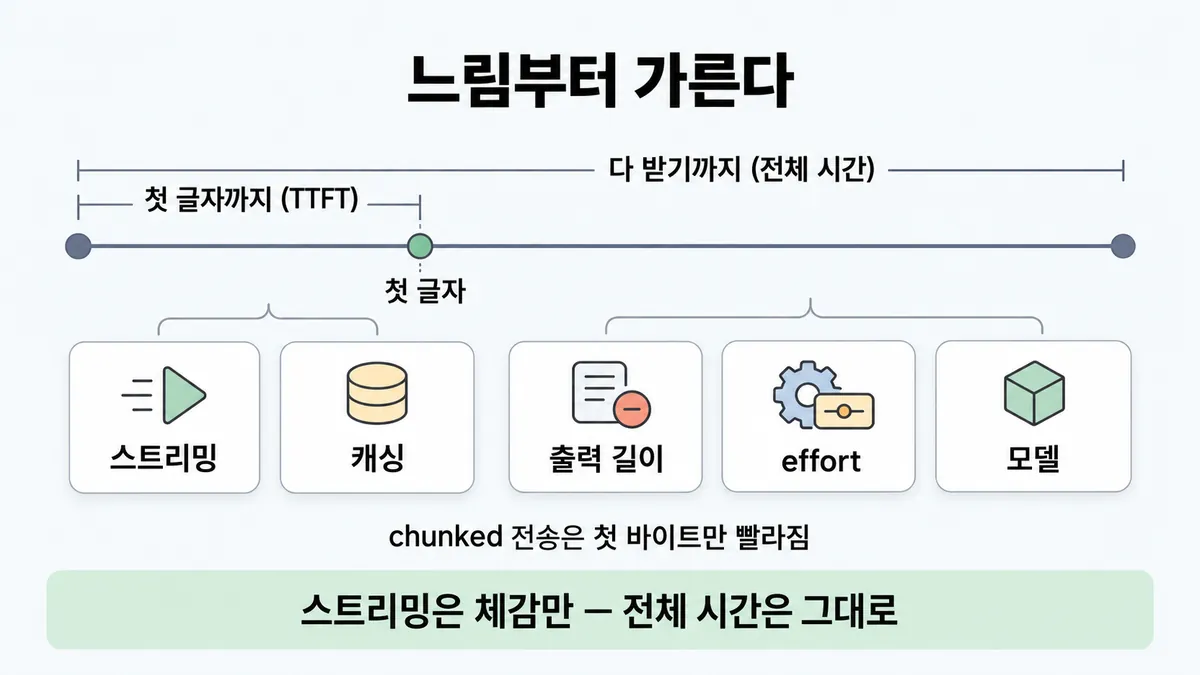
"느리다"가 어느 쪽인지 먼저 가른다. 첫 글자까지(TTFT, time to first token)인가, 다 받기까지(전체 시간)인가? lever(조절 수단)는 다섯이다
- 스트리밍
- 캐싱
- 출력 길이
- effort
- 모델(교체 · fast mode)
품질은 지켜야 하니 eval 로 확인하며 돌린다
비유 웹 응답 튜닝과 같다. chunked 전송(첫 바이트만 빨라진다), CDN 캐시(오리진에 안 간다), 응답 크기 줄이기, 워커 설정 튜닝을 쓴다. 인스턴스 타입 교체는 확인한 뒤에 한다
ELI5
식당에서 음식이 늦게 나온다고 할 때를 생각해 보세요.
- 물과 반찬을 먼저 내주면 덜 기다린 것처럼 느껴져요.
- 매번 쓰는 재료를 미리 손질해 두면 첫 접시가 빨리 나와요.
- 양을 줄이거나 조리를 간단히 하면 다 나오는 시간이 줄어요.
- 요리사를 바꾸는 건 맛이 그대로인지 먼저 맛본 뒤에 해요.
개념 설명
원리
지연(latency)은 두 가지다
- 첫 글자까지(TTFT) : 요청을 보내고 첫 토큰이 나올 때까지다. 입력 처리 시간이 큰 몫을 차지한다.
- 다 받기까지 : TTFT 에 출력 토큰을 다 생성하는 시간을 더한 것이다. 출력이 길수록 길다.
- 공식 : 처리·생성할 토큰이 적을수록 응답이 빠르다.
lever(조절 수단)마다 건드리는 곳이 다르다
- 스트리밍 : 생성은 그대로 두고 오는 대로 보여 준다. 그래서 체감만 줄인다.
- 캐싱 : 매번 같은 앞부분 처리를 건너뛴다. 그래서 TTFT 와 입력 비용을 줄인다. 출력 시간은 건드리지 않는다.
- 출력 길이 : 생성할 토큰 수 자체를 줄인다. 그래서 전체 시간이 준다.
- effort : 한 모델 안에서 thinking(사고)·도구 호출·텍스트 토큰 양을 줄인다. 그래서 전체 시간과 비용이 준다. 대신 지능이 조금 내려간다.
- 모델 : 더 빠른 모델(Haiku 4.5)로 바꾸거나 fast mode 를 쓴다(같은 Opus, 출력 속도 최대 2.5배, 비싸다).
왜 "모델부터"가 약한 답인가
- 공식 지연 문서는 모델 선택을 가장 직접적인 방법 중 하나로 든다. 그러니 모델 교체 자체가 틀린 것은 아니다.
- 다만 "effort 조정이 모델 교체보다 나은 경우가 많다"는 것도 공식이다. 과제를 무시한 축소는 품질을 해칠 위험이 있다(샘플 2).
- 그래서 시험 답은 이런 모양이다. 증상을 가른다. 품질을 지키는 가장 싼 lever 부터 돌린다. 모델 교체는 eval 로 확인한 뒤에 한다.
핵심 질문 두 개
- 느린 게 첫 글자인가, 다 받기까지인가?
- 이 lever 를 돌리면 품질이 떨어지나? 떨어진다면 eval 로 확인했나?
규칙과 판단
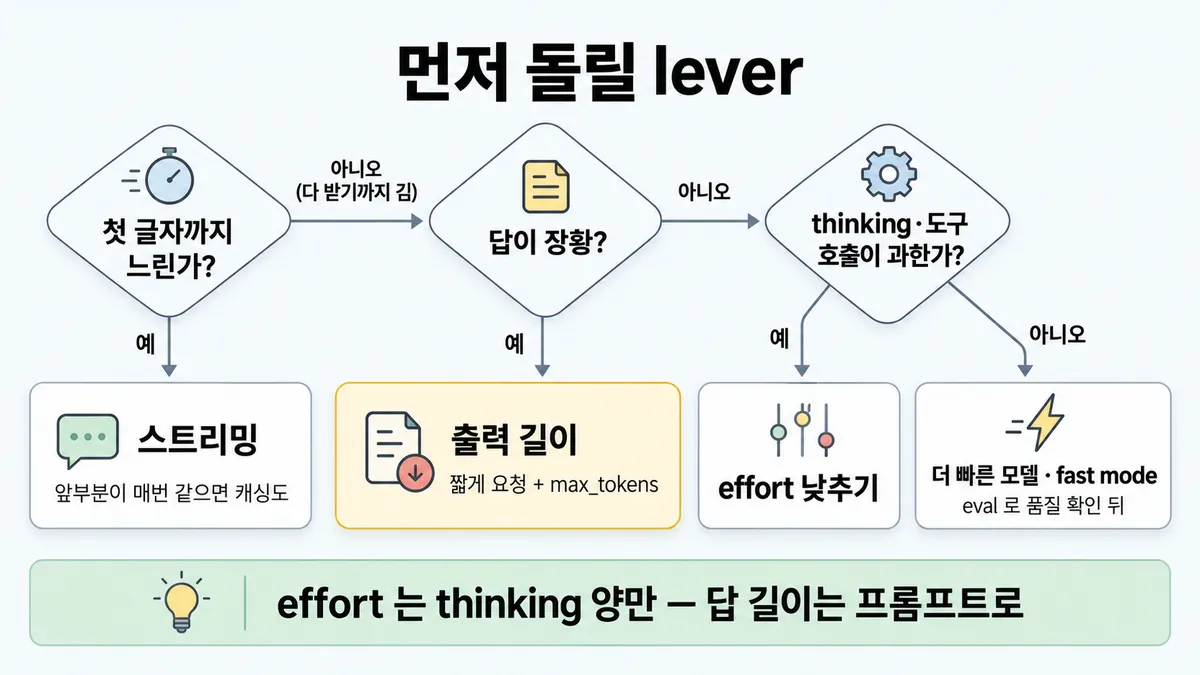
갈림길
①②③⑥ 느린 구간 찾기 [3.3①]
캐싱 + 스트리밍
TTFT 와 per-request cost(요청당 비용)를 같이 줄인다. 필요한 문맥은 버리지 않는다 (샘플 2 정답). 첫 요청의 캐시 미스까지 없애려면 캐시 사전 워밍(pre-warming)을 한다
스트리밍
출력이 오는 대로 보여 줘서 체감 반응성을 크게 올린다
출력 길이
"짧게 답해"라고 요청하고 max_tokens 로 상한을 건다. effort 는 thinking(사고) 양을 줄일 뿐 답 길이를 줄이지 않는다
다음 물음 — thinking·도구 호출이 과한가?
④⑤⑥ lever 고르기 [3.3①] [2.1②]
effort 를 낮춘다
모델 바꾸기보다 나은 경우가 많다
더 빠른 모델
교체는 eval 로 정확도·품질·엣지 케이스를 비교한 뒤에 한다
fast mode
출력 속도가 최대 2.5배다. 요금이 비싸다. 리서치 프리뷰다
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 요청 → 모델 → 화면
질문 : 스트리밍을 켜면 다 받는 시간도 줄까?
① 스트리밍은 첫 글자를 당긴다 ✓
- 시작 : 요청 — 쪽지 : stream: true / "이 상담 요약해 줘"
- 요청 : 요청 → 모델 : 스트리밍으로 보낸다 — 쪽지 : 출력 생성 시작
- 첫 글자 : 모델 → 화면 : 출력이 오는 대로 보여 준다 — 쪽지 : 0.8초: "고객은 배송…"
- 끝 : 첫 글자가 바로 떠서 체감 반응성을 크게 올린다
② 스트리밍으로 전체 시간을 줄이려 한다 ≠
- 시작 : 요청 — 쪽지 : stream: true / "이 상담 요약해 줘"
- 요청 : 요청 → 모델 : 스트리밍으로 보낸다 — 쪽지 : 출력 생성 시작
- 첫 글자 : 모델 → 화면 : 오는 대로 보여 준다 — 쪽지 : 0.8초: "고객은 배송…"
- 전체 : 모델 → 화면 : 총 생성 시간은 그대로다 (업계 일반) — 쪽지 : 20초: 900 토큰째 / 마지막 글자
- 끝 : 스트리밍은 체감만 줄인다. 생성할 토큰 수가 같아 다 받는 시간은 안 줄어든다
③ 출력을 줄이면 전체 시간이 준다 ✓
- 시작 : 요청 — 쪽지 : "3줄로 짧게 요약해" / max_tokens: 300
- 요청 : 요청 → 모델 : "짧게 답해" 에
max_tokens상한을 건다 — 쪽지 : 출력 생성 시작 - 전체 : 모델 → 화면 : 생성할 토큰이 줄어든다 — 쪽지 : 250 토큰째 / 마지막 글자
- 끝 : 전체 시간이 문제면 토큰을 줄인다
규칙 원문 ①②③④⑤⑥ (갈림길로 그린 규칙)
-
체감(TTFT)이 문제면 스트리밍을 쓴다. 출력이 오는 대로 보여 줘서 체감 반응성을 크게 올린다 [3.3①]
총 생성 시간은 그대로다 업계 일반 공식은 "perceived"라고만 씀
-
매번 같은 긴 앞부분이 있으면 캐싱한다. TTFT 와 per-request cost 를 같이 줄인다. 필요한 문맥은 버리지 않는다 (샘플 2 정답) [3.3①]
첫 요청의 캐시 미스까지 없애려면 캐시 사전 워밍(pre-warming)을 한다
자세한 것은 ■ 프롬프트 캐싱 에 있다
-
전체 시간이 문제면 토큰을 줄인다. 입력은 명확하되 간결하게 쓴다. 출력은 "짧게 답해"라고 요청하고
max_tokens로 상한을 건다. 너무 낮으면 잘린다(4.5③) -
effort 낮추기 : 한 모델 안에서 지능과 지연(latency)·비용을 맞바꾼다. effort 는 모든 출력 토큰(텍스트·도구 호출·thinking)에 걸린다. 낮추면 도구 호출도 적어진다. 모델 바꾸기보다 나은 경우가 많다 (규칙 본편 = 2.1②)
단 effort 는 thinking 양을 줄일 뿐 답 길이를 줄이지 않는다. 답이 길면 ③ 을 쓴다 (Opus 5 문서)
기본값은 대부분 high 다. Opus 5.5 는 medium 이다 (2026-09-22 출시, 시험 뒤 변경)
-
모델 : 속도가 최우선이면 Haiku 4.5 가 가장 빠르다. Opus 5.5/5/4.8 에는 fast mode 가 있다(출력 속도 최대 2.5배, 비싼 요금, 리서치 프리뷰)
교체는 eval 로 정확도·품질·엣지 케이스를 비교한 뒤에 한다
-
증상으로 먼저 잡을 lever 는 아래와 같다 (각 칸 = 확인, 순서 자체는 업계 일반)
증상 먼저 첫 글자까지 몇 초 걸린다 · 앞부분이 매번 같다 캐싱 + 스트리밍 첫 글자는 빠른데 다 받기까지 길다 · 답이 장황하다 출력 길이 (프롬프트 · max_tokens) thinking·도구 호출이 과하다 · 품질 여유가 있다 effort 낮추기 위 lever 로도 부족하다 · eval 상 품질 여유가 크다 더 빠른 모델 품질 여유가 없다 · 돈은 있다 fast mode
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
| 첫 글자까지 느리다는 체감 불만이 있다 | 스트리밍을 쓴다 | reduce-latency "This can significantly improve the perceived responsiveness of your application" |
| 매번 같은 긴 앞부분이 있다. 지연·비용이 둘 다 문제다 | 고정 내용을 앞에 두고 캐싱한다 | 가이드 샘플 2 정답 C "reducing both time-to-first-token and per-request cost without discarding required context" |
| 첫 요청의 캐시 미스 지연도 없애야 한다 | 캐시 사전 워밍(pre-warming)을 한다 | prompt-caching |
| 답이 장황해 다 받기까지 길다 | 짧게 답하라고 요청하고 max_ 상한을 건다 | reduce-latency |
| 품질 여유가 있고 지연·비용을 줄여야 한다 | effort 를 낮춘다 (모델 교체보다 먼저) | choosing-a-model "Tuning effort is often a better lever than switching models." · effort |
| effort 를 낮췄는데 답 길이가 그대로다 (Opus 5) | 길이는 프롬프트로 줄인다 | effort "Effort controls thinking volume, not visible response length" |
| 지연 요구가 엄격하다. 단순 대량 작업이다 | 빠른 모델(Haiku 4.5)로 시작한다. 기능 격차가 있을 때만 올린다 | choosing-a-model |
| 모델을 바꾸려 한다 | 실제 프롬프트·데이터로 정확도·품질·엣지 케이스를 비교한 뒤에 바꾼다 | choosing-a-model |
| 품질을 못 내려놓고 출력 속도가 문제다 | fast mode 를 쓴다 (Opus 5.5 · 5 · 4.8, 비싼 요금) | choosing-a-model |
| 배치 작업의 지연을 줄이려 한다 | fast mode 는 못 쓴다 (동기 지연용) | batch-processing |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 불만의 종류 | 첫 글자까지 | 스트리밍 · 캐싱 | 판단 규칙 1·2 | |
| 불만의 종류 | 다 받기까지 | 출력 길이 · effort · 모델 | reduce-latency · 판단 규칙 5 | |
| 앞부분 | 매번 같고 최소 캐시 길이 이상이다 | 캐싱이 TTFT 를 줄인다 | ■ 프롬프트 캐싱 · 규칙 ② | |
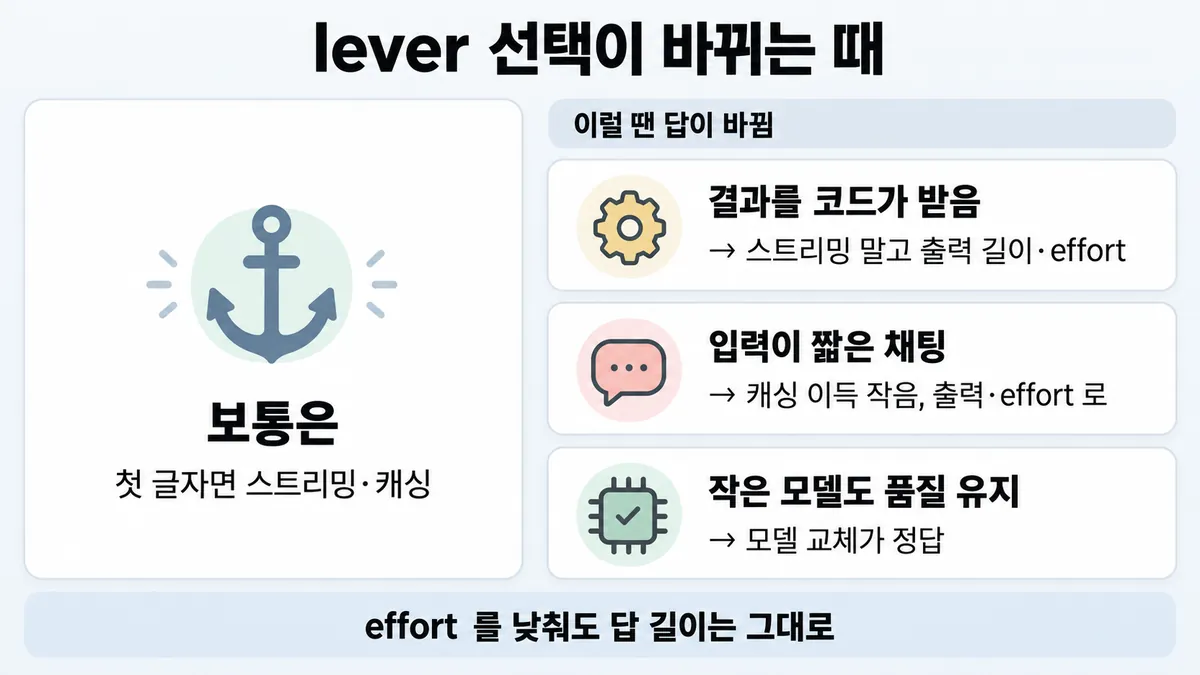
| 앞부분 | 짧거나 매번 다르다 | 캐싱 효과가 없다. 다른 lever 를 쓴다 | 뒤집히는 때 2 | |
| 소비자 | 사람이 화면을 본다 | 스트리밍이 쓸 만하다 | reduce-latency | |
| 소비자 | 뒤 단계 코드가 결과 전체를 기다린다 | 스트리밍의 체감 이득이 없다 | 업계 일반 | 뒤집히는 때 1 |
| 품질 여유 | 있다 (eval 로 확인) | effort 를 낮추거나 작은 모델을 쓴다 | effort · choosing-a-model | |
| 품질 여유 | 없다 | fast mode · 출력 길이 · 캐싱 | choosing-a-model | |
| 모델 | Opus 5.5 | effort 를 생략하면 medium 으로 실행된다 | effort (시험 뒤 변경 2026-09-22) | |
| 대화 중 effort 변경 | 캐시에 기대는 대화다 | 요청 수준(top-level) effort 는 대화 중 고정한다. 바꾸려면 메시지별 effort(베타)를 쓴다 | effort |
연습 문제
상담 요약 기능에서 첫 글자는 1초 안에 뜨는데첫 글자 빠름 전체 답이 끝나기까지 20초가 걸린다. 답을 보면 같은 말을 되풀이하며 장황하다장황. 팀은 스트리밍을 켜자고 한다. 먼저 돌릴 lever 는 무엇인가?
시험 대비
함정
- 과제를 무시하고 제일 작은 모델로 바꾸는 것은 함정이다. 오답이다 (샘플 2 B)
- "스트리밍을 켜면 전체 처리 시간이 준다" 는 함정이다. 스트리밍은 체감만 줄인다 업계 일반
- "effort 를 낮추면 답이 짧아진다" 는 함정이다. thinking 양만 줄어든다. 길이는 프롬프트로 줄인다
- 캐시를 쓰는 대화 중간에 요청 수준(top-level) effort 값을 바꾸는 것은 함정이다. 캐시가 무효가 된다. 워크로드 단위로 바꾸거나 메시지별 effort(베타)를 쓴다
- "모델 교체는 항상 오답이다" 는 함정이다. 공식 지연 문서는 모델 선택을 첫 방법으로 든다. eval 로 품질을 확인하면 맞는 답이다
- fast mode 를 배치에 거는 것은 함정이다. 배치에서는 안 된다. fast mode 는 동기 지연용이다
신호
"Tuning effort is often a better lever than switching models."
"This can significantly improve the perceived responsiveness of your application"
"reducing both time-to-first-token and per-request cost without discarding required context" (가이드 샘플 2)
"downsizing blindly (B) risks quality" (가이드 샘플 2)
"Effort controls thinking volume, not visible response length"
"When latency matters or tasks are straightforward, low effort can significantly reduce response times and costs."
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
1. 스트리밍이 답이 아닌 때
- 조건 : 사람이 보는 화면이 없다. 분류 결과를 다음 단계 코드가 통째로 받아 큐에 넣는다.
- 판단 : 스트리밍은 "보이는" 반응성을 올리는 것이다. 그래서 기다리는 쪽이 코드면 얻는 게 없다. 전체 시간을 줄이는 lever(출력 길이 · effort · 모델)를 쓴다.
- 전제 : 부분 결과를 먼저 쓸 수 있는 흐름이 아니다.
- 등급 : 업계 일반 (공식은 "perceived responsiveness"·"users can see the model's output"까지만 말한다)
- 근거 : reduce-latency
- 곁가지 : 긴 출력은 SDK 가 HTTP 타임아웃을 피하려고 스트리밍을 요구한다. 이때 스트리밍은 체감이 아니라 연결 유지용이다 (streaming · errors, 본편 4.5③).
2. 캐싱을 켰는데 첫 글자가 안 빨라지는 때
- 조건 : 입력이 900 토큰 정도로 짧은 채팅이다. 모델은 Haiku 4.5 다.
- 계산 : Haiku 4.5 최소 캐시 길이는 4,096 > 900 이다. 그래서 캐시가 아예 안 만들어진다. 그리고 입력이 짧으면 TTFT 에서 입력 처리 몫이 작다. 그래서 캐싱으로 줄일 것도 적다.
- 처방 : 출력 길이 · effort · 스트리밍 쪽을 본다.
- 등급 : (최소 길이) · 업계 일반(입력이 짧으면 캐싱 이득이 작다)
- 근거 : ■ 프롬프트 캐싱 · 규칙 ② prompt-caching
3. fast mode 로 얼마나 줄어드나
- 조건 : 품질 때문에 Opus 를 못 내려놓는다. 한 응답 12초 중 입력 처리·대기가 2초, 출력 생성이 10초라 치자.
- 계산 : fast mode 는 출력 속도가 최대 2.5배다. 출력 10초 ÷ 2.5 = 4초다. 그래서 전체는 약 6초다 (최대치 기준, 입력 몫 2초는 그대로라고 가정).
- 전제 : "최대" 2.5배라 실제는 덜 줄 수 있다. 요금은 프리미엄이다. 리서치 프리뷰다. 배치에서는 못 쓴다.
- 등급 : 계산 (2.5배는 확인)
- 근거 : choosing-a-model · 릴리스 노트 · batch-processing
4. 모델 교체가 맞는 답인 때
- 조건 : 지연 요구가 엄격한 대량·단순 작업이다. effort 를 낮춰도 목표에 못 미친다. 실제 데이터 eval 에서 작은 모델이 품질을 지킨다.
- 판단 : 모델 교체(또는 처음부터 Haiku 4.5)가 정답이다. "모델 교체 = 오답"으로 외우면 여기서 틀린다.
- 근거 : choosing-a-model · reduce-latency
5. 모델만 바꿨는데 지연·품질이 같이 달라진 때 (시험 뒤 변경)
- 조건 : effort 를 명시하지 않은 채 Opus 5 에서 Opus 5.5 로 옮긴다.
- 판단 : Opus 5.5 기본 effort 는 medium 이다(Opus 5 는 high). 그래서 한 단계 낮게 실행된다. 지연·비용이 줄고 품질이 변할 수 있다. 그러니 effort 를 명시하고 eval 로 스윕한다.
- 등급 : 시험 뒤 변경(2026-09-22). 시험은 "대부분 모델 기본 high"로 물을 가능성이 있다(추론).
- 근거 : effort · 릴리스 노트
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "과제와 상관없이 가장 작은 모델로" | 작은 모델이 빠르고 싸다 | 품질이 위험하다. 과제 적합도를 eval 로 봐야 한다 | 가이드 샘플 2 해설 "downsizing blindly (B) risks quality" | |
| "정책 문서를 잘라 입력을 줄인다" | 토큰이 줄면 빨라진다(공식) | 필요한 내용을 잃는다. 반복 앞부분은 캐싱한다 | 가이드 샘플 2 해설 "Truncation (A) loses needed policy" | |
| "스트리밍을 켜면 전체 처리 시간이 준다" | 빨리 뜨니 빨라진 것 같다 | 체감만 준다. 생성 토큰 수는 같다 | 업계 일반 | reduce-latency ("perceived") |
| "effort 를 낮추면 답이 짧아진다" | 적게 쓰라는 설정 같다 | thinking 양만 줄어든다(Opus 5). 길이는 프롬프트로 줄인다 | effort | |
| "모델 교체는 항상 오답" | effort 먼저라는 말을 과하게 외웠다 | 공식 지연 문서의 첫 방법이 모델 선택이다. eval 로 확인하면 맞는 답이다 | reduce-latency · choosing-a-model | |
| "캐싱은 비용만 줄이고 지연엔 무관" | 할인 얘기만 들었다 | TTFT 도 줄인다 | 가이드 샘플 2 해설 · prompt-caching | |
| "지연 줄이려고 대화 도중 effort 를 요청마다 바꾼다" | 요청마다 최적값을 쓰고 싶다 | 요청 수준 effort 를 바꾸면 캐시가 무효가 된다. 그래서 오히려 느려질 수 있다 | effort | |
| "fast mode 를 배치에 걸어 배치를 빠르게" | 빠른 모드니까 | 배치에서는 speed 를 지원하지 않는다 | batch-processing |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 3.3 공식 시험 가이드 v1.0
- 샘플 2 공식 시험 가이드 v1.0
- reduce-latency
- choosing-a-model
- effort
- prompt-caching
- batch-processing
- 릴리스 노트
- Skilljar API 287734
상태
- 업계 일반 2줄(스트리밍 총시간 · ⑥ 순서)
- 시험 뒤 변경 1곳(Opus 5.5 기본 medium)
미해결
- lever 순서표(카드 ⑥)는 공식 한 문서에 없다. 지연 문서(모델 · 길이 · 스트리밍), 캐싱 문서, effort 문서를 합쳐 만든 순서라 업계 일반이다.
- fast mode 가 TTFT 도 줄이는지 : 받은 원문은 "출력 속도(output speed)"만 말한다 (choosing-a-model). fast-mode 문서는 받지 않았다.
temperature를 낮추면 "때때로" 더 짧은 답이 나온다 (reduce-latency). 지연 lever 로 물을지 불확실해서 카드에는 넣지 않았다.- 공식 지연 문서(reduce-latency)는 캐싱·effort 를 지연 방법으로 들지 않는다. 캐싱의 지연 효과는 샘플 2 해설과 캐싱 문서가 근거다. effort 는 effort 문서와 모델 선택 문서가 근거다.