■ 운영 → eval feedback loop
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 4.6 로깅과 관측으로 감시 · D4 평가 16%Monitor system performance using logging and observability tools
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 4.6② 출시 뒤 품질이 조용히 떨어진다 — 무엇을 돌리나? — 운영 신호를 eval 로 되먹이는 루프
- 6.3② 월간 검토에서 법무팀이 놓친 조항 사례를 들고 왔다 — 이 피드백을 어디로 보내나? — 피드백 루프를 닫는 방법 (상태 보고 회의 vs 평가셋 편입)
- 6.5① 핸드오프가 끝났다 — 아키텍트가 계속 할 일 두 가지는? (복수 응답) — 수명주기 5단계(디스커버리·설계·핸드오프·모니터링·반복)는 되돌아오는 루프 — 핸드오프 뒤 할 일
- 6.5② 문서를 갱신한 뒤 확신에 찬 오답이 나온다 — "모델이 드리프트했다"? — 핸드오프 뒤 품질 저하의 원인 가리기 (고정 모델 ID vs 검색·색인·요구 변화)
한눈에
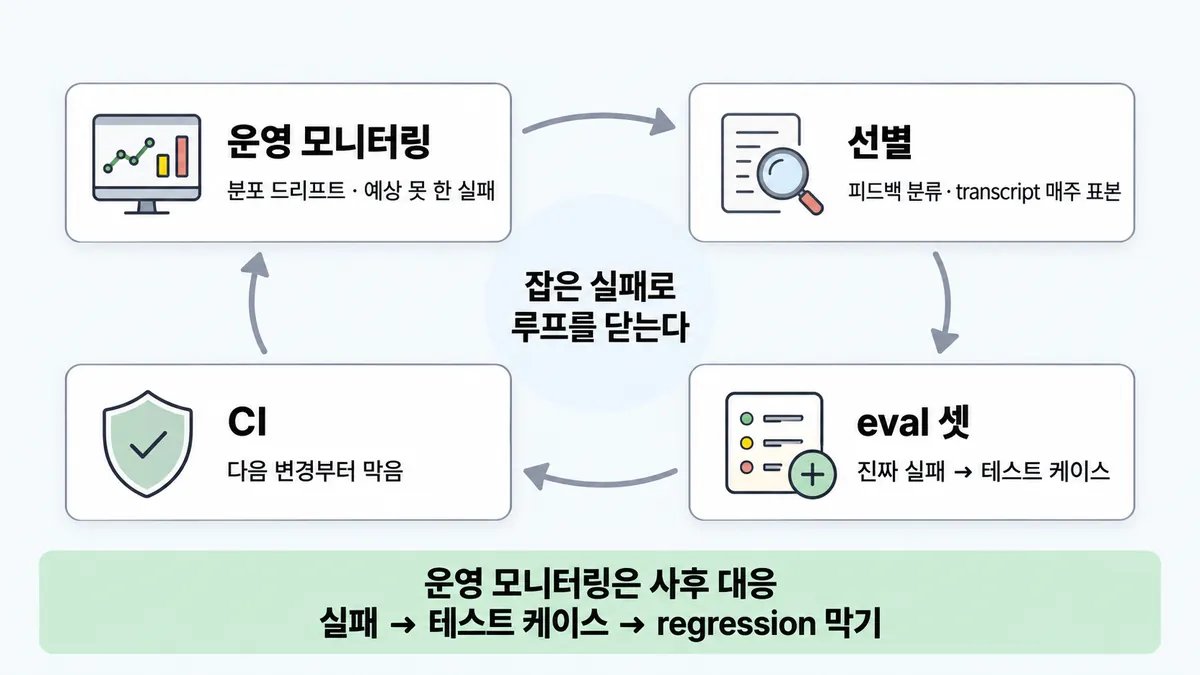
출시 뒤 운영(production) 모니터링은 분포가 바뀌거나(distribution drift) 예상 못 한 실제 실패를 잡는 층이다. 단 사후 대응이다. 사용자가 먼저 겪는다
그래서 잡은 실패를 그대로 두지 않고 루프를 닫는다
- 피드백은 계속 분류한다. transcript 는 매주 일부를 뽑아 읽는다
- 실패 한 건마다 transcript 로 "에이전트가 진짜 틀렸나, grader(채점기)가 맞는 답을 거절했나" 를 가려낸다
- 진짜 실패는 테스트 케이스로 eval 셋에 넣는다
- 다음 변경부터 CI 에서 막는다
"실패가 테스트 케이스가 되고, 테스트 케이스가 regression(회귀)을 막는다"
비유 SLO 위반이 나면 포스트모템을 쓴다. 액션 아이템은 회의록에만 두지 않는다. regression 테스트와 알림 규칙으로 추가한다
ELI5
받아쓰기 시험을 떠올려 보세요.
- 학교 시험지는 늘 같은 단어만 나와서 매번 100점이에요.
- 그런데 밖에서 새 단어를 만나면 자꾸 틀려요.
- 틀린 단어를 오답 노트에 적고, 다음 시험지에 넣어요.
- 그러면 같은 단어는 다시 안 틀려요. 이 쪽은 "그 노트를 언제 어떻게 쓰나"를 모아 둔 곳이에요.
개념 설명
원리
운영(production) 모니터링은 입구다. 끝이 아니다
- 오프라인 eval 은 가진 과제만 측정한다. 운영에 새 유형이 들어오면 eval 셋은 그것을 모른다.
- 운영 모니터링은 실제 사용을 보므로 그 빈틈을 잡는다. 대신 약점이 셋 있다.
- 사후 대응이다(사용자가 먼저 겪는다)
- 신호에 잡음이 많다
- 채점할 정답이 없다
- 그래서 잡은 실패를 eval 과제로 바꿔야 다음부터 출시 전에 막힌다.
실패 판정이 먼저다
- eval 이 "실패" 라고 해도 grader(채점기)가 맞는 답을 거절했을 수 있다. transcript 를 읽어 가려낸다.
- 에이전트 실수면 과제로 넣고 에이전트를 고친다. grader 오판이면 grader 를 고친다.
드리프트는 입력 쪽이다
- 공식 글의 drift 는 입력 분포가 바뀐다는 뜻이다. 모델 ID 는 고정 스냅숏이라 같은 ID 의 가중치·구성은 안 바뀐다.
- 같은 ID 에서 작은 동작 차이가 보이면 가장 유력한 원인은 서빙 인프라다(라우터 · 안전 분류기 · 샘플링).
핵심 질문 두 개
- 이 실패 유형이 지금 eval 셋에 있나?
- 이 실패는 에이전트의 것인가, grader 의 것인가?
규칙과 판단
갈림길
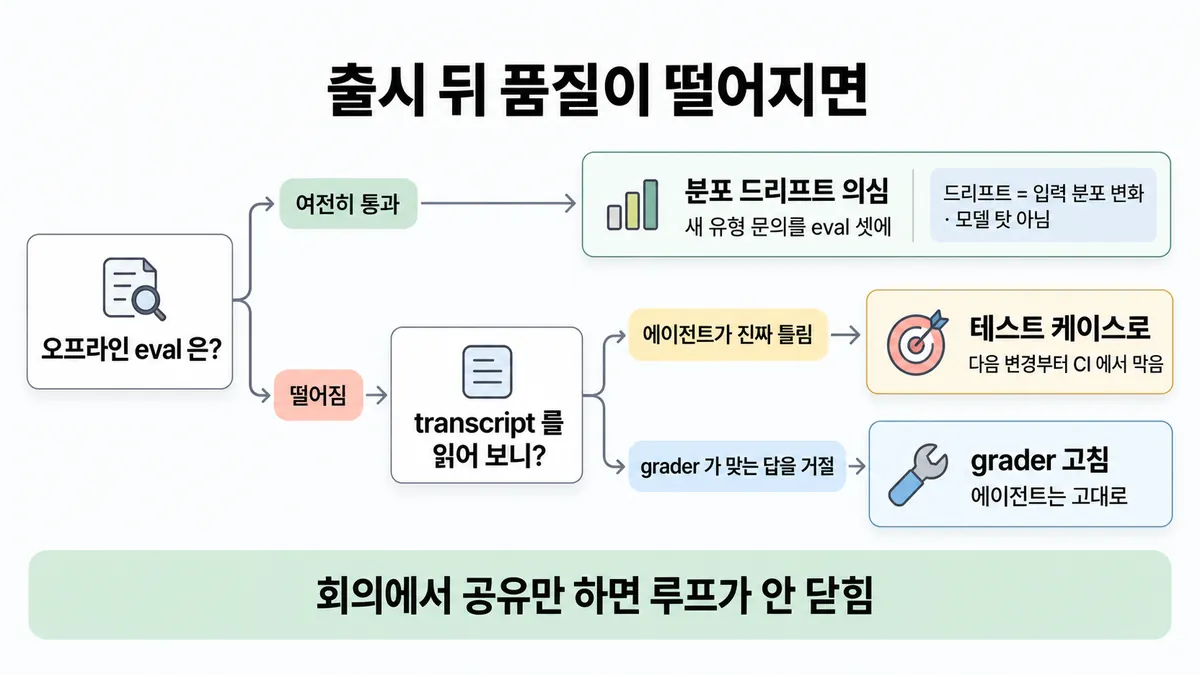
①② 출시 뒤 품질이 떨어질 때 [4.6②]
분포 드리프트
운영 모니터링이 잡는 층이다. 그 유형의 실패를 테스트 케이스로 eval 셋에 넣는다
변경부터
자세한 것은 ■ 변경부터 묻는 진단 에 있다
모델 탓이 아니다
모델 ID 는 고정 스냅숏이다. 같은 ID 의 가중치·구성은 안 바뀐다. 드리프트는 입력 분포가 바뀐다는 뜻이다(새 유형 문의)
다음 물음 — transcript 를 읽어 보니 어떤가?
③ 실패 한 건씩 [4.6②] [6.3②]
테스트 케이스로
진짜 실패는 테스트 케이스로 eval 셋에 넣는다. 다음 변경부터 CI 에서 막는다
grader 를 고친다
에이전트는 그대로 둔다 (■ LLM-as-judge 설계)
④ 어디로 보내나 [6.3②] [6.5①]
루프가 안 닫힌다
eval 셋에 안 들어가면 다음 변경에서 또 새어 나간다 업계 일반
영향 순으로 넣고 CI 로
사용자 보고 실패를 사용자 영향 순으로 테스트 케이스로 바꾼다. 다음 변경부터 CI 에서 막는다. 실패를 들고 온 사람(PM·CS·영업)이 eval 과제를 직접 보태게 한다(PR 로)
요구부터 다시
과제 추가가 아니라 요구부터 다시 본다 업계 일반 목록 6.3② 문장, 공식 원문 미확인
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 운영 → 선별 → eval 셋 → CI
규칙 (eval 셋) : 진짜 실패는 테스트 케이스로 넣는다
질문 : 운영에서 잡은 실패는 어디로 가야 할까?
① 새 실패를 테스트 케이스로 ✓
- 시작 : 운영 — 말 : “소파 배송 날짜를 바꾸고 싶은데 안 된대요.”
- 신고 : 운영 → 선별 : 피드백을 분류하고 transcript 를 매주 뽑는다 — 쪽지 : 이번 주 표본 50개 / 가구 문의 실패 9건
- 판정 : 선별 : transcript 로 가려낸다 — 쪽지 : 에이전트 실수 8건 / grader 오판 1건
- 넣기 : 선별 → eval 셋 : 진짜 실패를 테스트 케이스로 넣는다 — 쪽지 : 가구 과제 +8 · 영향 순 / eval 셋 : 48개
- 막기 : eval 셋 → CI : 다음 변경부터 CI 에서 막는다 — 쪽지 : PR 마다 48개 돌림 / 가구 과제 실패 → 배포 막힘
- 끝 : 실패가 테스트 케이스가 되고, 테스트 케이스가 regression 을 막는다
② 오프라인 통과니 괜찮다 ≠
- 시작 : 운영 — 쪽지 : 문의 비율 / 옷 75% · 가구 25% (신규)
- 통과 : CI : 오프라인 eval 은 여전히 통과한다 — 쪽지 : eval 40개 : 95% / 가구 과제 : 0개
- 드리프트 : 운영 : 입력 분포가 바뀐다 — 쪽지 : 가구 문의 실패 ↑ / 만족도 ↓
- 끝 : eval 셋에 그 유형이 없으면 오프라인 통과는 아무것도 말해 주지 않는다
③ 공유만 하고 끝 ≠
- 시작 : 운영 — 말 : “소파 배송 날짜를 바꾸고 싶은데 안 된대요.”
- 신고 : 운영 → 선별 : 놓친 사례를 회의에서 공유한다 — 쪽지 : 주간 회의 : / "가구 문의 주의해 주세요"
- 건너뜀 : eval 셋
- 다음 변경 : CI : 가구 과제 없이 통과한다 — 쪽지 : PR #230 : 40/40 통과 / 가구 과제 : 0개
- 끝 : eval 셋에 안 들어가면 루프가 안 닫힌다. 다음 변경에서 또 새어 나간다
나머지 규칙
-
사용자 신고만으로 감시하지 않는다. 이유는 넷이다
- 드물고 스스로 나선 사람만 신고한다
- 심한 문제로 쏠린다
- 이유를 잘 말하지 않는다
- 사용자가 문제를 잡게 두면 사용자가 피해를 본다
규칙 원문 ①②③④ (갈림길로 그린 규칙)
-
층의 자리 : 여기서 쓰는 층의 자리는 아래와 같다 (층 표 전체 = ■ 검증 층) [4.6②]
- 자동 eval : 출시 전과 CI 의 첫 방어선이다
- 운영 모니터링 : 출시 뒤 분포 드리프트와 예상 못 한 실패를 잡는다
- 피드백·transcript : 늘 빈틈을 메운다. 피드백은 계속 분류한다. transcript 는 매주 표본을 읽는다. 필요하면 더 깊이 본다
운영 모니터링에는 약점이 셋 있다. 그래서 그 자체로 끝이 아니라 eval 로 되돌리는 입구다
- 사후 대응이다(사용자가 먼저 겪는다)
- 신호에 잡음이 많다
- 채점할 정답이 없다
-
드리프트는 입력 분포가 바뀐다는 뜻이다(새 유형 문의). 모델 ID 는 고정 스냅숏이다. 같은 ID 의 가중치·구성은 안 바뀐다. 같은 ID 에서 작은 동작 차이가 보이면 서빙 인프라 쪽이다 (■ 변경부터 묻는 진단) [4.6②] [6.5②]
-
실패 판정 : 실패한 과제는 transcript 로 가려낸다. 에이전트의 진짜 실수인가? grader 가 맞는 답을 거절했나? 뒤쪽이면 에이전트가 아니라 grader 를 고친다 [4.6②]
-
루프 닫기 : 사용자 보고 실패를 테스트 케이스로 바꾼다. 그러면 suite 가 실제 사용을 반영한다. 사용자 영향 순으로 넣는다. 넣은 뒤에는 변경과 모델 업그레이드마다 CI 에서 자동 eval 을 돌린다 (■ 변경마다 eval 다시) [4.6②] [6.3②] [6.5①]
실패를 들고 온 사람(제품 요구·사용자에 가장 가까운 PM·CS·영업)이 eval 과제를 직접 보태게 한다(PR 로)
통과율이 높아진 capability(능력) 과제는 regression suite 로 옮긴다. 거기서 계속 돌리며 drift 를 잡는다 (◆ capability eval vs regression eval)
증거로 보아 요구 자체가 바뀌었으면 과제 추가가 아니라 요구부터 다시 본다 업계 일반 목록 6.3② 문장, 공식 원문 미확인
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
| 출시 뒤 분포가 바뀌거나 예상 못 한 실패가 난다 | 운영 모니터링이 잡는 층이다 | demystifying-evals "Production monitoring kicks in post-launch to detect distribution drift and unanticipated real-world failures." |
| 운영 모니터링만으로 충분한가? | 아니다. 사후 대응이라 사용자가 먼저 겪는다 | demystifying-evals "Reactive; problems reach users before you know about them" |
| 피드백과 transcript 를 어떻게 운영하나? | 피드백은 계속 분류한다. transcript 는 매주 표본을 읽는다. 필요하면 더 깊이 본다 | demystifying-evals |
| eval 과제가 실패했다 | transcript 로 에이전트 실수인지 grader 오판인지 가린다 | demystifying-evals |
| 사용자가 실패를 보고했다 | 테스트 케이스로 바꾼다. 사용자 영향 순으로 넣는다 | demystifying-evals |
| 과제를 넣은 뒤다 | 변경과 모델 업그레이드마다 CI 에서 자동 eval 을 돌린다 | demystifying-evals |
| PM·CS·영업이 실패를 들고 왔다 | eval 과제를 PR 로 보태게 한다 | demystifying-evals |
| capability(능력) 과제의 통과율이 높아졌다 | regression(회귀) suite 로 옮겨 계속 돌린다 | demystifying-evals |
| "모델이 저절로 바뀌었다" 고 한다 | 같은 ID 의 가중치·구성은 안 바뀐다 | model-ids-and-versions |
| 같은 ID 에서 작은 동작 차이가 보인다 | 서빙 인프라 업데이트가 가장 유력하다 | model-ids-and-versions |
| 사용자 신고를 주 감시 수단으로 쓰려 한다 | 아니다. 드물고 스스로 나선 사람만 신고한다 | demystifying-evals |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 오프라인 eval | 통과하는데 운영 불만이 는다 | 분포 드리프트를 의심한다. 새 유형을 과제로 넣는다 | 계산 | 뒤집히는 때 1 |
| 오프라인 eval | 떨어진다 | transcript 로 실패 판정부터 한다 | 판단 규칙 4 | |
| 최근 변경 | 내 쪽이다(프롬프트·모델 ID·검색·문서) | ■ 변경부터 묻는 진단 | 샘플 3 · diagnose-by-change 카드 | |
| 최근 변경 | 없다. 모델 ID 도 그대로다 | 입력 분포나 서빙 인프라를 본다 | 판단 규칙 9·10 | |
| 새 실패 수 | 많다 | 사용자 영향 순으로 넣는다 | 판단 규칙 5 | |
| 받은 피드백의 모양 | 회의 공유·주의 당부 | 루프가 안 닫힌다. 과제로 넣는다 | 업계 일반 | 목록 6.3② |
| 트래픽 | 적다 | A/B 말고 transcript·피드백·자동 eval 을 쓴다 | 업계 일반 | ■ 검증 층 |
| 사용자 신고 | 0 건 | 안전하다는 뜻이 아니다 | 판단 규칙 11 |
연습 문제
고객지원 Agent 의 오프라인 eval 40개는 여전히 95% 통과오프라인 통과인데 운영 만족도가 떨어졌다. 지난달 가구 상품군을 새로 열어 그 문의가 25% 가 됐다새 문의. 프롬프트·모델 ID 는 그대로다. 팀원은 모델이 저절로 드리프트했으니 모델을 바꾸자고 한다. 무엇을 할까?
시험 대비
함정
- "오프라인 eval 을 통과했으니 문제없다" 는 함정이다. eval 셋에 없는 유형이면 통과는 아무것도 말해 주지 않는다. 그 유형은 운영 모니터링이 잡는다
- "사용자 신고로만 감시한다" 는 함정이다. 드물고 스스로 나선 사람만 신고한다
- "모델이 저절로 드리프트했으니 모델을 바꾼다" 는 함정이다. 모델 ID 는 고정 스냅숏이다
- eval 점수가 떨어지자 transcript 를 안 읽고 에이전트를 고치는 것은 함정이다. grader 가 맞는 답을 거절했을 수 있다
- 놓친 사례를 회의에서 공유하고 끝내는 것은 함정이다. eval 셋에 안 들어가면 루프가 안 닫힌다 업계 일반
- "운영 대시보드가 초록이니 품질 OK" 는 함정이다. 운영 모니터링에는 채점할 정답이 없다
- "online LLM judge 가 공식 처방이다" 는 함정이다. 공식 본문에는 없다. 부록의 외부 도구 소개에만 나온다
신호
"Production monitoring kicks in post-launch to detect distribution drift and unanticipated real-world failures."
"triage feedback constantly, sample transcripts to read weekly, and dig deeper as needed."
"When a task fails, the transcript tells you whether the agent made a genuine mistake or whether your graders rejected a valid solution."
"Converting user-reported failures into test cases ensures your suite reflects actual usage"
"development accelerates as failures become test cases, test cases prevent regressions, and metrics replace guesswork."
"Reactive; problems reach users before you know about them"
"Anthropic does not update the weights or configuration of an existing model ID."
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
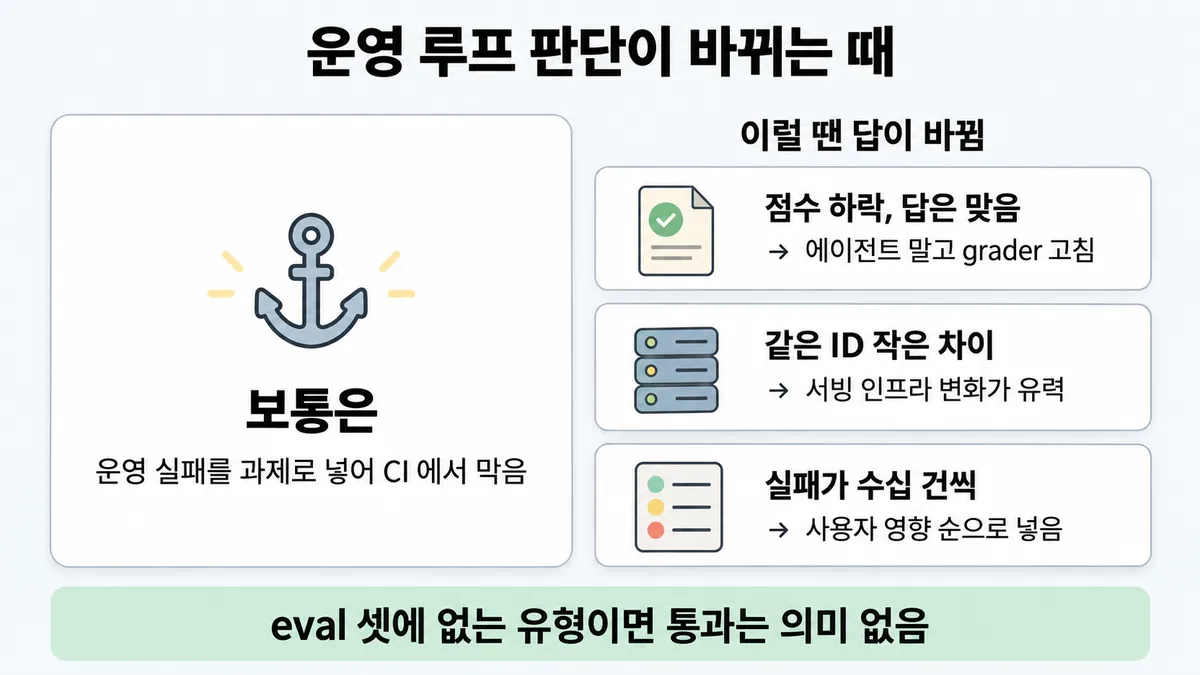
1. "오프라인 eval 통과 = 품질 OK" 가 틀리는 때 — 분포가 바뀜
- 조건 : eval 셋 40개는 전부 기존 상품군 문의이고 통과율은 95% 다. 새 상품군을 출시해 운영 문의의 25% 가 새 상품군이 됐다. 새 상품군 성공률은 60% 라고 가정한다.
- 계산 :
- 오프라인 = 여전히 95% (셋에 새 상품군이 0개)
- 운영 실제 = 0.75 × 95% + 0.25 × 60% = 71.25% + 15% = 86.25%
- 새 상품군 과제 10개를 넣은 뒤 오프라인 = (40 × 0.95 + 10 × 0.6) ÷ 50 = (38 + 6) ÷ 50 = 88%. 이제 셋이 문제를 보여 준다.
- 판단 : 운영 모니터링과 피드백으로 잡은 새 유형을 과제로 넣어야 오프라인 점수가 현실을 따라간다. 과제 개수 비율은 운영 비율과 같을 필요는 없다(업계 일반).
- 전제 : 성공률 60% 와 비율 25% 는 가정이다.
- 등급 : 계산 (층의 역할은 확인)
- 근거 : demystifying-evals
2. eval 점수가 떨어졌는데 에이전트는 맞은 때 — grader 오판
- 조건 : 문구 일치로 채점하는 과제가 "환불 기한 14일" 만 정답으로 받는다. 새 프롬프트 뒤 에이전트가 "2주 안에 환불" 로 답해 실패 처리가 늘었다.
- 판단 : transcript 를 읽으면 답은 맞다. 그래서 에이전트가 아니라 grader 를 고친다(■ grader 고르기 · ■ LLM-as-judge 설계). 점수만 보고 프롬프트를 되돌리면 좋은 변경을 버린다.
- 등급 : (transcript 로 가려낸다) · 예시는 설명용이다
- 근거 : demystifying-evals
3. "모델 ID 그대로니 모델 쪽은 볼 것 없음" 이 약간 틀리는 때
- 조건 : 프롬프트·검색·문서를 아무것도 안 바꿨다. 그런데 같은 모델 ID 에서 답 모양이 조금 달라졌다.
- 판단 : 가중치·구성이 고정인 것은 맞다. 다만 서빙 인프라(요청 라우터 · 안전 분류기 · 샘플링 로직)는 바뀔 수 있다. 안정적이던 ID 에서 뜻밖의 작은 차이가 보이면 그것이 가장 유력한 원인이다. "가중치가 몰래 바뀜" 은 여전히 오답이다. 대응은 같다. 그 사례를 과제로 넣어 regression 으로 지킨다.
- 근거 : model-ids-and-versions
4. 들어온 실패를 전부 과제로 넣을 수 없는 때
- 조건 : 월간 검토에서 실패 사례가 수십 건씩 온다.
- 판단 : 사용자 영향 순으로 넣는다. 처음에는 실제 실패에서 뽑은 20~50개로도 충분히 시작한다(■ 첫 eval 셋 만들기). 과제가 늘어 통과율이 높아진 과제는 regression suite 로 이관한다.
- 근거 : demystifying-evals
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "오프라인 eval 이 통과했으니 문제없다" | 숫자가 초록이다 | 셋에 없는 유형은 측정하지 못한다. 운영이 잡는 층이다 | demystifying-evals · 뒤집히는 때 1 | |
| "사용자 신고로만 감시" | 실제 사용자 목소리다 | 드물고 스스로 나선 사람만 신고한다. 심한 문제로 쏠린다. 사용자가 문제를 잡게 두면 사용자가 피해를 본다 | demystifying-evals | |
| "모델이 저절로 드리프트했으니 모델 교체" | 영상이 "모델 동작이 드리프트" 라고 가르쳤다 | 같은 ID 의 가중치·구성은 안 바뀐다. 드리프트는 입력 분포 쪽이다 | model-ids-and-versions | |
| "주간 회의에서 공유하고 담당자에게 주의 당부" | 할 일을 한 것처럼 보인다 | eval 셋에 안 들어가면 다음 변경에서 또 새어 나간다 | 업계 일반 | 목록 6.3② "매력적인 오답" |
| "놓친 사례가 나왔으니 더 큰 모델로" | 능력 부족으로 보인다 | 과제로 넣고 원인부터 본다. 모델 교체는 증거를 본 뒤에 한다 | 업계 일반 | 목록 6.3② "매력적인 오답" |
| "eval 점수가 떨어졌으니 바로 롤백" | regression 은 되돌리기라고 생각한다 | transcript 로 grader 오판인지 먼저 본다 | demystifying-evals | |
| "운영 대시보드가 초록이면 품질 OK" | 오류율이 0 이다 | 운영 모니터링에는 채점할 정답이 없다. 모델의 거절도 HTTP 200 으로 온다 (■ stop_reason 으로 분기) | demystifying-evals | |
| "online LLM judge 를 켜는 게 공식 처방" | 영상이 그렇게 말했다 | 공식 본문에는 없다. 부록의 외부 도구 소개에만 나온다 | demystifying-evals |
참고
함께 보기
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 4.6 공식 시험 가이드 v1.0
- demystifying-evals
- model-ids-and-versions
상태
- 업계 일반 2줄(공유만 하고 끝 · 요구 변화면 요구부터)
미해결
- 목록 4.6② "새 실패는 테스트 케이스로 eval 셋에 넣어 다음 변경부터 CI 에서 막는다" 를 한 문장으로 말한 원문은 없다. 225줄(사용자 보고 실패를 테스트 케이스로)과 302줄(자동 eval 은 CI 에서 변경마다)을 이은 것이다.
- 목록 6.3② "증거가 요구 자체의 변화를 보여 주면 디스커버리로 되돌아간다" 는 받은 원문에서 못 찾았다. demystifying-evals 에서 "requirement" 를 검색했다. 211·221·277·281줄은 다른 뜻이었다. 카드에는 업계 일반으로 두었다.
- transcript "매주 표본" 의 표본 크기와 피드백 분류 기준은 공식 숫자가 없다.
- 이 글(anthropic.com/engineering)은 한국어판이 없다. 그래서 영어 원문만 대조했다.