■ 모델별 thinking 제어
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 2.3 프롬프트 기법 · D2 모델·프롬프트 13%Apply prompt engineering techniques (zero-shot, few-shot, chain-of-thought)
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 2.3③ 사고 깊이·비용을 제한하라 — budget_tokens 인가 effort 인가? — 문항의 모델 이름을 보고 사고 제어 방식 고르기
- 2.3② 여러 단계 추론이 필요하다 — "step by step" 문구? thinking? 체이닝? — CoT(한 요청 안에서 사고) vs 프롬프트 체이닝(여러 호출로 쪼개기)
- 2.5② 캐싱을 켰는데 cache_read_input_tokens 가 계속 0 — 가장 먼저 의심할 곳은? — 캐시 미적중 원인 진단 순서
한눈에
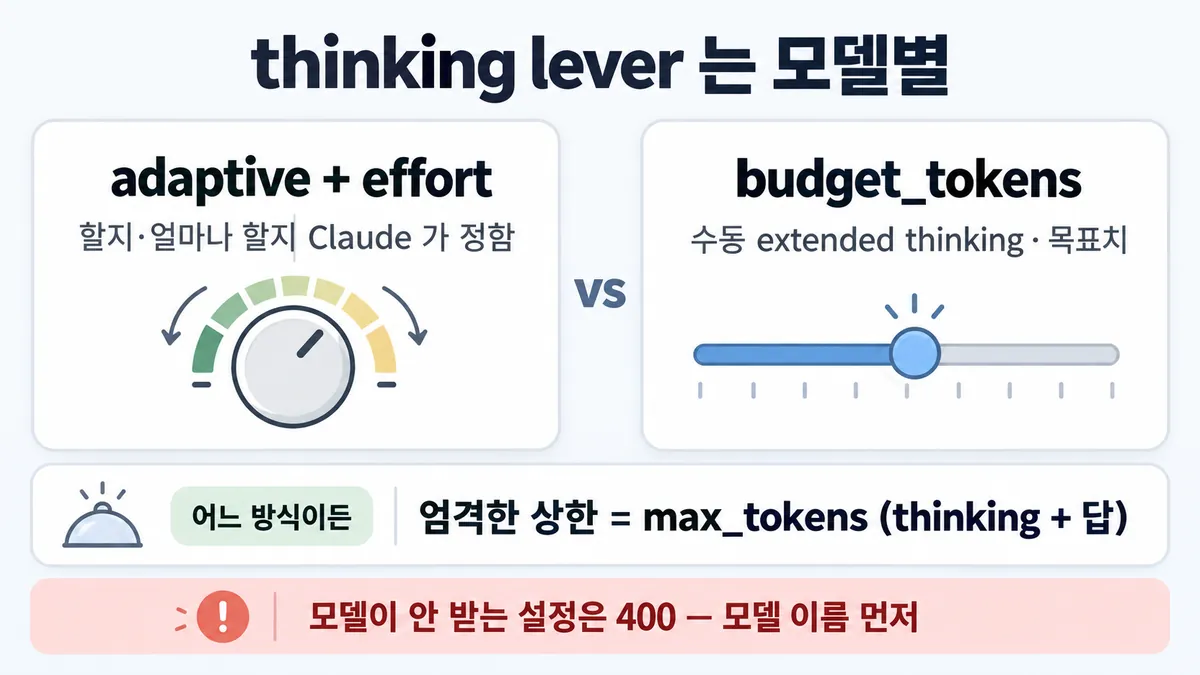
thinking(사고) lever(조절 수단)는 모델마다 다르다. 그래서 문항의 모델 이름을 먼저 본다. 방식은 둘이다.
- 새 방식 :
thinking: {type: "adaptive"}+output_config.effort. Claude 가 thinking 할지, 얼마나 할지 정한다. - 옛 방식 :
thinking: {type: "enabled", budget_tokens: N}. 수동 extended thinking 이다.
모델이 안 받는 설정은 400 이다
지출의 엄격한 상한은 어느 방식이든 max_tokens(thinking + 답 합계)다. effort 는 유연한 지침이고, budget_tokens 는 목표치다
비유 Kubernetes apiVersion 과 같다. 버전마다 받는 필드가 다르다. 그래서 매니페스트에 적힌 버전의 스펙으로 판단한다. 그 버전에 없는 필드를 넣으면 API 서버가 거부한다
ELI5
자동차마다 속도 조절 장치가 달라요.
- 옛날 차는 "최대 몇 km 까지"를 손으로 정해요.
- 새 차는 "천천히 / 보통 / 빨리" 버튼만 있어요.
- 옛날 차에 버튼을 찾으면 없고, 새 차에 옛 레버를 끼우면 안 들어가요.
- 그래서 먼저 차 이름표(모델 이름)를 봐요.
- 어느 차든 연료통 크기(
max_tokens)가 진짜 끝이에요.
개념 설명
원리
두 방식
- 옛 방식은 수동 extended thinking(확장 사고)
thinking: {type: "enabled", budget_tokens: N}이다. 사람이 thinking 예산을 정한다. 고정 예산이면 매 요청 thinking 한다. - 새 방식은
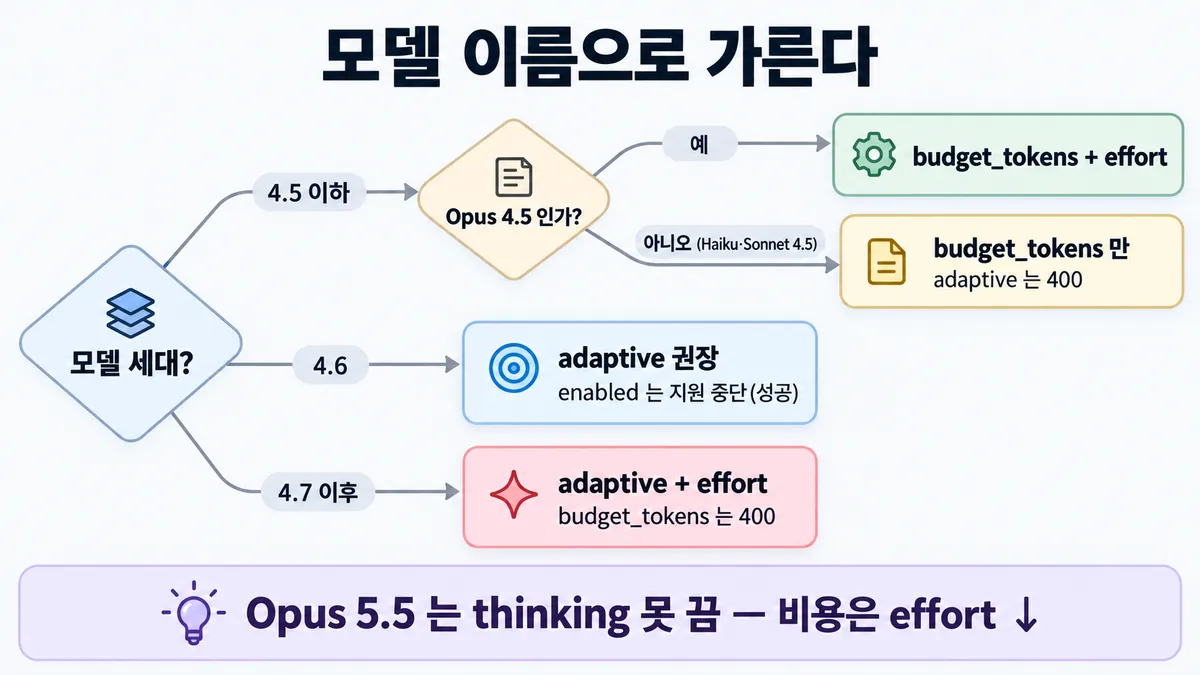
thinking: {type: "adaptive"}+output_config.effort다. 모델이 요청마다 thinking 할지, 얼마나 할지 정한다. effort 는 그 성향을 미는 유연한 지침이다. - 세대 경계는 아래와 같다. 안 받는 쪽을 보내면 400 이다.
- 4.5 이하 : 옛 방식만 받는다.
- 4.6 : 둘 다 받는다(옛 방식은 지원 중단).
- 4.7 이후 : 새 방식만 받는다.
effort 가 하는 일
- effort 는 thinking 만이 아니라 답 글과 도구 호출까지 모든 출력 토큰에 걸린다. 그래서 thinking 이 꺼져도 작동한다.
- 단 effort 가 thinking 깊이의 주 lever(조절 수단)인 것은 adaptive 모드에서만이다. extended thinking 전용 모델에서 effort 를 바꿔도 thinking 은 그대로다. 그 모델들은 대부분 effort 자체가 없다(Opus 4.5 만 예외다).
상한은 하나뿐
max_tokens는 thinking + 답 합계의 엄격한 한도다. 이 한도를 넘어서 생성하지 않는다.- budget_tokens 는 목표치다(예산보다 훨씬 일찍 멈출 수 있다). effort 는 토큰 수를 보장하지 않는다.
- 도구 루프는 요청마다
max_tokens가 따로라서 턴 전체는 못 묶는다.
설정은 프롬프트의 일부
- thinking 모드, budget_tokens, effort 값은 프롬프트 안에 렌더링된다. 그래서 바꾸면 캐시 앞부분이 달라져 메시지 캐시가 깨진다.
핵심 질문 두 개
- 문항의 모델은 어느 세대인가? (받는 필드가 정해진다)
- 원하는 것이 엄격한 상한인가, 평균을 낮추는 것인가, 깊이를 올리는 것인가?
규칙과 판단
갈림길
①②③ 모델로 가르기 [2.3③]
budget_tokens + effort
이 모델은 effort 를 지원하는 유일한 extended thinking 전용 모델이다
budget_tokens 만
extended thinking 이 유일한 모드다. adaptive 는 400 이다. effort 는 없다
adaptive 권장
enabled·budget_tokens 는 지원 중단이다(요청은 성공한다)
adaptive + effort
enabled(budget_tokens) 는 400 이다
① 끌 수 있나 [2.3③] [2.3②]
못 끈다
항상 켜져 있다. disabled 는 400 이다
effort high 이하만 끌 수 있다
기본은 켜져 있다. disabled + effort xhigh·max 는 400 이다
끌 수 있다
기본은 켜져 있다
기본은 꺼져 있다
adaptive 를 넣어야 켜진다
기본은 꺼져 있다
enabled 만 받는다. 기본은 꺼져 있다. adaptive 는 400 이다
④ 무엇으로 묶나 [2.3③] [4.5]
max_tokens
thinking + 답 합계의 엄격한 한도다
effort ↓
thinking 을 포함한 전체 응답이 줄어든다
stop_reason: "max_tokens" 로 잘렸다
max_tokens ↑
추론(reasoning)이 필요했으면 max_tokens 를 올린다
effort ↓
과하게 생각했으면 effort 를 낮춘다
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 요청 → API 검사 → 모델
규칙 (API 검사) : 모델이 안 받는 설정은 400
질문 : 이 설정은 검사를 통과할까?
① Haiku 4.5 + budget_tokens ✓
- 시작 : 요청 — 쪽지 : model: Haiku 4.5 / type: "enabled" / budget_tokens: 2048 / max_tokens: 4096
- 요청 : 요청 → API 검사 :
enabled+ budget_tokens — 쪽지 : Haiku 4.5 = enabled 만 / 통과 - 통과 : API 검사 → 모델 : extended thinking 만 되는 모델이다 — 쪽지 : [thinking] 배송 지연 언급 / 답: 라벨 "배송"
- 끝 : 4.5 이하는 extended thinking 이 유일한 모드다
② Opus 5.5 + budget_tokens ≠
- 시작 : 요청 — 쪽지 : model: Opus 5.5 / type: "enabled" / budget_tokens: 2048
- 요청 : 요청 → API 검사 :
enabled+ budget_tokens — 쪽지 : Opus 5.5 = adaptive 만 - 거부 : API 검사 : 400 ≠ — 쪽지 : HTTP 400
- 건너뜀 : 모델
- 끝 : 4.7 이후는 adaptive + effort 를 쓴다
③ Haiku 4.5 + adaptive ≠
- 시작 : 요청 — 쪽지 : model: Haiku 4.5 / type: "adaptive"
- 요청 : 요청 → API 검사 :
adaptive— 쪽지 : Haiku 4.5 = enabled 만 - 거부 : API 검사 : 400 ≠ — 쪽지 : HTTP 400
- 건너뜀 : 모델
- 끝 : extended thinking 만 되는 모델은 adaptive 에 400 을 낸다
나머지 규칙
-
바꾸면 캐시가 깨진다 : 아래를 바꾸면 메시지 캐시가 무효가 된다. 그래서 대화 안에서는 고정한다
- thinking 모드 전환
- budget_tokens 변경
- 요청 단위(top-level) effort 변경
기본값을 명시하는 것은 생략과 같아 캐시가 깨지지 않는다
메시지별 effort(베타, Fable 5.1·Mythos 5.1·Opus 5.5·Opus 5)는 캐시를 유지한다 시험 뒤 변경 2026-09-01~. 상세는 ■ 프롬프트 캐싱 에 있다
-
thinking 과 같이 걸리는 그 밖의 400
새 모델(Fable·Mythos · Opus 5.5·5·4.8·4.7 · Sonnet 5)은 temperature·top_p·top_k 를 기본값 아닌 값으로 주면 thinking 과 무관하게 400 이다
수동 extended thinking 과 강제 도구 사용(
tool_choiceany·tool)을 같이 쓰면 오류다. Opus 5.5·Fable 5.1 은 강제 도구 사용 자체가 400 이다. 대신 auto 와 strict tool use 를 쓴다thinking 을 켠 채로는 prefill 을 못 한다
도구 결과를 보낼 때 thinking 블록을 고치거나 빼면 400 이다. 받은 그대로 돌려준다
규칙 원문 ①②③④ (갈림길로 그린 규칙)
-
모델별 thinking 방식은 아래 표와 같다 (2026-09-28 조회) [2.3③]
모델 thinking 방식 기본 400 Fable 5.1 · Fable 5 adaptive 만 항상 켜져 있다 enabled·disabledOpus 5.5 adaptive 만 항상 켜져 있다 enabled·disabledOpus 5 adaptive 만 켜져 있다 enabled· (disabled+ effort xhigh·max)Sonnet 5 adaptive 만 켜져 있다 enabledOpus 4.8 · 4.7 adaptive 만 꺼져 있다 enabledOpus 4.6 · Sonnet 4.6 adaptive · enabled(지원 중단) 꺼져 있다 없다 Opus 4.5 · Haiku 4.5 · Sonnet 4.5 enabled 만 꺼져 있다 adaptive끄기는 모델마다 다르다
- 항상 켜진 모델은 못 끈다
- Opus 5 는 effort high 이하에서만
disabled를 쓸 수 있다 - Sonnet 5 는 기본이 켜져 있지만
disabled로 끌 수 있다 - 기본이 꺼진 모델은
adaptive를 넣어야 켜진다
Mythos 5.1·5 는 Fable 과 같다. Mythos Preview 는 두 모드를 다 받는다(
disabled만 400 이다)시험 뒤 변경 Opus 5 는 2026-07-24, Fable 5.1 은 2026-09-01, Opus 5.5 는 2026-09-22 에 출시됐다. 규칙 "4.7 이후 = budget_tokens 400"은 그대로다
-
effort :
output_config.effort에 넣는다(thinking 객체 안이 아니다). 단계는 low · medium · high · xhigh · max 다기본은 high 이고, Opus 5.5 만 medium 이다 (2026-09-28 조회 · 시험 뒤 변경 — Opus 5.5 2026-09-22 출시)
effort 는 모든 출력 토큰(답 · 도구 호출 · thinking)에 걸린다. 그래서 thinking 이 꺼져도 작동한다. effort 가 thinking 의 주 lever 인 것은 adaptive 모드에서만이다. extended thinking 전용 모델은 budget_tokens 가 깊이를 정한다
지원 단계는 모델마다 다르다 (2026-09-28 조회)
max지원 모델 : Fable·Mythos 계열 · Opus 5.5·5·4.8·4.7·4.6 · Sonnet 5·4.6xhigh지원 모델 : Fable·Mythos 5.x·5 · Opus 5.5·5·4.8·4.7 · Sonnet 5 (4.6 은 xhigh 가 없다)
adaptive는 effort 값이 아니다(thinking 모드다)Opus 4.5 는 effort 를 지원하는 유일한 extended thinking 전용 모델이다. 그래서 Haiku 4.5·Sonnet 4.5 에는 effort 가 없다 (문장의 '유일한'에서)
effort 를 모델 교체와 비교하는 판단은 ◆ effort 조정 vs 모델 교체 에 있다. 지연(latency) 쪽은 ■ 지연 줄이기 lever 에 있다
-
budget_tokens (수동 extended thinking)
최소값은 1,024 다.
max_tokens보다 작게 잡는다(interleaved thinking 은 예외). budget_tokens 는 목표치이지 엄격한 상한이 아니다. 엄격한 상한은max_tokens다시작점은 단순한 일이면 1,024 근처, 복잡한 일이면 16,000 이상이다. 32k 넘는 예산은 배치 처리로 돌린다
예측 가능한 지연이나 thinking 비용의 정밀 제어가 필요하면 수동 모드가 여전히 유용하다
고정 예산이면 매 요청 thinking 한다. adaptive 는 요청마다 thinking 할지 정한다(낮은 effort 면 쉬운 입력은 건너뛴다)
Haiku 4.5 에는 interleaved thinking(도구 호출 사이 thinking)이 없다
-
비용 묶기 [2.3③] [4.5]
max_tokens는 thinking + 답 합계의 엄격한 한도다. effort 는 유연한 지침이다(토큰 수를 보장하지 않는다)평균 비용과 지연을 줄이려면 effort 를 먼저 낮춘다. 그러면 thinking 을 포함한 전체 응답이 줄어든다
도구 루프는 요청마다
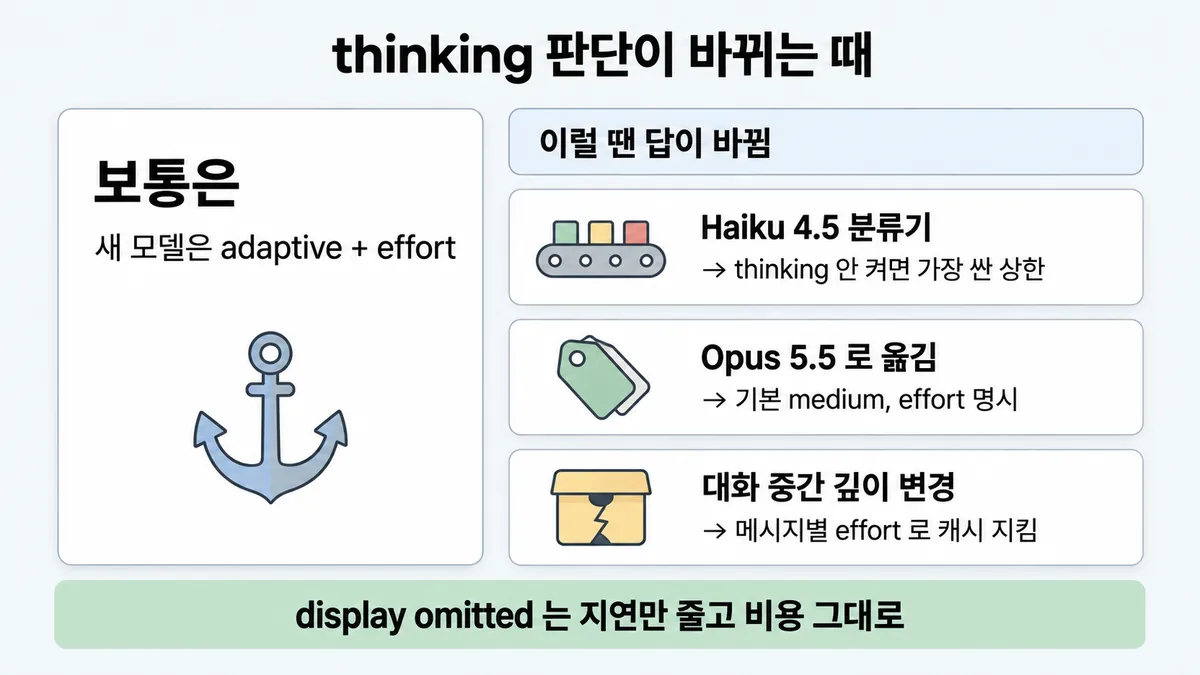
max_tokens가 따로 있다. 그래서 턴 전체 지출은 못 묶는다thinking 토큰은 출력 토큰 단가로 청구된다. display "omitted" 로 숨겨도 똑같이 청구된다. 숨기면 지연만 줄어든다
실제 thinking 양은
usage.output_tokens_details.thinking_tokens에 있다stop_reason: "max_tokens"로 잘리면 이렇게 한다. 추론이 필요했으면 max_tokens 를 올린다. 과하게 생각했으면 effort 를 낮춘다
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
| 4.7 이후 모델(Opus 4.7~5.5 · Sonnet 5 · Fable)이다 | adaptive + effort 를 쓴다. budget_tokens 는 400 이다 | prompting-best-practices "On Claude 4.7 and later models, setting budget_ returns a 400 error." · thinking-troubleshooting |
| Haiku 4.5 · Sonnet 4.5 다 | budget_tokens 만 쓴다. adaptive 는 400 이다. effort 는 없다 | thinking-troubleshooting · extended-thinking |
| Opus 4.5 다 | budget_tokens 와 effort 를 둘 다 설정한다 | extended-thinking · effort en-2026-09-28 |
| Opus 4.6 · Sonnet 4.6 이다 | adaptive 를 권장한다. budget_tokens 는 지원 중단이지만 요청은 성공한다 | thinking-troubleshooting |
| Fable 5.1 · Fable 5 · Opus 5.5 에서 thinking 을 끄려 한다 | 못 끈다(disabled 400). effort 를 낮춘다 | thinking · effort en-2026-09-28 |
Opus 5 에서 xhigh·max 와 disabled 를 같이 쓴다 | 400 이다. effort 를 high 이하로 내리거나 thinking 을 켜 둔다 | thinking-troubleshooting |
| 지출의 엄격한 상한이 필요하다 | max_ 를 쓴다 | thinking "Effort is soft guidance. max_ is a strict limit." |
| 평균 비용·지연(latency)을 줄인다 | effort 를 먼저 낮춘다 | thinking |
stop_ 로 잘렸다 | 추론(reasoning)이 필요했으면 max_tokens 를 올린다. 과하게 생각했으면 effort 를 낮춘다 | thinking-steering-and-cost |
| 캐시를 쓰는 대화 중간에 깊이를 바꾸고 싶다 | 요청 단위(top-level) effort 는 고정한다. 되는 모델이면 메시지별 effort(베타)를 쓴다 | effort en-2026-09-28 · thinking |
| thinking 예산이 32k 를 넘는다 | 배치 처리로 돌린다 | extended-thinking · thinking |
상황 변수
| 변수 | 값 | 답 쪽 | 근거 |
|---|---|---|---|
| 모델 세대 | 4.5 이하 | budget_tokens 를 쓴다 (Opus 4.5 만 effort 도 쓴다) | 판단 규칙 2·3 |
| 모델 세대 | 4.6 | adaptive 를 권장한다. 옛 방식도 동작한다 | 판단 규칙 4 |
| 모델 세대 | 4.7 이후 | adaptive + effort 를 쓴다 | 판단 규칙 1 |
| effort 생략 | Opus 5.5 | medium 으로 실행된다 (다른 모델은 high) | effort en-2026-09-28 |
| 목적 | 엄격한 상한 | max_tokens | 판단 규칙 7 |
| 목적 | 평균 비용 ↓ | effort 를 낮춘다. 4.5 이하는 budget_tokens 를 낮춘다 | thinking · thinking-troubleshooting |
| 목적 | thinking 이 너무 드물거나 얕다 | effort 를 올리거나 프롬프트로 유도한다 | thinking |
| 대화 캐시 | 사용 중이다 | thinking 설정과 effort 를 고정한다 | thinking-troubleshooting |
| 도구 루프 | 강제 도구 사용이 필요하다 | 수동 extended thinking 과는 안 된다. Opus 5.5·Fable 5.1 은 강제 자체가 400 이다. auto + strict tool use 를 쓴다 | thinking |
| 도구 루프 | 도구 결과 사이에 thinking 이 필요하다 | adaptive 면 자동이다. Haiku 4.5 에는 interleaved thinking 이 없다 | thinking · extended-thinking |
| 샘플링 값 | temperature·top_p·top_k 를 바꾼다 | 새 모델은 thinking 과 무관하게 400 이다 | thinking |
연습 문제
Haiku 4.5Haiku 4.5 로 도는 티켓 분류기에 thinking 을 켜려 한다. 팀원은 "budget_tokens 는 낡았으니 adaptive + effort 로"새 방식 쓰자고 한다. 어떤 설정이어야 요청이 통할까?
시험 대비
함정
- "budget_tokens 는 낡았으니 무조건 adaptive + effort 로" 는 함정이다. Haiku 4.5·Sonnet 4.5·Opus 4.5 는 adaptive 가 400 이다. 모델 이름을 먼저 본다
- "budget_tokens 보기는 무조건 지운다" 는 함정이다. 4.6 은 지원 중단이지만 요청은 성공한다. 4.5 이하는 유일한 모드다
- "budget_tokens = thinking 비용의 엄격한 상한" 은 함정이다. budget_tokens 는 목표치다. 엄격한 상한은 max_tokens 다
- "Haiku 4.5 에서 effort 로 thinking 을 줄인다" 는 함정이다. effort 는 Opus 4.5 만 받는다. Haiku 4.5 는 budget_tokens 를 쓴다
- "effort 는 thinking 전용이라 thinking 을 끄면 소용없다" 는 함정이다. effort 는 모든 출력 토큰에 걸린다
- "effort 에 adaptive 를 넣는다" 는 함정이다. adaptive 는 thinking 모드다
- "Opus 5.5 에서 thinking 을 꺼서 비용을 줄인다" 는 함정이다. 못 끈다(400). effort 를 낮춘다
- "effort 를 안 주면 어디서나 high" 는 함정이다. Opus 5.5 는 medium 이다 시험 뒤 변경
- "display omitted 로 숨기면 thinking 비용도 준다" 는 함정이다. 지연만 줄고 비용은 그대로다
- Skilljar(2025 제작)의 "thinking budget = thinking 에 쓸 최대 토큰" 과 코드 키
budget은 함정이다. 지금 docs 는budget_tokens를 쓰고, 목표치이지 엄격한 상한이 아니다 (Skilljar)
신호
"On Claude 4.7 and later models, setting budget_tokens returns a 400 error."
"On Claude 4.5 and earlier models that support thinking, extended thinking is the only available thinking mode."
"Extended thinking (thinking.type: \"enabled\" with budget_tokens) is deprecated on the Claude 4.6 models (requests using it still succeed)."
"effort is the primary thinking lever only in adaptive mode."
"Effort is soft guidance. max_tokens is a strict limit."
"The budget is a target rather than a strict cap."
"Most Claude models default to high effort, spending as many tokens as needed for excellent results; Claude Opus 5.5 defaults to medium."
"Manual mode remains useful when your workload requires predictable latency or precise control over thinking costs."
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
1. Haiku 4.5 대량 분류기의 "thinking 비용 상한" — 켜지 않는 게 가장 싼 상한
- 조건 : Haiku 4.5 로 하루 30만 건을 분류한다. 지문은 thinking 비용에 상한을 걸라고 한다.
- 계산 : Haiku 4.5 출력은 $5 / 백만 토큰이다. thinking 을 켜면 budget_tokens 는 최소 1,024 이고,
max_tokens는 그보다 커야 한다.max_tokens가 1,300 이면 요청당 출력은 최악 1,300 × $5 = $0.0065 다. 하루 최악은 30만 × $0.0065 = $1,950 이다. thinking 없이 라벨만 30 토큰이면 30 × $5 = $0.00015 이고, 하루 $45 다. 배치로 돌리면 출력이 $2.50 이라 둘 다 절반이 된다. - 전제 : 입력 비용은 양쪽이 같다고 보고 뺐다. thinking 을 켠 쪽은 최악(상한까지 씀) 기준이다. 가격은 2026-09-28 조회값이다.
- 판단 : 지문의 답은 "budget_tokens(adaptive·effort 아님) + 엄격한 상한은 max_tokens" 다. 단 Haiku 4.5 는 thinking 이 기본으로 꺼져 있다. 그래서 thinking 없이 eval 을 통과하면 "켜지 않음"이 가장 싸고 확실한 상한이다. 보기에 그것이 있으면 그쪽이 설 자리가 있다.
- 등급 : 계산 (단가·최소값·기본 꺼짐은 확인)
- 근거 : ko-pricing 표 · extended-thinking · thinking-troubleshooting
2. Opus 5 설정을 Opus 5.5 로 그대로 옮긴 때
- 조건 : effort 를 적지 않은 채 Opus 5 에서 Opus 5.5 로 모델 문자열만 바꿨다.
- 판단 : Opus 5 기본은 high 이고 Opus 5.5 기본은 medium 이다. 그래서 한 단계 낮게 실행된다. 복잡한 일에서 품질이 떨어지면 모델 탓이 아니라 기본값 차이일 수 있다. 그러니 자기 eval 로 effort 를 스윕한다. 또
thinking: {type: "disabled"}를 쓰던 코드는 Opus 5.5 에서 모든 effort 에서 400 이다. - 근거 : effort en-2026-09-28
- 시험 뒤 변경 Opus 5.5 = 2026-09-22 출시 (릴리스 노트)
3. 대화 중간에 깊이를 바꾸면 캐시가 깨지는 때
- 조건 : 긴 대화를 캐싱으로 돌리다가 "이번 턴만 더 깊게" 하려고 요청 단위 effort 를 high 에서 max 로 바꾼다.
- 판단 : 요청 단위 effort 는 프롬프트에 렌더링된다. 그래서 메시지 캐시가 전부 미스가 난다. Fable 5.1·Mythos 5.1·Opus 5.5·Opus 5 는 메시지별 effort(
role: "system"메시지, 베타)로 캐시를 지킨다. 그 밖의 모델은 두 길이 있다.- 대화 시작에 effort 를 정하고 고정한다.
- 그 턴의 user 메시지 끝에 "Please think hard before responding." 같은 유도 문구를 넣는다(캐시가 깨지지 않는다).
- 근거 : effort en-2026-09-28 · thinking-steering-and-cost
- 시험 뒤 변경 메시지별 effort 베타 = 2026-09-01~ (릴리스 노트)
4. budget_tokens 가 "엄격한 상한"으로 불리는 문장
- 조건 : 지문이나 보기에 "budget_tokens 로 thinking 비용에 hard cap" 이 있다.
- 판단 : 공식 문서끼리 표현이 다르다. extended-thinking 은 "목표치이지 엄격한 상한이 아니다. 엄격한 상한은 max_tokens 다" 라고 쓴다. prompting-best-practices 는 "hard ceiling on thinking costs …
budget_tokenscap" 이라고 쓴다. 안전한 답은 이렇다. 엄격한 상한은 max_tokens 다. budget_tokens 는 thinking 깊이 lever 다. - 등급 : 미해결 (문서 간 표현 충돌)
- 근거 : extended-thinking · prompting-best-practices
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "budget_tokens 는 제거된 낡은 기법이니 adaptive + effort 로 바꾼다" (Haiku 4.5 문항) | 새 방식이 늘 정답 같다 | Haiku 4.5 는 extended thinking 만 받는다. adaptive 는 400 이다 | thinking-troubleshooting (목록 매력적인 오답) | |
| "budget_tokens 보기는 무조건 지운다" | 영상 요령이다 | 4.6 은 지원 중단이지만 요청은 성공한다. 4.5 이하는 유일한 모드다 | thinking-troubleshooting | |
| "Haiku 4.5 에 effort: low 로 thinking 을 줄인다" | effort 가 새 표준이다 | extended thinking 전용 모델 중 effort 를 받는 것은 Opus 4.5 뿐이다 | thinking-troubleshooting | |
| "Opus 5.5 는 thinking 을 꺼서 비용 절감" | 끄면 0 일 것 같다 | 못 끈다(400). effort 를 낮춘다 | effort en-2026-09-28 | |
| "budget_tokens 로 thinking 비용 엄격 상한" | 이름이 예산이다 | 목표치다. 엄격한 상한은 max_tokens 다 | (문서 간 표현 차 있음) | extended-thinking · 뒤집히는 때 4 |
| "effort: adaptive" | 두 이름이 붙어 다닌다 | adaptive 는 thinking 모드다. effort 값이 아니다 | thinking | |
| "display omitted 로 thinking 비용 절감" | 안 보이면 안 셀 것 같다 | 똑같이 청구된다. 지연만 줄어든다 | thinking | |
| "effort 를 낮추면 max_tokens 가 없어도 비용이 확실히 묶인다" | 낮추면 상한이 생길 것 같다 | effort 는 토큰 수를 보장하지 않는다 | thinking-steering-and-cost | |
| "도구 루프 전체 비용을 max_tokens 하나로 묶는다" | 한 턴을 한 요청으로 착각한다 | 요청마다 max_tokens 가 따로 있다 | thinking-steering-and-cost |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 2.3 공식 시험 가이드 v1.0
- thinking-troubleshooting
- thinking
- extended-thinking
- effort
- thinking-steering-and-cost
- prompting-best-practices
- 릴리스 노트
- Skilljar API 287773
상태
- Skilljar
- 시험 뒤 변경 3곳(새 모델 3종 출시 · Opus 5.5 기본 medium · 메시지별 effort)
미해결
- budget_tokens 를 "hard ceiling/cap" 으로 부르는 문장(prompting-best-practices)과 "target rather than a strict cap"(extended-thinking)이 충돌한다 (뒤집히는 때 4).
- Opus 4.5 가 받는 effort 단계는 확인하지 못했다. max 목록(effort en-2026-09-28)과 xhigh 목록에 Opus 4.5 가 없다. 그래서 low·medium·high 만으로 추정된다. 그러나 표 끝 "Supported models" 가 접혀 받아지지 않아 못 확인했다(추론).
- 목록 2.3③ 과 대조한 결과는 아래와 같다.
- 모델별 규칙, effort 단계, 기본값(대부분 high · Opus 5.5 medium)은 공식과 같다.
- 다만 목록 문제 상황 "사고 토큰 비용 상한 → budget_tokens" 는 공식 기준으로 고쳤다. 깊이는 budget_tokens 로, 엄격한 상한은 max_tokens 로 정한다.
- 목록 영어 신호 2문장은 원문에서 찾았다(prompting-best-practices · thinking-troubleshooting).
- Skilljar 287773(2025 제작)은 코드 키를
budget로 적었다. "thinking budget = 최대 토큰"이라고도 했다. 지금 docs 는budget_tokens이고, 목표치다.