◆ RAG vs full context
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 2.4 컨텍스트 창과 토큰 관리 · D2 모델·프롬프트 13%Optimize context windows and manage token usage
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 2.4① 지식 문서를 통째로 넣을까, RAG 를 만들까? — 크기 기준으로 통째로+캐싱 vs RAG
- 3.8① 정책 모음이 12만 토큰이고 모든 상담에 재사용된다 — RAG 를 깔까, 통째로 넣을까? — 통째 컨텍스트 + 캐싱 vs RAG
- 6.4③ ADR 에 "100쪽 계약은 context rot 때문에 RAG" 라고 적었다 — 이 근거가 맞나? — ADR 근거를 공식 기준·평가 증거로 적기 (크기 기준부터 확인)
한눈에
ELI5
책 한 권을 통째로 들고 다닐지, 필요한 쪽만 복사해 갈지 고르는 거예요.
- 얇은 책이면 통째로 들고 다니는 게 제일 편해요.
- 너무 두꺼우면 가방에 안 들어가니 복사해 가야 해요.
- 그런데 하루에 수백 번 펼쳐야 하면, 들고 다니는 비용이 쌓여요.
- 이 쪽은 "언제 답이 바뀌나"를 모아 둔 곳이에요.
- 통째로 넣고 캐싱
- 창에 안 들어가면 RAG
개념 설명
원리
full context(문서 전체를 넣기)
- 모델이 문서 전부를 본다. 그래서 검색(retrieval)이 빗나갈 일이 없다.
- 매번 전부 읽는 비용은 캐싱이 흡수한다. 캐시 읽기 단가는 입력 단가의 0.1배다.
- 한계 1 : 컨텍스트 창보다 크면 넣지 못한다.
- 한계 2 : 토큰이 늘수록 정확도와 재현율이 떨어진다(context rot). 컨텍스트는 한정 자원이다.
- 한계 3 : 캐싱해도 호출마다 문서 전체의 10% 만큼은 비용이 든다 (0.1배 × 전체).
RAG
- 문서를 미리 chunk 로 나눠 index(색인)한다. 질문마다 관련 chunk 만 넣는다. 그래서 입력이 작고 싸다. 지식이 커져도 버틴다.
- 한계 1 : 검색이 빗나가면 모델은 틀린 chunk 를 보고 자신 있게 틀린다. 문서 갱신 뒤 답이 이상하면 검색과 indexing 부터 의심한다 (가이드 샘플 3).
- 한계 2 : chunk 만 보면 맥락이 빠진다. 그래서 chunk 앞에 문맥 설명을 붙인다 (Contextual Retrieval).
- 한계 3 : 전처리와 검색 장치를 만들고 돌려야 한다. RAG 는 단순함을 포기하고 확장성을 얻는 trade-off(절충)다.
JIT 검색 (just in time, 필요할 때 가져오기)
- JIT 검색은 RAG 의 에이전트판이다. 에이전트는 가벼운 식별자(파일 경로·쿼리)만 들고 있다. 필요할 때 도구로 내용을 가져온다.
- 섞어 써도 된다. 자주 쓰는 것은 미리 넣는다. 나머지는 필요할 때 가져온다.
핵심 질문 두 개
- 모델이 봐야 하는 것이 문서 전부인가, 일부인가?
- 전부를 매번 읽는 비용(캐싱 뒤)이 일부만 가져오는 비용보다 싼가?
규칙과 판단
갈림길
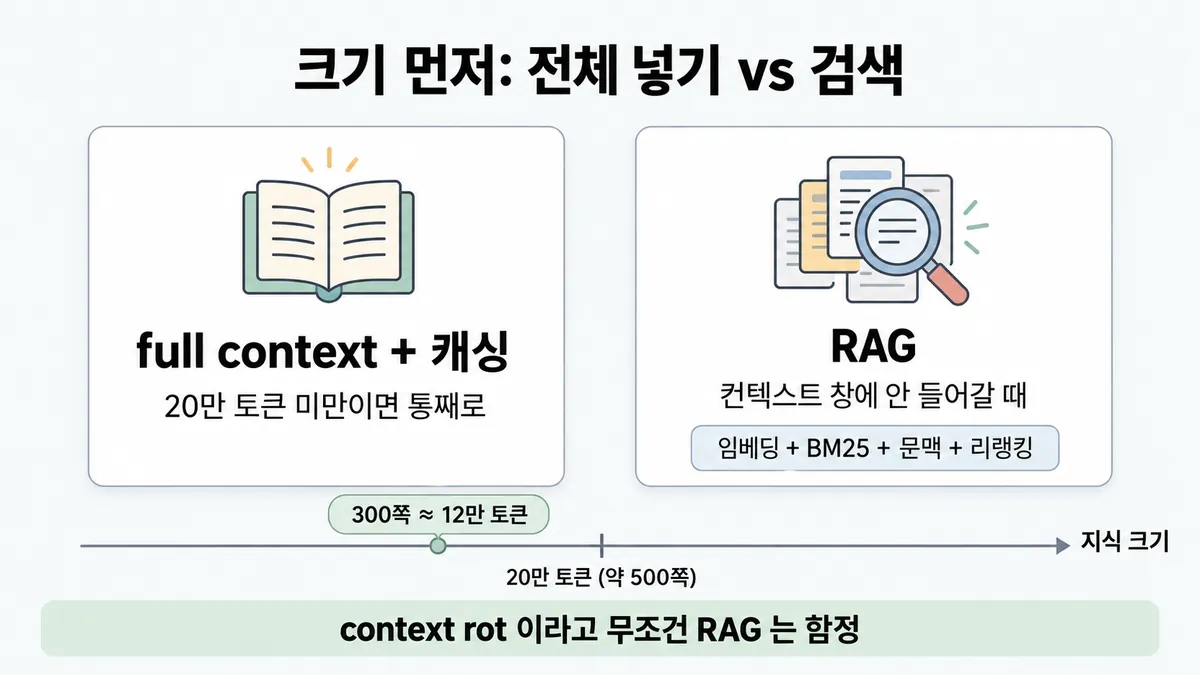
크기 먼저 [2.4①] [3.8①]
full context + 캐싱
RAG 없이 full context(문서 전체를 넣기)로 넣는다. ■ 프롬프트 캐싱으로 빠르고 싸게 만든다
RAG
임베딩 + BM25 + chunk 앞 문맥 설명 붙이기 + 리랭킹으로 찾는다
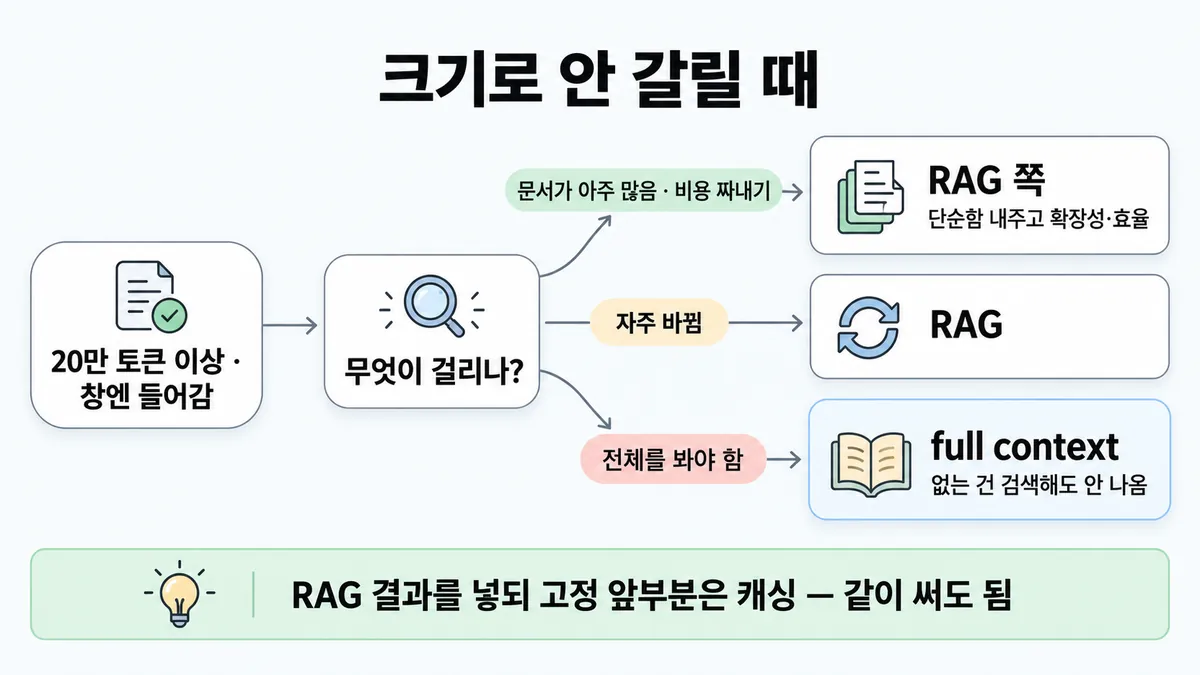
다음 물음 — 무엇이 걸리나?
크기 밖의 조건 [2.4①] [6.4③]
RAG 쪽
RAG 는 단순함을 포기하고 확장성과 효율을 얻는 trade-off 다 (Skilljar)
RAG
자주 바뀌면 RAG 를 쓴다 업계 일반 공식 글·Skilljar 강의 모두 이 조건 없음. 20만 미만이면 공식 글이 먼저 드는 답은 full context 다
full context
전체를 봐야 하는 일은 full context 로 넣는다. chunk 검색은 이 일에 안 맞는다. 없는 것은 검색(retrieval)해도 안 나온다 업계 일반
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 지식 → 캐시 → 검색 → 모델
질문 : 검색을 거쳐야 할까?
① full context + 캐싱 ✓
- 시작 : 지식 — 쪽지 : 제품 매뉴얼 300쪽 / ≈ 12만 토큰
- 넣기 : 지식 → 캐시 : full context 로 넣는다 — 쪽지 : system: 매뉴얼 전문 / + cache_control
- 건너뜀 : 검색
- 읽기 : 캐시 → 모델 : 캐싱으로 빠르고 싸게 읽는다 — 쪽지 : cache_read: 120000 / 질문: "X200 필터 주기?"
- 끝 : 20만 토큰(약 500쪽) 미만이다. RAG 없이 full context 로 넣는다
② 창에 안 들어가면 RAG ✓
- 시작 : 지식 — 쪽지 : 제품 매뉴얼 40종 · 2만 쪽 / 컨텍스트 창보다 큼
- 건너뜀 : 캐시
- 찾기 : 지식 → 검색 : 임베딩 + BM25 + 문맥 + 리랭킹으로 찾는다 — 쪽지 : 검색어: "X200 필터 주기" / chunk 5개 뽑힘
- 넣기 : 검색 → 모델 : 뽑힌 chunk 만 넣는다 — 쪽지 : chunk #4812 / "X200 필터는 6개월마다…"
- 끝 : 컨텍스트 창에 안 들어갈 만큼 크다. 그래서 RAG 를 쓴다
③ 빠진 조항을 검색으로 찾기 ≠
- 시작 : 지식 — 쪽지 : 계약서 100쪽 / 질문: "빠진 필수 조항은?"
- 건너뜀 : 캐시
- 찾기 : 지식 → 검색 : chunk 를 검색한다 — 쪽지 : 검색어: "개인정보 파기" / 결과 0건
- 넣기 : 검색 → 모델 : 없는 것은 검색해도 안 나온다 ≠ — 말 : “빠진 조항은 없어 보여요.”
- 끝 : 전체를 봐야 하는 일에는 chunk 검색이 안 맞는다
규칙 원문 갈림 기준 (갈림길로 그린 규칙)
갈림 기준
지식 크기를 먼저 본다
- 지식이 20만 토큰(약 500쪽) 미만이면 RAG 없이 full context 로 넣는다. ■ 프롬프트 캐싱으로 빠르고 싸게 만든다
- 컨텍스트 창에 안 들어갈 만큼 크면 RAG 를 쓴다. 임베딩 + BM25 + chunk 앞 문맥 설명 붙이기 + 리랭킹으로 찾는다
- 20만 이상이지만 컨텍스트 창에는 들어갈 때(1M 컨텍스트 창)는 크기로 갈리지 않는다. 아래 조건으로 판단한다. 공식 글은 지식이 커지면 더 확장성 있는 방법이 필요하다고만 적는다
- 문서가 아주 많거나 여러 개이면 RAG 쪽이다. 비용과 성능을 더 짜내야 할 때도 RAG 쪽이다. RAG 는 단순함을 포기하고 확장성과 효율을 얻는 trade-off 다 (Skilljar)
- 자주 바뀌면 RAG 를 쓴다 업계 일반 공식 글·Skilljar 강의 모두 이 조건 없음
- 전체를 봐야 하는 일('빠진 조항 찾기')은 full context 로 넣는다. chunk 검색은 이 일에 안 맞는다. 없는 것은 검색해도 안 나온다 업계 일반
- RAG 와 캐싱은 같이 써도 된다. RAG 결과를 넣고 고정 앞부분은 캐싱한다 업계 일반
- 쪽수로 나오면 토큰으로 환산한다. 500쪽 ≈ 20만이면 300쪽 ≈ 12만, 100쪽 계약 ≈ 4만이다 (환산은 계산값)
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
| 지식이 20만 토큰(약 500쪽) 미만이다 | RAG 없이 full context 로 넣고 캐싱한다 | contextual-retrieval "If your knowledge base is smaller than 200,000 tokens (about 500 pages of material), you can just include the entire knowledge base in the prompt" |
| 컨텍스트 창에 안 들어갈 만큼 크다 | RAG 를 쓴다 | contextual-retrieval "For larger knowledge bases that don't fit within the context window, RAG is the typical solution." |
| 문서가 아주 크거나, 여러 개이거나, 비용·성능을 더 짜내야 한다 | RAG 쪽이다 | Skilljar 287763 "especially valuable when working with very large documents, multiple documents, or when you need to optimize for cost and performance" |
| full context 로 넣기로 했다 | 긴 문서는 맨 위에 둔다. 질문과 지시는 그 아래에 둔다. 모델이 관련 부분을 먼저 인용하게 한다 | prompting-best-practices (20k+ 토큰 입력) |
| 에이전트가 긴 작업 중에 필요한 것만 가져와야 한다 | JIT 검색을 쓰거나 섞어 쓴다 | effective-context-engineering |
| 문서 갱신 뒤 모델이 자신 있게 틀린다. 모델과 지연(latency)은 그대로다 | 검색·indexing 단계부터 조사한다 | 가이드 샘플 3 정답 B |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 지식 크기 | 20만 미만이다 | full context 로 넣고 캐싱한다 | 판단 규칙 1 | |
| 지식 크기 | 컨텍스트 창(모델에 따라 200k 또는 1M)보다 크다 | RAG 를 쓴다 | 판단 규칙 2 · context-windows | |
| 문서 개수 | 여러 개이고 계속 늘어난다 | RAG 쪽이다 | Skilljar 287763 | |
| 한 호출에 필요한 양 | 문서의 10% 미만이고 호출이 아주 많다 | RAG·JIT 검색이 싸다 | 계산 | 뒤집히는 때 1 |
| 호출 간격 | 캐시 수명(5분)보다 길다 | full context 는 매번 캐시 쓰기 비용(1.25배)을 낸다. 그래서 크게 비싸다 | 계산 | 뒤집히는 때 2 |
| 과제 모양 | 전체를 대조하거나, 빠진 것을 찾거나, 어디 있을지 모르는 변형을 찾는다 | full context 로 넣는다 | 업계 일반 | 없는 것은 검색해도 안 나온다 |
| 과제 모양 | 한두 구절만 찾아 답한다 | RAG 쪽이다 | 업계 일반 | — |
| 갱신 빈도 | 자주 바뀐다 | 둘 다 된다. full context 는 바뀔 때마다 캐시 쓰기를 1번 한다. RAG 는 re-index 한다 | 계산 | 뒤집히는 때 3 |
| 쪽수로 주어졌나 | 500쪽이다 | 약 20만이다 (옛 토크나이저 기준) | 판단 규칙 1. 새 토크나이저에서는 값이 흔들린다(미해결 2) |
연습 문제
고객지원 Agent 가 참고할 지식은 제품 매뉴얼 300쪽 한 벌300쪽이다. 한 팀원이 "긴 프롬프트는 context rot 이 있으니 벡터 DB 로 RAG 부터 깔자"고 한다. 매뉴얼을 어떻게 넣을까?
시험 대비
함정
- "full context 로 넣는 보기는 항상 오답이다. context rot 이 있으니 무조건 RAG 다" 는 함정이다. 크기를 먼저 본다. 긴 프롬프트가 덜 효과적인 것은 맞다(Skilljar). 그래도 20만 미만이면 공식 글이 먼저 드는 답은 full context 다
- "300쪽은 100만 토큰이라 RAG 가 필수다" 는 함정이다. 환산이 틀렸다
- "검색 인프라가 있어야 엔터프라이즈답다" 는 함정이다. 과설계다 업계 일반
- '빠진 조항 찾기'처럼 전체를 봐야 하는 일에는 chunk 검색이 안 맞는다. 없는 것은 검색해도 안 나온다 업계 일반
- RAG 에도 약점이 있다. 뽑힌 chunk 에 필요한 맥락이 없을 수 있다. 그래서 chunk 앞에 문맥 설명을 붙인다(Contextual Retrieval)
신호
"If your knowledge base is smaller than 200,000 tokens (about 500 pages of material), you can just include the entire knowledge base in the prompt that you give the model, with no need for RAG or similar methods."
"For larger knowledge bases that don't fit within the context window, RAG is the typical solution."
"Sometimes the simplest solution is the best."
"RAG trades simplicity for scalability and efficiency." (Skilljar)
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
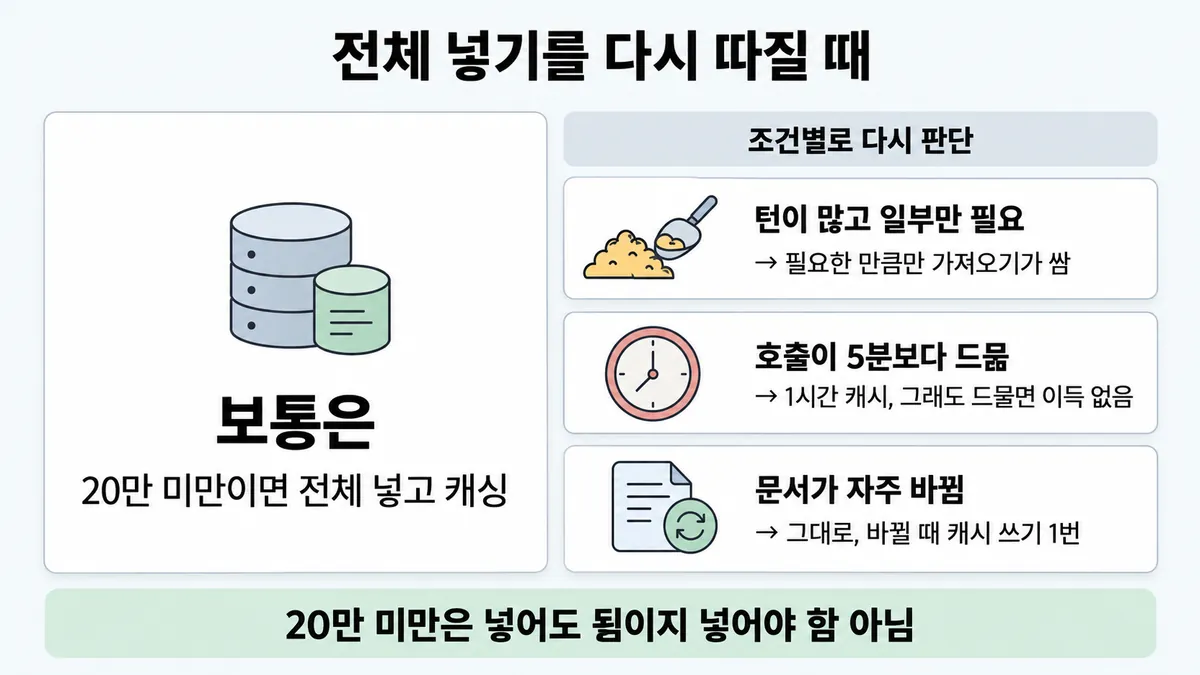
1. 20만 미만인데 JIT 검색이 더 싼 때
- 조건 : 문서가 20만 미만이라 full context 로 들어간다. 그런데 호출(턴)이 아주 많다. 한 호출에 필요한 것은 문서의 일부뿐이다.
- 계산 : 문서 D 토큰을 full context 로 두면, 캐시가 적중한 호출마다 D × 0.1 만큼 입력 단가를 낸다. JIT 검색은 그 호출에 가져온 N 토큰만 낸다. 이 N 토큰은 캐시되지 않는다. 그래서 N < 0.1 × D 면 JIT 검색이 싸다.
- 예 : D = 16만(약 400쪽)이다. Sonnet 5 가격은 백만 토큰당 입력 $2, 캐시 읽기 $0.20 이다. full context 적중 호출 1번 = 16만 × $0.20 = $0.032. JIT 검색 N = 4천이면 4천 × $2 = $0.008. 손익 N = 1만 6천.
- 전제 : 캐시가 호출마다 적중한다. 검색 장치의 비용과 지연은 뺀다. 대화 기록 증가는 양쪽이 같다고 본다. 가격은 2026-09-28 조회값이다.
- 등급 : 계산. 공식 글은 "20만 미만이면 full context 로 넣어도 된다(can)"라고 했다. "넣어야 한다"고 하지는 않았다. 공식 원칙은 컨텍스트가 한정 자원이니 호출마다 작게 두라고 한다(context rot). 이 원칙도 같은 방향이다. 지문이 아래 세 가지를 모두 말하면 JIT 검색 쪽이 설 자리가 있다. 비용이 제약이다. 호출이 많다. 필요한 것은 일부다.
- 근거 : pricing(0.1배) · prompt-caching 표(Sonnet 5 가격) · context-windows(context rot) · effective-context-engineering(한정 자원, 가장 작은 고신호 집합)
- 시험 뒤 변경 Opus 5.5 는 캐시 읽기가 0.05배다(2026-09-22). 그래서 손익 N 이 문서의 5% 로 내려간다.
2. 호출 간격이 캐시 수명보다 긴 때
- 조건 : 같은 문서를 쓴다. 그런데 호출이 드문드문하다(간격이 5분을 넘는다).
- 계산 : 호출마다 캐시 쓰기 1.25배를 낸다. 호출 1번 = 16만 × $2.50 = $0.40. 적중 때($0.032)의 12.5배다.
- 처방 순서 : 먼저 1시간 캐시를 쓴다(쓰기 2배, 읽기 2번부터 이득). 그래도 호출이 드물면 캐싱 이득이 없다. 그때 full context 의 비용은 매번 전체 입력 × 입력 단가다.
- 등급 : 계산 (수명·배수는 확인)
- 근거 : prompt-caching(기본 5분) · pricing
3. 자주 바뀌니까 RAG? — 잘 안 뒤집힘
- 조건 : 문서가 하루에 몇 번 바뀐다.
- 계산 : full context 는 바뀔 때마다 캐시 쓰기 1번(1.25배)이면 다시 적중한다. 하루 몇 번이면 작은 비용이다. RAG 도 바뀔 때마다 re-index 해야 한다.
- 등급 : 계산. "자주 바뀌면 RAG" 는 공식 문장이 없다(업계 일반). 갱신 빈도만으로는 답이 잘 안 바뀐다. 그래서 이 조건만 걸어 놓은 보기는 약하다.
- 근거 : pricing · contextual-retrieval en 전문(이 조건이 없다)
4. 창이 1M 인데 20만 기준은 그대로?
- 조건 : 2026 모델 다수는 1M 컨텍스트 창이 기본이다(Opus·Sonnet 4.6 은 2026-03-13 부터).
- 판단 : 20만 기준 문장은 2024 글에 있다. 컨텍스트 창이 커져서 "창에 들어가는" 범위는 넓어졌다. 그러나 크게 넣을수록 정확도가 떨어진다는 것(context rot)도 공식 글에 있다. 20만~1M 구간은 공식 문장이 없다.
- 등급 : 미해결
- 근거 : context-windows · 릴리스 노트
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "full context 로 넣는 보기는 항상 오답, context rot 이니 무조건 RAG" | context rot 은 공식 글도 인정한다. 긴 프롬프트는 덜 효과적이다(Skilljar) | 20만 미만이면 공식 글이 먼저 드는 답은 full context 다. context rot 은 크기를 먼저 보라는 말이다. 항상 RAG 를 쓰라는 말이 아니다 | contextual-retrieval · context-windows | |
| "300쪽이면 100만 토큰쯤이라 RAG 필수" | 쪽수 감이 없다 | 500쪽 ≈ 20만이면 300쪽 ≈ 12만이다 | 계산 | contextual-retrieval |
| "정책을 5천 토큰으로 요약·잘라서 넣기" | 비용이 바로 줄어 보인다 | 필요한 내용을 잃는다. 가이드 샘플 2 의 A(잘라내기)와 같은 원리다 | 가이드 샘플 2 해설 "Truncation (A) loses needed policy" | |
| "지식을 파인튜닝으로 넣기" | 한 번 학습하면 매번 안 보내도 될 것 같다 | 공식 글이 문서 지식을 넣는 수단으로 드는 것은 full context 와 RAG 다. 파인튜닝은 이 판단의 보기로 약하다 | 업계 일반 | — |
| "검색 개수(top-k)를 늘리면 빠진 걸 찾음" | 더 많이 가져오면 더 잘 찾을 것 같다 | 유사도 검색은 문구가 다른 변형을 못 찾는다. 문서가 컨텍스트 창에 들어가면 full context 가 답이다 | 업계 일반 | 판단 규칙 1 |
| "더 큰 창 모델로 바꾸면 해결" | 컨텍스트 창이 크면 다 넣을 수 있다 | 컨텍스트 창은 목표가 아니라 상한이다. 크게 넣을수록 context rot 으로 정확도가 떨어진다 | context-windows (제3자 문항 유형 요약) | |
| "검색 인프라(벡터 DB)부터 깔아야 엔터프라이즈답다" | 규모 있어 보인다 | 과설계다. 공식 글은 "가장 단순한 것이 최선일 때가 있다"고 적는다 | contextual-retrieval "Sometimes the simplest solution is the best." | |
| "JIT 검색은 항상 full context 보다 쌈" | 적게 넣으니 쌀 것 같다 | 캐시 읽기는 0.1배다. 그래서 한 호출에 문서의 10% 넘게 가져오면 JIT 검색이 오히려 비싸다 | 계산 | 뒤집히는 때 1 (제3자 문항 유형 요약) |
참고
함께 보기
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 2.4 공식 시험 가이드 v1.0
- 가이드 목표 3.8 공식 시험 가이드 v1.0
- Contextual Retrieval 글
- Skilljar API 287763
상태
- 업계 일반 5줄
미해결
- 20만~1M 구간 : 1M 컨텍스트 창이 기본이 된 뒤 "full context 로 넣어도 되는 크기"가 커졌는지 알려 주는 공식 문장이 없다 (뒤집히는 때 4). 공식 글은 20만 문장 다음에 "as your knowledge base grows, you'll need a more scalable solution"까지만 말한다. 카드에는 "크기로 갈리지 않는다. 아래 조건으로 판단한다" 로 적었다.
- 쪽수 환산 : 500쪽 ≈ 20만은 2024 글 기준이다. 새 토크나이저는 같은 글을 약 30% 더 센다(Sonnet 5, 릴리스 노트). 그래서 같은 500쪽이 약 26만일 수 있다. 시험 지문이 쪽수로만 주면 20만 기준으로 환산하는 것이 안전하다(추론).
- JIT 검색 손익의 "검색 장치 비용·지연"은 공식 숫자가 없어 계산에서 뺐다.
- (이 카드 밖) 목록 2.4③ 이 인용한 "질문을 끝에 두면 최대 30% 향상" 문장이 지금 prompting-best-practices 문서에는 없다. 2.4③ 을 카드로 만들 때 확인한다.