■ 최적화 lever 하나 고르기
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 4.5 토큰·지연·비용 최적화 · D4 평가 16%Optimize token usage, latency, and cost-performance trade-offs
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 4.5② 보기마다 다른 최적화 — 이 시나리오의 레버는 무엇 하나? — 시나리오 단서 → 레버 하나 (캐싱 · 배치 · 라우팅/effort · 스트리밍)
- 1.6③ 한 건에 얼마, 한 달에 얼마? — 비용 축을 숫자로 — 요청당 비용으로 설계안 비교
- 3.3① 상담원이 "답 초안이 늦게 뜬다"고 한다 — 모델부터 바꾸나? — 지연 lever 고르기 (스트리밍 · 캐싱 · 출력 길이 · effort · 모델 교체)
한눈에
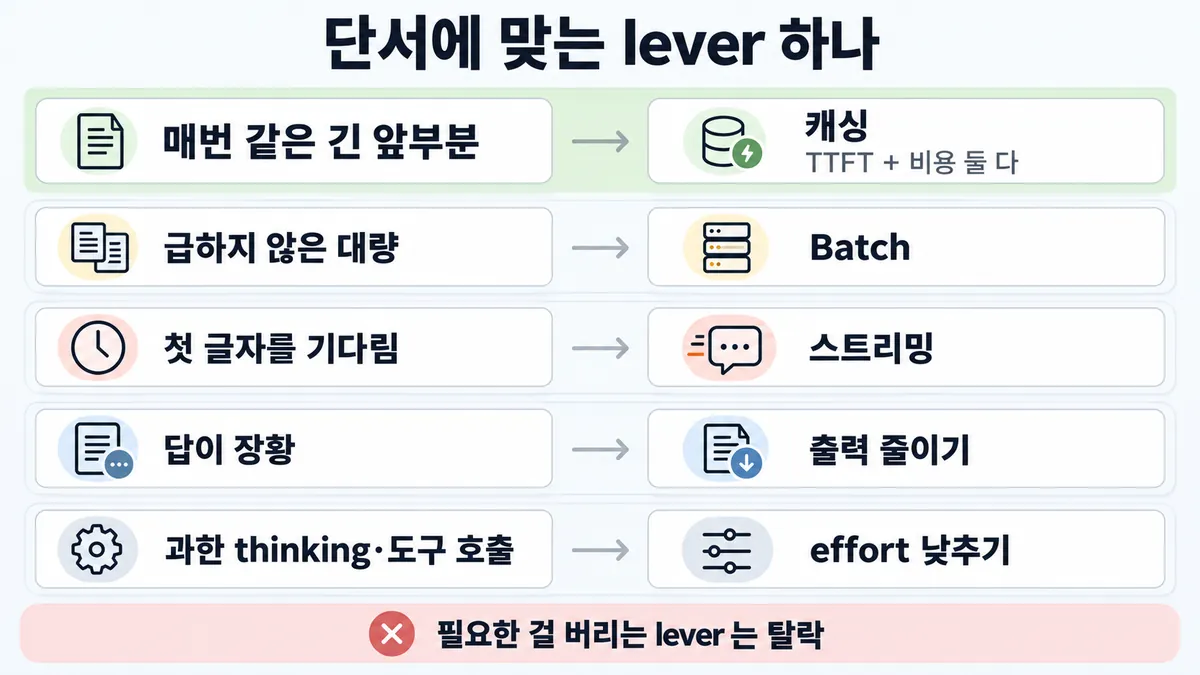
보기마다 다른 최적화가 섞여 나오면 지문이 든 제약과 단서를 읽는다. 그리고 그 제약을 "가장 직접" 푸는 lever(조절 수단) 하나를 고른다. 필요한 것을 버리는 lever 는 탈락이다 (샘플 2)
- 제약 : 비용 · 지연(latency) · 처리량
- 단서 : 매번 같은 앞부분 · 마감 없음 · 첫 글자 기다림 · 장황
lever 본문은 각 카드에 있다. 여기는 단서와 lever 의 짝, 그리고 탈락 기준만 다룬다
비유 성능 튜닝과 같다. 병목(CPU·디스크·네트워크) 하나를 먼저 찾고, 거기에 맞는 lever 만 돌린다. 디스크 병목에 CPU 를 늘리면 돈만 쓴다
ELI5
막힌 수도관을 고치는 거예요. 어디가 막혔는지 보고 그 자리만 뚫어요.
- 물이 늦게 나오면 꼭지 쪽을, 물값이 많이 나오면 새는 곳을 봐요.
- 관을 잘라서 짧게 만들면 물은 빨리 오지만 필요한 방에 물이 안 가요.
- 두 군데가 다 문제면 한 번에 둘 다 고치는 수리가 제일 좋아요.
- 이 쪽은 "언제 다른 수리가 더 맞나"를 모아 둔 곳이에요.
개념 설명
원리
lever(조절 수단)마다 줄이는 것이 다르다
- 캐싱 : 매번 같은 앞부분을 다시 읽지 않는다. 그래서 첫 토큰(TTFT)과 입력 비용이 같이 준다. 출력은 그대로다.
- Batch : 급하지 않은 요청을 모아 입력·출력 모두 50% 할인받는다. 대신 끝나는 시각 약속이 없다.
- 스트리밍 : 첫 글자가 먼저 보여 기다림이 짧게 느껴진다. 토큰 수와 총 시간은 그대로다 (업계 일반).
- 출력 줄이기 : 생성 토큰이 줄어 전체 시간과 출력 비용이 같이 준다. 출력 단가가 입력의 5배라 효과가 크다.
- effort : 한 모델 안에서 thinking(사고)·도구 호출·답의 토큰을 줄인다. 능력 일부를 내준다.
- 라우팅 · 멀티 모델 : 쉬운 일은 싼 모델로 보낸다. 그러면 대부분 토큰이 낮은 요율로 처리된다.
"가장 직접" 의 뜻
- 지문이 든 제약(예 : 지연(latency) + 비용)을 한 lever 가 다 풀면 그 lever 가 답이다. 한쪽만 풀면 약한 보기다.
- 필요한 것을 버려서 얻는 절감(잘라내기 · 무작정 최소 모델)은 "직접" 이 아니다. 품질을 희생하는 trade-off(절충)라서 탈락이다.
핵심 질문 두 개
- 이 지문이 말한 제약은 무엇인가(비용 · 지연 · 처리량 · 마감)?
- 이 lever 는 그 제약을 전부 줄이나? 아니면 무엇을 잃나?
규칙과 판단
갈림길
①② 단서로 lever [4.5②]
캐싱
안 바뀌는 것은 앞에 두고 캐싱한다. 그러면 TTFT 와 per-request cost 를 같이 줄인다. 필요한 문맥도 버리지 않는다 (샘플 2 정답)
Batch
입력과 출력 모두 50% 할인된다. 완료 시각 약속은 없다. 자세한 것은 ◆ Batch API vs 동기 호출 에 있다
스트리밍
체감 반응성을 크게 올린다. 비용과 총 시간은 그대로다 업계 일반
출력 줄이기
"짧게 답해" 로 요청하고 max_tokens 로 상한을 둔다. 자세한 것은 ■ max_tokens 와 긴 출력 에 있다
effort 낮추기
얻는 것은 지연과 비용이다. 잃는 것은 능력 일부다. eval 로 확인한다
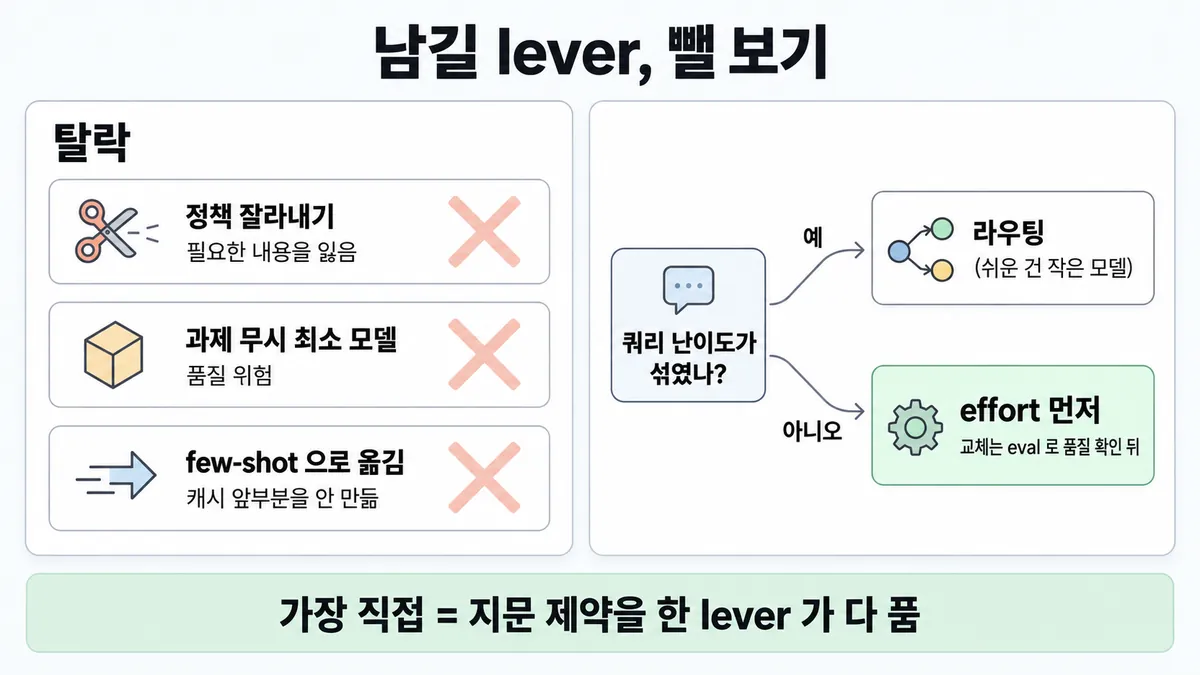
다음 물음 — 쿼리 난이도가 한결같나?
④ 모델 쪽 [4.5②] [2.1②]
라우팅 · 멀티 모델
쉽고 흔한 질문은 작은 모델로 보낸다. 어렵고 드문 질문은 큰 모델로 보낸다. 그러면 대부분의 토큰이 낮은 요율로 처리된다
effort 먼저
모델을 바꾸기보다 effort 조정이 나은 경우가 많다. 그래도 품질 여유가 남으면 더 작은 모델을 쓴다
eval 먼저
좋은 평가 셋이 모델 고르기에서 가장 중요한 단계다
③ 탈락 보기 [4.5②]
탈락
필요한 정책을 잃는다 (샘플 2 A)
탈락
무작정 낮추면 품질이 위험하다 (샘플 2 B)
탈락
캐시 가능한 재사용 앞부분을 만들지 않는다 (샘플 2 D)
탈락
배치는 완료 시각을 내준다. effort 를 올리면 토큰이 늘어 비용이 는다
남긴다 · 가장 직접
"가장 직접" 은 지문이 든 제약을 한 lever 가 다 푸는가를 뜻한다
나머지 규칙
-
측정 : eval 셋이 있으면 고정 과제 세트에서 아래 값을 기준선으로 본다. 그리고 lever 전후를 비교한다
- 지연
- 토큰 사용량
- 작업당 비용
- 오류율
한 번에 여러 lever 를 켜면 어느 것이 효과인지 구분하지 못한다 업계 일반. 운영(production) 비용 추적은 ■ 비용 급증 추적 에 있다
비용을 줄이는 공식 순서는 맞는 모델, 캐싱, 배치, 사용 패턴 감시다. 그 본문은 ■ per-request cost 에 있다
규칙 원문 ①②③④ (갈림길로 그린 규칙)
-
단서와 lever 의 짝은 아래 표와 같다 (각 칸 =, 표로 읽는 법 자체는 업계 일반) [4.5②]
단서 lever 얻는 것 잃는 것 매번 같은 긴 앞부분 캐싱 (안 바뀌는 것은 앞에 둔다) TTFT + per-request cost 5분 캐시는 쓰기 비용이 1.25배다. 읽기 1번부터 이득이다. 최소 길이에 못 미치면 조용히 안 된다 (■ 프롬프트 캐싱) 급하지 않은 대량 Batch 입력·출력 모두 50% 할인 완료 시각 (대부분 1시간, 24시간 넘으면 만료) 첫 글자 기다림 스트리밍 체감 반응성 없다. 대신 비용·총 시간도 그대로다 업계 일반 장황하다 · 전체 시간이 길다 출력 줄이기 (프롬프트 + max_)tokens 전체 시간 · 출력 비용 한도가 낮으면 잘린다 과한 thinking(사고)·도구 호출 effort 낮추기 지연 · 비용 능력 일부. eval 로 확인한다 난이도 섞인 쿼리 라우팅 · 멀티 모델 대부분 토큰을 낮은 요율로 분류 단계 · 어려운 것을 작은 모델로 보낼 위험 업계 일반 -
"가장 직접" 은 지문이 든 제약을 한 lever 가 다 푸는가를 뜻한다. 지연과 비용이 둘 다 걸리면 캐싱이다(둘 다 줄인다). 스트리밍은 비용을 못 줄인다업계 일반. 배치는 지연을 늘린다 (샘플 2)
여러 lever 가 다 맞으면 겹쳐 쓴다. 배치와 캐싱 할인은 곱해진다. 예는 설명 쪽 뒤집히는 때 1 에 있다
-
탈락 기준은 둘이다
- 필요한 것을 버리는 lever 다. 잘라내기(A)·과제 무시 최소 모델(B)·구조만 옮기기(D)가 여기에 든다 (샘플 2)
- 지문에 없는 제약을 푸는 lever 다. 지연 문제에 배치를 쓰거나 비용 문제에 effort 를 올리는 것이 여기에 든다
-
모델 쪽 순서 : 한 모델 안에서 effort 를 먼저 조정한다. 부족하면 모델을 바꾼다. 모델 교체나 다운은 eval 로 품질을 확인한 뒤에 한다
난이도가 섞였으면 라우팅이나 멀티 모델을 쓴다
- 라우팅 : 쉽고 흔한 것은 Haiku 급으로, 어렵고 드문 것은 큰 모델로 보낸다
- 멀티 모델 : 실행자가 어려운 결정만 어드바이저로 올린다. 또는 orchestrator 가 대량 일을 싼 워커에 넘긴다
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
| 매번 같은 긴 앞부분에 짧게 바뀌는 질문이 붙는다. 지연과 비용이 둘 다 걸린다 | 안 바뀌는 것은 앞에 두고 캐싱한다 | sample-questions-p6-7 "reducing both time-to-first-token and per-request cost without discarding required context" |
| 비용을 줄이려고 정책을 잘라내거나, 최소 모델을 쓰거나, few-shot 으로 옮긴다 | 셋 다 오답이다 | sample-questions-p6-7 "Truncation (A) loses needed policy; downsizing blindly (B) risks quality; relocating to few-shot (D) does not create a cacheable, reusable prefix." |
| 급하지 않은 작업이다 | Batch 를 쓴다 | pricing "Use the Batch API for non-time-sensitive tasks" |
| 사용자가 출력을 기다린다(체감) | 스트리밍을 쓴다 | reduce-latency (체감 반응성) |
| 답이 장황하거나 출력이 길다 | "짧게" 를 요청하고 max_ 로 상한을 둔다 | reduce-latency |
| 한 모델 안에서 지연과 비용을 더 줄여야 한다 | effort 조정이 모델 교체보다 먼저다 | choosing-a-model "Tuning effort is often a better lever than switching models." |
| 쉽고 흔한 질문과 어렵고 드문 질문이 섞였다 | 라우팅한다 (작은 모델 ↔ 큰 모델) | building-effective-agents |
| 비싼 모델 하나로 모든 토큰을 쓴다 | 멀티 모델을 쓴다(실행자가 어드바이저로 올리거나, orchestrator 가 싼 워커에 넘긴다) | choosing-a-model |
| lever 효과를 재야 한다 | eval 셋의 고정 과제에서 지연·토큰·작업당 비용·오류율 기준선을 본다 | demystifying-evals |
| lever 둘이 다 맞는다(앞부분이 반복되고 급하지 않다) | 겹쳐 쓴다. 배치와 캐싱 할인은 곱해진다 | pricing |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 제약 | 지연 + 비용 | 캐싱을 쓴다(둘 다 줄인다) | 판단 규칙 1 | |
| 제약 | 비용만 걸리고 마감이 없다 | Batch 를 쓴다(+ 캐싱 할인도 같이 받는다) | 계산 | 판단 규칙 3 · 뒤집히는 때 1 |
| 제약 | 체감 지연만 | 스트리밍을 쓴다 | 판단 규칙 4 | |
| 제약 | 사람이 기다리고 비용도 걸린다 | 배치는 탈락이다. 캐싱·출력 줄이기·effort 를 쓴다 | ◆ Batch API vs 동기 호출 | |
| 앞부분 길이 | 모델의 최소 캐시 길이 미만이다 | 캐싱이 오류 없이 안 먹는다. 다른 lever 를 쓴다 | prompt-caching (Sonnet 5 1,024 · Haiku 4.5 4,096 · Opus 5.5 512) | |
| 쉬운 쿼리 비율 | 높다 (예 90%) | 라우팅이 크게 싸다 | 계산 | 뒤집히는 때 3 |
| 쉬운 쿼리 비율 | 낮다 (약 21% 미만, 아래 예) | 라우팅이 오히려 비싸다. effort 를 쓴다 | 계산 | 뒤집히는 때 3 |
| 배치 안 캐시 적중률 | 보장이 없다(되는 만큼 · 보통 30~98%) | 낮으면 캐싱 할인을 같이 받는 이득이 작다 | 계산 | 뒤집히는 때 1 |
| 품질 여유 | eval 로 확인하지 않았다 | lever 전에 eval 부터 한다 | choosing-a-model |
연습 문제
고객지원 Agent 는 요청마다 같은 환불·교환 정책 문서 8천 토큰을 맨 앞에 붙여같은 앞부분 보낸다. 상담원 화면의 첫 응답이 느리고 per-request cost(요청당 비용)도 줄이라지연·비용는 요구가 왔다. 팀원은 정책 문서를 앞 1,000 토큰만 남기고 자르자고 한다. 가장 직접 푸는 lever 는?
시험 대비
함정
- 비용을 줄이려고 정책을 잘라내는 것, 과제를 무시하고 제일 작은 모델을 쓰는 것, 정책을 few-shot 블록으로 옮기는 것은 셋 다 오답이다 (샘플 2)
- 지연과 비용이 둘 다 걸렸는데 "스트리밍" 을 고르는 것은 함정이다. 스트리밍은 체감만 바꾼다. 토큰 비용은 그대로다 업계 일반
- 사람이 기다리는 일에 "배치로 50%" 를 고르는 것은 함정이다. 완료 시각 약속이 없다
- 비용 문제에 "effort 올리기" 를 고르는 것은 함정이다. 토큰이 늘어 비용이 는다
- lever 를 한꺼번에 여러 개 켜는 것은 함정이다. 무엇이 먹혔는지 모른다. 근거 없는 조합이다 업계 일반
- 캐싱 손익분기를 "요청 2~3회" 로 외우는 것은 함정이다. 5분 캐시는 읽기 1번부터, 1시간 캐시는 읽기 2번부터 이득이다
- "모델 교체는 항상 오답이다" 는 함정이다. effort 로도 모자라고 eval 로 품질을 확인했으면 맞는 답이다
신호
"Ordering stable content first and enabling prompt caching lets repeated prefixes be reused, reducing both time-to-first-token and per-request cost without discarding required context." (가이드 샘플 2)
"Truncation (A) loses needed policy; downsizing blindly (B) risks quality; relocating to few-shot (D) does not create a cacheable, reusable prefix." (가이드 샘플 2)
"Tuning effort is often a better lever than switching models."
"Use the Batch API for non-time-sensitive tasks"
"Routing easy/common questions to smaller, cost-efficient models like Claude Haiku 4.5 and hard/unusual questions to more capable models"
"Once evals exist, you get baselines and regression tests for free: latency, token usage, cost per task, and error rates can be tracked on a static bank of tasks."
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
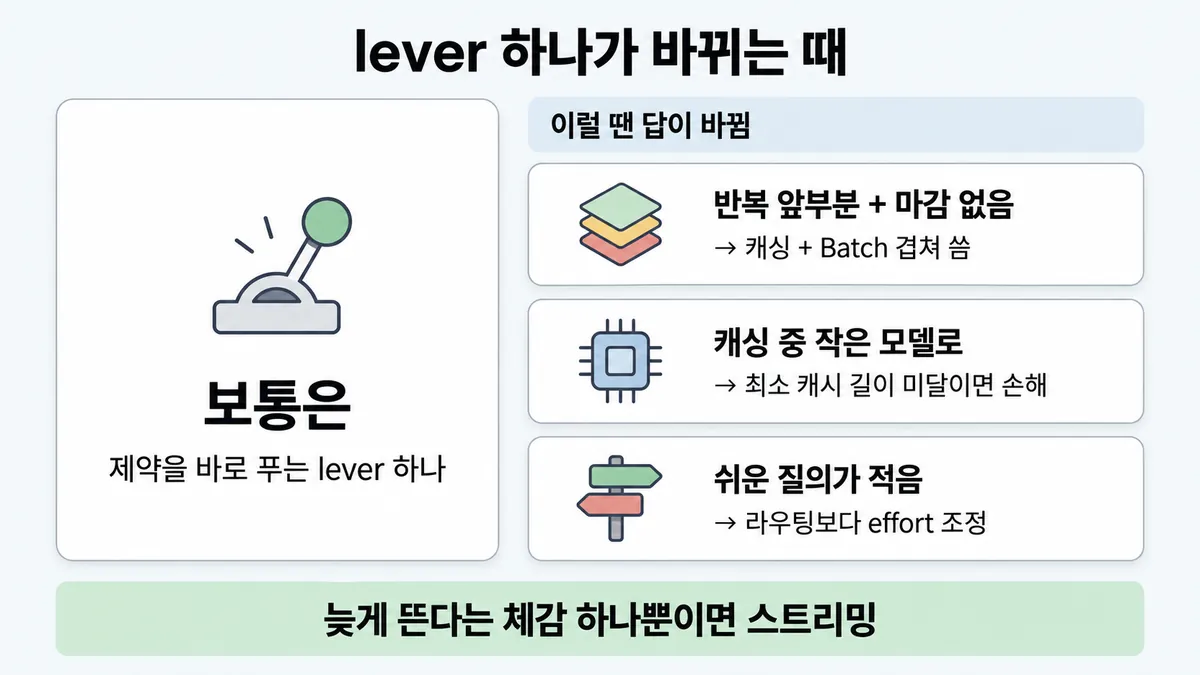
1. "lever 하나" 인데 둘을 겹치는 게 답인 때
- 조건 : 매번 같은 앞부분 6천 토큰에 질문 300, 출력 500 이다. 밤새 처리하면 되는 일이다(마감 없음). 모델은 Sonnet 5 다.
- 계산 (백만 토큰당 입력 $2 · 출력 $10 · 5분 쓰기 $2.50 · 읽기 $0.20, 배치 = 전부 × 0.5) :
- 동기 · 캐시 없음 = 6,300 × $2 + 500 × $10 = $0.0126 + $0.005 = $0.0176
- 동기 · 캐시 적중 = 6,000 × $0.20 + 300 × $2 + $0.005 = $0.0068
- 배치만 = $0.0088
- 미스면 쓰기 1.25배가 붙는다. 6,000 × $2.50 + $0.0006 + $0.005 = $0.0206
- 배치 + 캐싱, 적중률 h : 0.5 × [h × $0.0068 + (1−h) × $0.0206]
- h = 98% 면 약 $0.0035 다(배치만의 약 40%). h = 30% 면 약 $0.0082 다(배치만과 거의 같다).
- 판단 : 제약이 "비용" 하나여도 단서 두 개(반복 앞부분 · 마감 없음)가 다 있으면 겹쳐 쓴다. 단 배치 안 캐시 적중은 보장이 없다(되는 만큼이다). 그래서 적중률이 낮으면 겹친 이득이 작다.
- 전제 : 적중률 h 는 가정이다. 앞부분은 요청마다 같은
cache_control블록이다. 가격은 2026-09-28 조회값이다. - 등급 : 계산 (배수·곱해짐은 확인)
- 근거 : prompt-caching 표 · pricing · batch-vs-sync 카드(적중 보장 없음 · 30~98%)
2. "작은 모델로 내리면 싸다" 가 틀리는 때
- 조건 : 앞부분 3천 토큰(매번 같다)에 질문 200, 출력 300 이다. Sonnet 5 에서 캐싱이 적중하고 있다. 비용을 더 줄이려 Haiku 4.5 로 내리자는 안이 나왔다.
- 계산 :
- Sonnet 5 캐시 적중 = 3,000 × $0.20 + 200 × $2 + 300 × $10 = $0.0006 + $0.0004 + $0.003 = $0.0040
- Haiku 4.5 는 최소 캐시 길이 4,096 미만이라 캐싱이 안 된다. 3,200 × $1 + 300 × $5 = $0.0032 + $0.0015 = $0.0047
- 단가가 절반인 모델로 내렸는데 요청당 약 18% 비싸다.
- 전제 : 두 모델의 토큰 수가 같다고 봤다. 실제로 Sonnet 5 는 새 토크나이저라 같은 글을 약 30% 더 센다. 그러면 Sonnet 5 쪽이 약 $0.0052 가 되어 Haiku 가 약간 싸다. 결론은 이렇다. 단가표만 보고 "절반 값" 을 기대하면 틀린다. 캐싱 최소 길이와 토크나이저까지 넣어 계산해야 한다.
- 등급 : 계산 (최소 길이·단가·토크나이저 30% 는 확인)
- 근거 : prompt-caching · prompt-caching 표 · 릴리스 노트
3. 라우팅이 손해인 때
- 조건 : 분류 쿼리다. 쿼리당 입력 1,500, 출력 200 이다. 지금은 전부 Opus 5.5($4/$20)로 처리한다. 라우터는 Haiku 4.5 한 번이다(입력 1,500 · 출력 10).
- 계산 :
- Opus 5.5 전부 = 1,500 × $4 + 200 × $20 = $0.010
- Haiku 4.5 한 건 = 1,500 × $1 + 200 × $5 = $0.0025 · 라우터 = $0.00155
- 쉬운 비율 90% 면 $0.00155 + 0.9 × $0.0025 + 0.1 × $0.010 = $0.0048 이다(약 52% 절감).
- 쉬운 비율 30% 면 $0.0093 이다(약 7% 절감). 오분류 위험까지 지면 이득이 약하다.
- 손익 : $0.00155 = s × $0.0075 이므로 s ≈ 21% 다. 쉬운 쿼리가 약 21% 미만이면 라우터 비용 때문에 더 비싸다.
- 판단 : 난이도가 대부분 쉬울 때만 라우팅한다. 섞였어도 어려운 쪽이 많으면 effort 조정이 먼저다.
- 전제 : 두 모델의 토큰 수가 같다고 봤다. 오분류 비용은 뺐다. 가격은 2026-09-28 조회값이다.
- 등급 : 계산
- 근거 : prompt-caching 표 · building-effective-agents · choosing-a-model
4. 스트리밍이 정답인 때
- 조건 : 제약이 "사용자가 답이 늦게 뜬다고 느낌" 하나뿐이다. 비용 말은 없다.
- 판단 : 스트리밍이 가장 직접이다. 캐싱은 앞부분이 매번 같을 때만 맞다. 출력 줄이기는 답 내용을 바꾼다. 지문이 "첫 글자까지" 인지 "다 받기까지" 인지 먼저 구분한다. 자세한 것은 ◆ TTFT vs 응답 완료 지연 에 있다.
- 등급 : (스트리밍 = 체감) · 업계 일반 (총 시간 그대로)
- 근거 : reduce-latency
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "정책 문서를 앞 1,000 토큰만 남기고 자름" | 입력이 바로 줄어 보인다 | 필요한 정책을 잃는다 | sample-questions-p6-7 | |
| "과제와 상관없이 가장 작은 모델로" | 단가가 제일 싸다 | 무작정 낮추면 품질이 위험하다 | sample-questions-p6-7 | |
| "정책을 few-shot 예시 블록으로 옮김" | 구조를 바꾸면 나아 보인다 | 캐시 가능한 재사용 앞부분을 만들지 않는다 | sample-questions-p6-7 | |
| "지연·비용 둘 다니까 스트리밍" | 지연 = 스트리밍으로 외웠다 | 체감만 바뀐다. 토큰 비용은 그대로다 | 업계 일반 | reduce-latency("체감") |
| "상담원이 기다리지만 대량이니 배치로 50%" | 50% 가 커 보인다 | 완료 시각 약속이 없다 | ◆ Batch API vs 동기 호출 | |
| "품질·비용 둘 다 위해 effort 를 max 로" | 높을수록 좋아 보인다 | effort 를 올리면 토큰이 늘어 비용이 는다 | effort | |
| "캐싱·배치·라우팅·effort 를 한꺼번에 적용" | 많이 할수록 좋아 보인다 | 무엇이 먹혔는지 구분하지 못한다. 근거 없는 조합이다 | 업계 일반 | 목록 4.5② "매력적인 오답" |
| "Haiku 로 내리면 단가가 절반이니 비용도 절반" | 단가표가 그렇게 보인다 | 캐싱 최소 길이와 토크나이저까지 넣으면 거의 같거나 더 비쌀 수 있다 | 계산 | 뒤집히는 때 2 |
| "모델 교체 보기는 늘 오답" | 샘플 2 B 를 일반화했다 | effort 로도 모자라고 eval 로 품질을 봤으면 맞는 답이다 | choosing-a-model | |
| "캐싱은 요청 2~3회부터 이득" | 영상 요령이다 | 5분 캐시는 읽기 1번부터, 1시간 캐시는 읽기 2번부터 이득이다 | pricing |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 4.5 공식 시험 가이드 v1.0
- 샘플 2 (raw/official sample-questions-p6-7)
- pricing
- choosing-a-model
- building-effective-agents
- reduce-latency
- effort
- demystifying-evals
상태
- 업계 일반 4줄(스트리밍 비용 무관 · 표로 읽는 법 · 라우팅 위험 · 한꺼번에 켜기)
미해결
- 목록 4.5② 매력적인 오답 "근거 없이 최적화 여러 개 동시 적용" 을 받쳐 줄 공식 문장을 못 찾았다. demystifying-evals · develop-tests · reduce-latency · pricing 에서 "one at a time" · "one change" · "one variable" · "isolate" 를 검색했다. 카드에는 업계 일반으로 두었다.
- 라우팅 계산의 오분류 비용은 뺐다. 라우터가 어려운 쿼리를 작은 모델로 보낼 때의 품질 손실은 공식 숫자가 없다.
- 새 토크나이저 30% 는 "내용에 따라 다름" 이다(릴리스 노트). 그래서 뒤집히는 때 2 의 결론은 경계선에 있다. 시험 지문은 토큰 수를 주거나 배수(출력 5배 · 읽기 0.1배 · 배치 50%)로 물을 가능성이 있다 (추론).
- 시험 시점 단가 : 가이드가 어느 모델 가격을 전제했는지 모른다. 위 계산은 2026-09-28 조회값이다.