◆ 한 요청 안 thinking vs 여러 호출 체이닝
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 2.3 프롬프트 기법 · D2 모델·프롬프트 13%Apply prompt engineering techniques (zero-shot, few-shot, chain-of-thought)
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 2.3② 여러 단계 추론이 필요하다 — "step by step" 문구? thinking? 체이닝? — CoT(한 요청 안에서 사고) vs 프롬프트 체이닝(여러 호출로 쪼개기)
- 1.5② 한 프롬프트에 다 시킬까, 나눠 시킬까? — 분해 단위 정하기 (단일 프롬프트 vs 과제별 호출)
한눈에
ELI5
어려운 수학 숙제를 푸는 두 가지 방법이에요.
- 혼자 연습장에 끄적이며 한 번에 풀 수도 있어요.
- 한 단계 풀 때마다 선생님께 보여 드리고 다음으로 넘어갈 수도 있어요.
- 한 번에 푸는 게 보통 더 빨라요.
- 중간에 누가 꼭 봐야 하면 단계마다 보여 드려야 해요.
- 이 쪽은 "언제 나눠야 하나"를 모아 둔 곳이에요.
개념 설명
원리
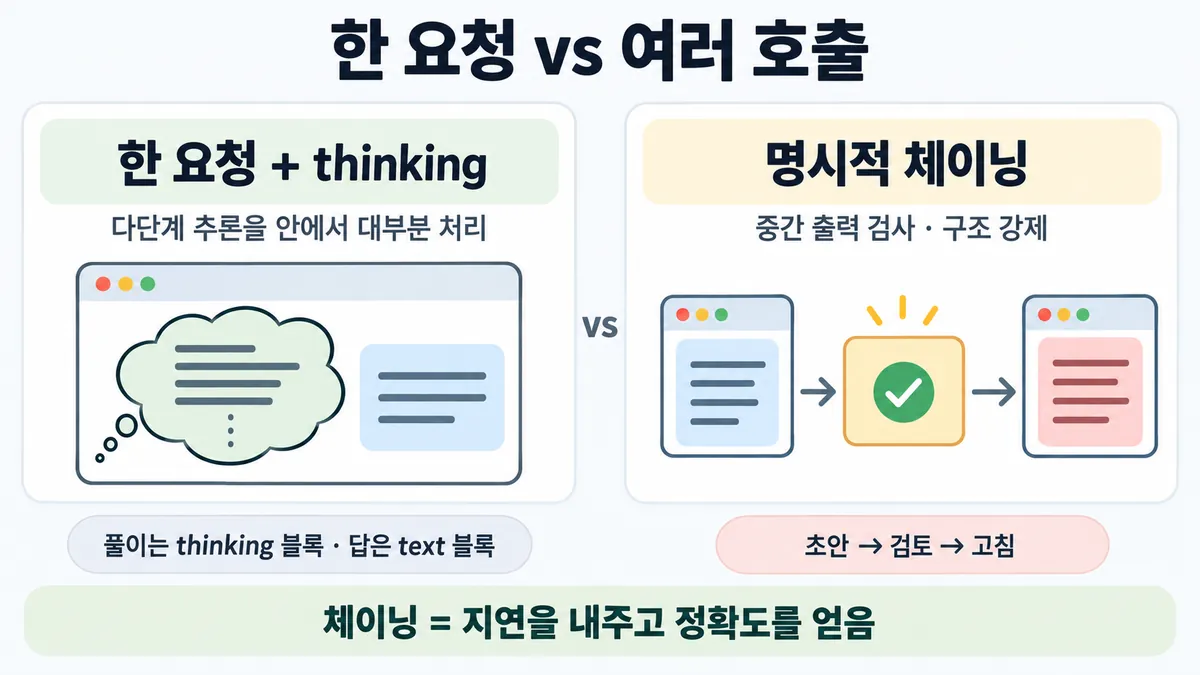
thinking (한 요청 안)
- 모델은 답하기 전에 thinking 블록에서 아래 일을 한다. 답은 text 블록에 쓴다.
- 문제를 다시 말한다
- 방법을 시도한다
- 중간 결과를 확인한다
- 안 되는 길은 버린다
- adaptive 모드면 모델이 요청마다 "생각할지·얼마나"를 스스로 정한다. 단순한 요청에서는 thinking 을 건너뛴다.
- 도구를 쓰면 도구 호출 사이에도 생각한다(interleaved thinking). adaptive 면 이것이 자동으로 된다. 도구 루프 전체가 한 어시스턴트 턴이다.
- 비용 : thinking(사고) 토큰은 출력 토큰으로 청구된다.
max_tokens에도 포함된다. 안 보여도 청구된다. - 한계 : 중간 결과가 모델 안에서만 흐른다. 그래서 코드나 사람이 단계 사이에 끼어들 틈이 없다. 새 모델은 추론(reasoning) 원문도 주지 않는다(요약 또는 빈 칸).
prompt chaining(프롬프트 체이닝 · 여러 호출)
- 일을 순서대로 나눈다. 앞 호출의 출력을 다음 호출이 처리한다. 호출 사이에 코드 검사(gate)를 둘 수 있다.
- 호출마다 일이 쉬워지니 정확도가 오른다. 대신 호출이 순서대로 쌓여 지연(latency)이 늘어난다.
- 얻는 것은 셋이다.
- 단계마다 기록·평가·분기를 할 수 있다
- 사람이 확인할 수 있다
- 정해진 구조를 강제할 수 있다
- 흔한 모양은 자기 교정이다. 초안을 쓰고, 기준으로 검토하고, 고친다.
수동 CoT
- 수동 CoT 는 thinking 이 꺼져 있을 때의 대안이다. "생각해 보라"고 요청하고
<thinking>·<answer>태그로 추론과 답을 나눈다. - 추론이 답 글 안에 섞여 나온다. 그래서 코드가 태그로 잘라 내야 한다.
핵심 질문 두 개
- 단계 사이의 중간 결과를 코드나 사람이 봐야 하나?
- thinking 을 켤 수 있는 모델인가, 켜져 있나?
규칙과 판단
갈림길
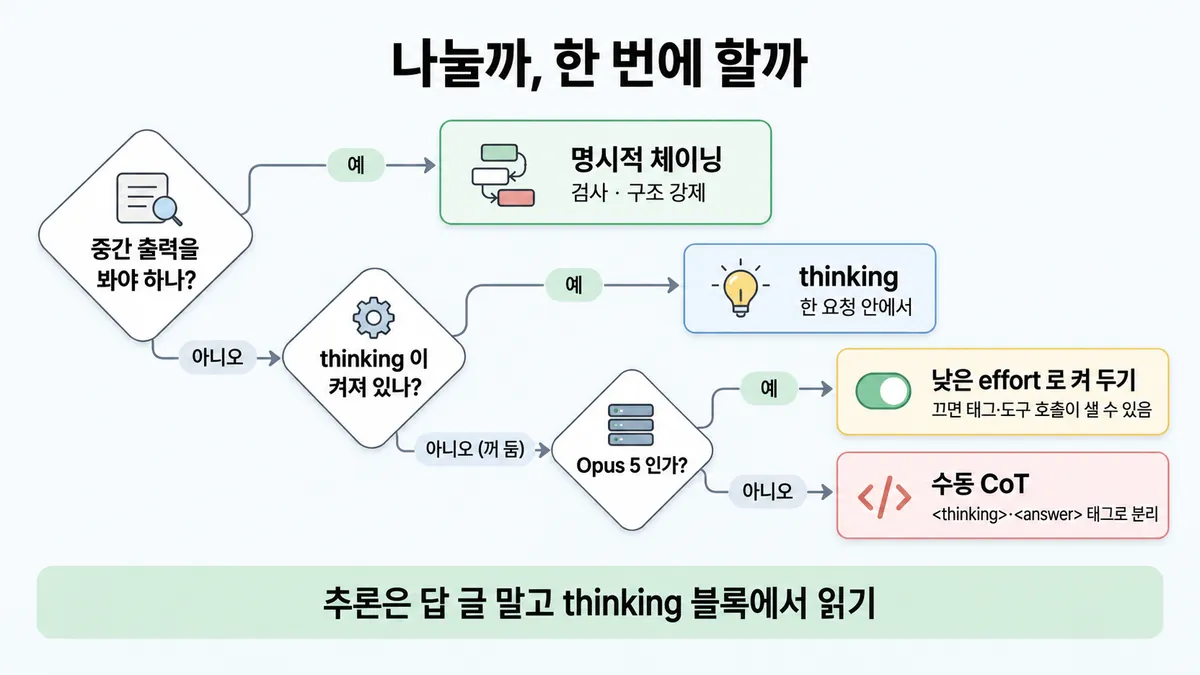
한 요청이냐 여러 호출이냐 [2.3②]
명시적 체이닝
중간 출력을 검사하거나 파이프라인 구조를 강제할 때 쓴다. 자세한 것은 ■ decomposition 단위 정하기 에 있다
thinking
adaptive thinking 과 서브에이전트로 한 요청 안에서 대부분 처리한다
낮은 effort 로 켜 둔다
끄지 않는다. 끄면 내부 XML 태그와 도구 호출이 답 글에 샐 수 있다 (Opus 5 = 2026-07-24 출시, 시험 뒤 변경 가능)
수동 CoT
"생각해 보라"고 요청한다. <thinking>·<answer> 태그로 추론(reasoning)과 답을 분리한다
thinking 을 어떻게 이끄나 [2.3②]
thinking 블록을 읽는다
답 글로 추론을 요구하지 않는다. thinking 블록을 읽는다. 새 모델은 display 기본값이 "omitted"(빈 칸)이다. "summarized" 로 켠다
일반 지시 · effort ↑
단계를 일일이 적어 준 계획보다 "think thoroughly" 같은 일반 지시가 나을 때가 많다. 모자라면 effort 를 올린다
effort ↓ 먼저
thinking(사고)이 과하면 effort 를 먼저 낮춘다. 프롬프트 조정은 그다음이다
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 요청 → 모델 → 코드 검사 → 결과
질문 : 중간 결과를 봐야 할까?
① 다단계 추론은 thinking 으로 ✓
- 시작 : 요청 — 말 : “주문 1042 환불돼요? / 규정 3개와 대조”
- 요청 : 요청 → 모델 : 한 요청으로 보낸다 — 쪽지 : thinking: / {type: "adaptive"}
- thinking : 모델 : thinking 블록에서 풀고 확인한다 — 쪽지 : [thinking] 7일 이내 맞음 / 미개봉 맞음 / 할인 상품 아님
- 건너뜀 : 코드 검사
- 답 : 모델 → 결과 : 답은 text 블록에 쓴다 — 말 : “환불 가능해요.”
- 끝 : 다단계 추론은 대부분 한 요청 안에서 처리한다
② 중간 출력을 보려면 체이닝 ✓
- 시작 : 요청 — 말 : “주문 1042 환불돼요? / 규정 3개와 대조”
- 호출 1 : 요청 → 모델 : 1단계만 호출한다 — 쪽지 : 초안: 대조표 / 7일 · 미개봉 · 정가
- 검사 : 모델 → 코드 검사 : 중간 출력을 검사한다 — 쪽지 : 규정 3개 다 있음 / 통과
- 호출 2 : 코드 검사 → 모델 : 통과한 것만 다음 단계로 간다 — 쪽지 : 2단계: 대조표로 판정
- 답 : 모델 → 결과 : 판정한다 — 말 : “환불 가능해요.”
- 끝 : 지연을 감수하고 정확도를 얻는다
③ 추론을 답 글에 쓰라고 한다 ≠
- 시작 : 요청 — 말 : “주문 1042 환불돼요? / 판단 과정도 답에 다 적어 줘”
- 요청 : 요청 → 모델 : 답 글에 추론을 쓰라고 한다 — 쪽지 : model: Opus 5.5 / "단계별 생각을 답에"
- 거절 : 모델 : reasoning_extraction 으로 거절될 수 있다 ≠ — 쪽지 : 거절 / 사유: reasoning_extraction
- 끝 : 추론은 thinking 블록에서 읽는다
규칙 원문 갈림 기준 (갈림길로 그린 규칙)
갈림 기준
중간 출력을 봐야 하나를 먼저 본다
- 다단계 추론 자체는 thinking 으로 한다. adaptive thinking 과 서브에이전트로 한 요청 안에서 대부분 처리한다. 풀이는 thinking 블록에, 답은 text 블록에 나온다
- 중간 출력을 검사하거나 파이프라인 구조를 강제해야 하면 명시적 체이닝(순서대로 따로 호출)을 쓴다
- 가장 흔한 모양은 초안을 쓰고, 기준으로 검토하고, 고치는 것이다. 단계마다 기록·평가·분기를 한다
- 언제 호출을 나누나는 ■ decomposition 단위 정하기 에 있다. 패턴 본문은 ■ 워크플로 5패턴 에 있다
- thinking 을 꺼 뒀으면 수동 CoT 를 쓴다. "생각해 보라"고 요청한다.
<thinking>·<answer>태그로 추론과 답을 분리한다 - 단 Opus 5 는 thinking 을 끄지 말고 낮은 effort 로 켜 둔다. 끄면 내부 XML 태그와 도구 호출이 답 글에 샐 수 있다 (Opus 5 = 2026-07-24 출시, 시험 뒤 변경 가능)
- thinking 을 켜 둔 채 "step by step" 계획을 손으로 쓸 필요는 없다. 손으로 쓴 단계 계획보다 "think thoroughly" 같은 일반 지시가 나을 때가 많다
- 추론을 보고 싶으면 답 글로 추론을 요구하지 않는다. thinking 블록을 읽는다
- 새 모델은 display 기본값이 "omitted"(빈 칸)이다. "summarized" 로 켠다
- Fable 5.1·Opus 5.5·Fable 5 에서 답 글로 내부 추론을 끌어내려 하면 reasoning_extraction 으로 거절될 수 있다 (Fable 5 는 2026-06-09 부터. Fable 5.1·Opus 5.5 는 시험 뒤 출시 · 출력 전 거절도 청구는 2026-09-24~ — 시험 뒤 변경)
깊이 조절 : thinking 이 과하면 effort 를 먼저 낮춘다. 프롬프트 조정은 그다음이다. 모자라면 effort 를 올린다. 자세한 것은 ■ 모델별 thinking 제어 에 있다
비용 : thinking 토큰은 출력 토큰 단가로 청구된다. 안 보여도 청구된다
- 체이닝은 지연(latency)을 감수하고 정확도를 얻는다
- 그래서 둘 다 공짜가 아니다
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
| 다단계 추론이다. 중간 확인이 필요 없다. thinking 이 켜져 있다 | thinking 을 쓴다 (한 요청) | prompting-best-practices "With adaptive thinking and subagent orchestration, Claude handles most multistep reasoning internally." |
| 중간 출력을 검사하거나 파이프라인 구조를 강제해야 한다 | 명시적 체이닝을 쓴다 | prompting-best-practices "is still useful when you need to inspect intermediate outputs or enforce a specific pipeline structure." |
| 일이 고정 하위 작업으로 깔끔히 나뉜다. 정확도가 지연보다 중요하다 | 체이닝을 쓴다 | building-effective-agents "trade off latency for higher accuracy" |
| thinking 이 꺼져 있다 | 수동 CoT 와 <thinking>·<answer> 태그를 쓴다 | prompting-best-practices |
| Opus 5 에서 thinking 비용을 줄이고 싶다 | 끄지 말고 낮은 effort 로 켜 둔다 | prompting-best-practices · thinking-troubleshooting |
| 추론 과정을 보고 싶다 | thinking 블록을 읽는다 (display "summarized") | thinking |
| thinking 을 더 깊게 하고 싶다 | 일반 지시("think thoroughly")를 쓰거나 effort 를 올린다 | prompting-best-practices · thinking |
| thinking 이 너무 잦다 | effort 를 먼저 낮춘다. 그다음 프롬프트를 고친다 | thinking-steering-and-cost |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 중간 결과 | 사람이 확인해야 한다 (예 : 조항을 추출하고, 사람이 승인하고, 위험을 판정한다) | 체이닝을 쓴다 | 판단 규칙 2 | |
| 중간 결과 | 아무도 안 본다 | thinking 을 쓴다 | 판단 규칙 1 | |
| 긴 프롬프트 | 모델이 일부 제약을 계속 무시한다 | 생성하고 고치는 2단계 체이닝을 쓴다 | Skilljar 287800 · ■ decomposition 단위 정하기 | |
| 모델 | Fable 5.1 · Fable 5 · Opus 5.5 (항상 켜져 있다) | thinking 은 기본이다. 수동 CoT 로 답 글에 추론을 쓰게 하면 거절될 수 있다 | thinking | |
| 모델 | Sonnet 5 · Opus 5 (기본으로 켜져 있고, 끌 수 있다) | 켜 둔 채 effort 로 조절한다 | thinking | |
| 모델 | Haiku 4.5 · Sonnet 4.5 (기본으로 꺼져 있고, extended thinking 만 있다) | thinking 을 켜려면 budget_tokens 를 쓴다. 안 켜면 수동 CoT 를 쓴다 | thinking-troubleshooting · prompting-best-practices | |
| 도구 사용 | 도구 결과를 보고 다음 행동을 정한다 | thinking 을 쓴다 (interleaved, adaptive 면 자동). 체이닝은 필요 없다 | thinking. 단 Haiku 4.5 는 interleaved thinking 이 없다 | |
| 지연 | 요구가 엄격하다 | thinking 쪽(호출 1번)에서 effort 를 낮춘다 | 계산 | 체이닝은 호출이 순서대로 쌓인다 (뒤집히는 때 1) |
연습 문제
환불 가능 여부를 규정 3개와 대조해 판정하는 흐름이다. 대조표 초안이 규정을 빠짐없이 담았는지 확인한 뒤에만 판정 단계로 간다중간 출력 검사. 한 팀원은 "Opus 5.5 는 thinking 이 늘 켜져 있으니 한 요청으로 끝내자"고 한다. 어떻게 짤까?
시험 대비
함정
- "체이닝으로 나누면 더 빠르고 싸다" 는 함정이다. 체이닝은 지연을 감수하고 정확도를 얻는다
- "단계가 여러 개면 무조건 체이닝이다" 는 함정이다. 대부분은 한 요청 안에서 처리한다. 체이닝은 중간 검사나 구조 강제가 필요할 때 쓴다
- "thinking 을 켜 놓고 프롬프트에 단계 계획을 길게 쓴다" 는 함정이다. 일반 지시가 나을 때가 많다
- "추론을 보려고 '생각 과정을 답에 써라' 고 한다" 는 함정이다. thinking 블록을 읽는다. 새 모델은 이 요청을 거절할 수 있다
- "thinking 블록이 빈 칸이면 thinking 을 안 한 것이다" 는 함정이다. display 기본값이 "omitted" 다. 추론은 signature 에 담겨 있다. 이 블록은 그대로 돌려준다
- "thinking 없는 턴이 있으면 설정 오류다" 는 함정이다. adaptive 는 단순한 요청에서 thinking 을 건너뛴다. 이것은 정상이다
- Skilljar(2025 제작)는 "thinking 없이 먼저, 프롬프트를 다듬어도 정확도가 모자라면 켠다" 고 한다. 평가로 정한다는 원칙은 맞다. 그러나 지금은 새 모델 다수가 기본으로 켜져 있다. 못 끄는 모델도 있다 (Skilljar)
신호
"With adaptive thinking and subagent orchestration, Claude handles most multistep reasoning internally."
"Explicit prompt chaining (breaking a task into sequential API calls) is still useful when you need to inspect intermediate outputs or enforce a specific pipeline structure."
"When thinking is off, you can still encourage step-by-step reasoning by asking Claude to think through the problem."
"A prompt like \"think thoroughly\" often produces better reasoning than a hand-written step-by-step plan."
"The main goal is to trade off latency for higher accuracy, by making each LLM call an easier task."
"To see the model's reasoning, read the thinking blocks rather than prompting for reasoning in the response text."
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
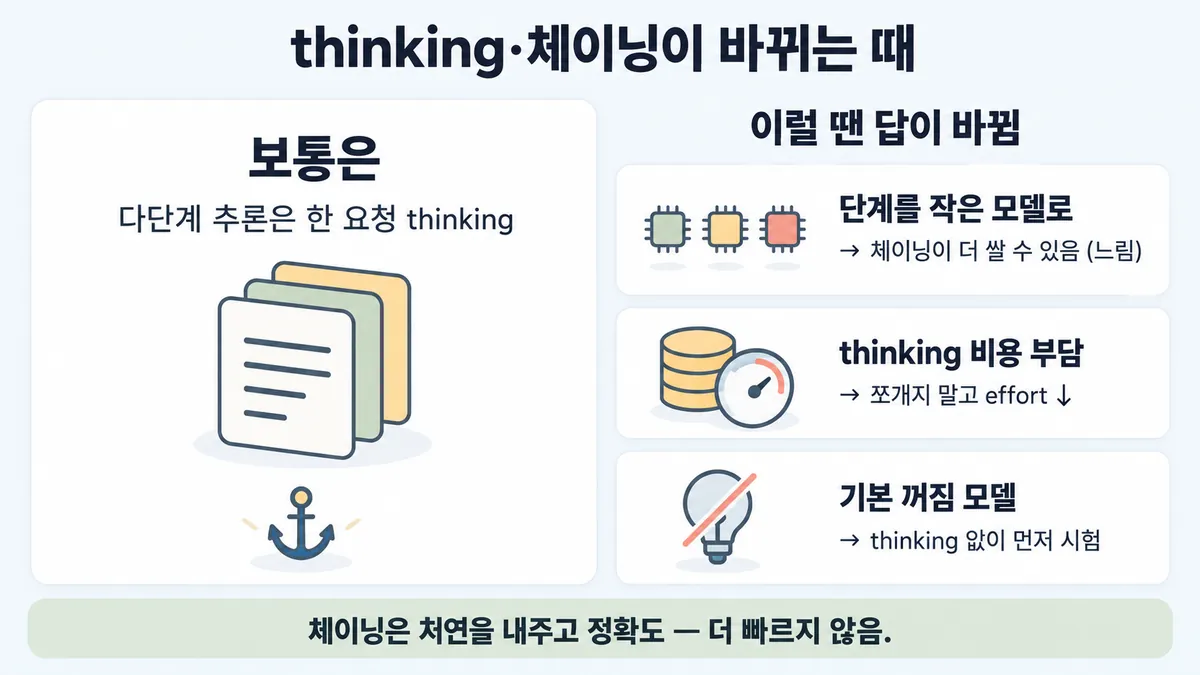
1. 체이닝이 오히려 싼 때 — 단계를 작은 모델로
- 조건 : 큰 모델에서 한 요청과 thinking 으로 돌리던 일이 있다. 이 일을 체이닝으로 나눠 단계마다 작은 모델로 돌린다.
- 계산 : 입력 1만, thinking 과 답 출력 3천을 Opus 5.5($4 / $20, 백만 토큰당)로 한 번 돌린다. 비용은 1만 × $4 + 3천 × $20 = $0.04 + $0.06 = $0.10 이다. 3단계 체이닝을 Haiku 4.5($1 / $5)로 돌리고 단계마다 입력 1만 · 출력 800 이면, 비용은 3 × (1만 × $1 + 800 × $5) = 3 × ($0.010 + $0.004) = $0.042 이다.
- 전제 : 아래 세 가지다.
- 단계마다 같은 입력 1만을 다시 보낸다(캐시 없음).
- 작은 모델로도 eval 상 품질이 유지된다.
- 가격은 2026-09-28 조회값이다.
- 판단 : "체이닝은 늘 비싸다" 도 틀리다. 비용은 호출 수보다 모델 단가가 좌우한다. 단 지연은 호출 3번이 순서대로 쌓인다. 그래서 "체이닝이 더 빠르다" 는 여전히 틀리다.
- 등급 : 계산 (단가 확인). 공식 근거는 한 문장이다. 여러 프롬프트로 나눈 대화 흐름은 지연을 위해 Haiku 4.5 가 더 맞을 수 있다고 한다.
- 근거 : ko-pricing 표 · customer-support-chat · building-effective-agents
2. thinking 을 못 끄는 모델에서 "생각이 비싸니 쪼개자"
- 조건 : Opus 5.5 에서 thinking 토큰 비용이 부담이다. 그래서 일을 체이닝으로 나눈다.
- 판단 : 쪼개도 호출마다 thinking 이 또 켜진다(항상 켜져 있다). thinking 비용을 줄이는 lever(조절 수단)는 체이닝이 아니라 effort 를 낮추는 것이다. Opus 5.5 기본값은 이미 medium 이다. 체이닝은 중간 검사가 필요할 때만 쓴다.
- 등급 : (못 끈다 · effort 가 주 lever 다) + 추론 (쪼개도 thinking 이 줄지 않을 것이다)
- 근거 : effort en-2026-09-28 · thinking
3. 수동 CoT 가 역효과인 때
- 조건 : 옛 프롬프트의 "먼저 단계별 생각을 답에 적어라"를 새 모델에 그대로 가져온다.
- 판단 : Fable 5.1·Opus 5.5·Fable 5 는 답 글로 내부 추론을 끌어내려는 요청을 거절할 수 있다. Opus 5 는 thinking 을 끄고 수동 CoT 를 쓰면 내부 XML 태그가 답에 샐 수 있다. 그래서 켜 둔 채 낮은 effort 로 둔다. 수동 CoT 는 "thinking 이 꺼진" 모델의 대안일 뿐이다.
- 근거 : thinking · prompting-best-practices · thinking-troubleshooting
- 시험 뒤 변경 reasoning_extraction 거절은 Fable 5 에서 2026-06-09 부터 있었다(시험 전). Fable 5.1(2026-09-01) · Opus 5.5(2026-09-22) · Opus 5(2026-07-24) 는 시험 뒤에 출시됐다. 출력 전에 나온 이 거절도 청구되는 것은 2026-09-24 부터다. 시험이 옛 모델 기준이면 수동 CoT 보기가 맞을 수 있다. 그러니 문항의 모델 이름을 확인한다.
- 근거 추가 : 릴리스 노트
4. Skilljar "thinking 없이 먼저" 순서
- 조건 : 지문이 "정확도가 모자라다, 무엇부터?"를 묻는다.
- 판단 : Skilljar(2025)는 thinking 없이 먼저 돌리라고 한다. 프롬프트를 다듬어도 모자랄 때 켜라고 한다. 지금 docs 에서는 새 모델 다수가 기본으로 켜져 있다. 지문의 모델이 기본으로 꺼져 있으면(4.6~4.8·4.5 이하) Skilljar 순서가 그대로 맞다. 항상 켜져 있는 모델이면 "켤지"가 아니라 effort 로 깊이를 고르는 문제다.
- 등급 : (양쪽 문장) · 결합은 추론
- 근거 : Skilljar 287773 · thinking-troubleshooting
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 근거 |
|---|---|---|---|
| "체이닝으로 나누면 더 빠르고 싸다" | 작은 일로 나누면 가벼워 보인다 | 체이닝은 지연을 감수하고 정확도를 얻는다. 호출이 순서대로 쌓인다 | building-effective-agents (목록 매력적인 오답) |
| "여러 단계면 무조건 체이닝" | 단계 하나를 호출 하나로 생각한다 | 최신 모델은 한 요청 안에서 대부분 처리한다. 체이닝은 중간 검사나 구조 강제가 필요할 때 쓴다 | prompting-best-practices |
| "thinking 켠 채 프롬프트에 단계별 계획을 촘촘히" | 자세할수록 좋아 보인다 | 손으로 쓴 단계 계획보다 일반 지시가 나을 때가 많다 | prompting-best-practices |
| "추론을 보려고 답에 생각 과정을 쓰게 한다" | 옛 CoT 습관이다 | thinking 블록을 읽는다. 새 모델은 거절될 수 있다 | thinking |
| "thinking 블록이 비어 있으니 thinking 을 안 했다" | 빈 칸이면 안 한 것으로 보인다 | 새 모델은 display 기본값이 "omitted" 다. 추론은 signature 에 있다 | thinking-troubleshooting |
| "어떤 턴에 thinking 이 없으니 설정 버그" | 매 턴 thinking 한다고 가정한다 | adaptive 는 단순한 요청에서 thinking 을 건너뛴다. 이것은 정상이다 | thinking-troubleshooting |
| "Opus 5 는 thinking 끄고 수동 CoT 로 싸게" | 끄면 싸 보인다 | 끄면 내부 태그와 도구 호출이 답에 샐 수 있다. 켜 둔 채 낮은 effort 로 둔다 | prompting-best-practices |
| "사람 확인이 필요한 파이프라인을 thinking 한 요청으로" | 한 요청이 단순해 보인다 | 중간 출력을 사람이 봐야 하면 체이닝을 쓴다 | prompting-best-practices |
참고
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 2.3 공식 시험 가이드 v1.0
- prompting-best-practices
- thinking
- thinking-steering-and-cost
- thinking-troubleshooting
- building-effective-agents
- 릴리스 노트
- Skilljar API 287773
상태
- Skilljar
- 시험 뒤 변경 2곳(Opus 5 끄기 · 새 모델 추론 추출 거절)
미해결
- 체이닝의 지연 증가 폭 : 공식은 "latency 를 내준다"고만 한다. 몇 배인지는 숫자가 없다.
- 목록 2.3② 의 영상 대조 "Opus 5.5 는 adaptive thinking 을 끌 수 없음(thinking disabled = 400)"은 맞다(effort en-2026-09-28). 목록 정답 규칙의 "수동 step by step 은 thinking 이 꺼져 있을 때의 대안" 도 맞다(prompting-best-practices). 고친 곳은 없다.