■ AI 코드 리뷰
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 7.2 개발 흐름 개선 · D7 개발팀 7%Improve developer workflows using AI-assisted tooling
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 7.2③ AI 코드 리뷰, 무엇을 보고시키고 어떻게 넓히나? — 리뷰 지시(전부 보고 → 뒤에서 거르기)와 도입 확대 방식
한눈에
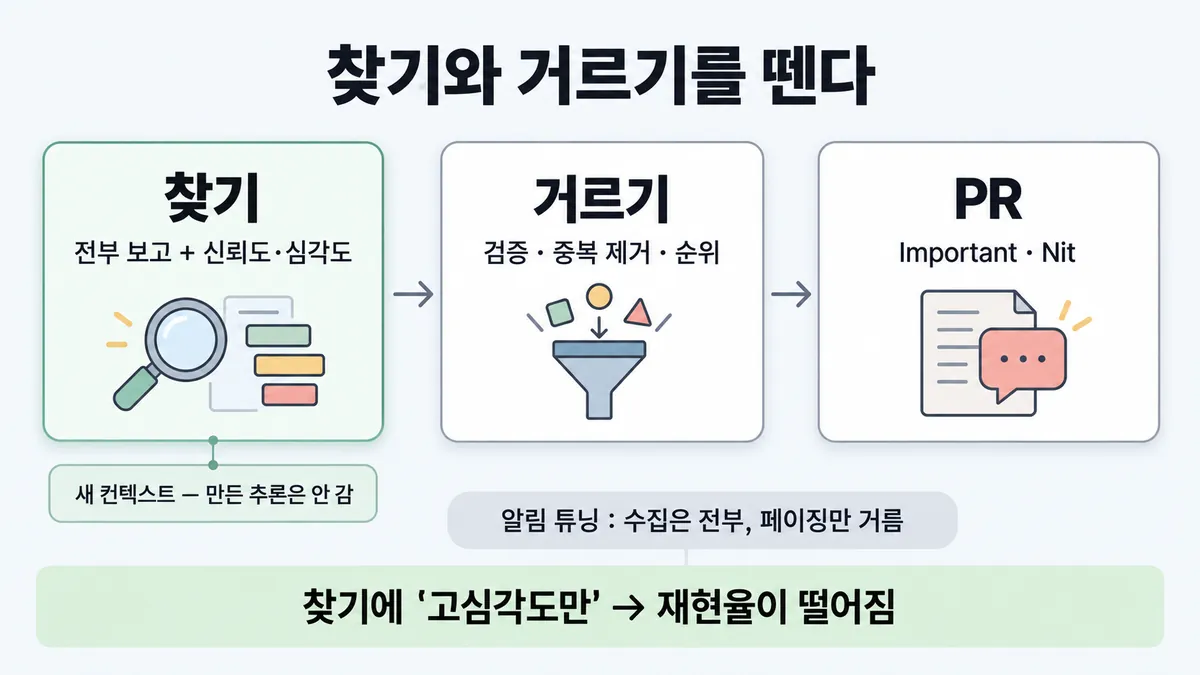
찾기와 거르기를 뗀다. 찾는 단계는 불확실·저심각도까지 전부 보고한다(커버리지). 거르기(검증 · 중복 제거 · 순위)는 뒤 단계가 한다
리뷰는 코드를 만든 컨텍스트가 아니라 새 컨텍스트가 한다. 그래서 방금 쓴 코드에 치우치지 않는다
비유 알림 튜닝(Alertmanager)과 같다. 수집은 전부 하고 라우팅 규칙으로 페이징만 거른다. "알림 줄이려면 수집 임계치를 올린다" 가 속이는 습관이다. 그러면 놓치는 장애가 늘어난다
ELI5
물고기를 잡을 때 촘촘한 그물로 다 건진 다음, 배 위에서 골라내는 거예요.
- 그물코를 처음부터 크게 하면 작은 물고기는 빠져나가요.
- 그러면 "요즘 고기가 없네" 하고 착각해요.
- 고르는 일은 배 위에서, 다른 사람이 하면 더 공정해요.
- 바다 전체에 한꺼번에 그물을 던지기 전에, 몇 군데서 먼저 해 봐요.
개념 설명
원리
찾기와 거르기는 다른 일이다
- 찾기의 목표는 커버리지(재현율)다. 거르기의 목표는 정밀도다. 한 프롬프트에 둘을 섞으면 모델이 거르기 기준을 찾기에 적용한다.
- Opus 4.8 은 지시를 글자 그대로 따르는 쪽이다(prompting-claude-opus-4-8). 그래서 "고심각도만" · "보수적으로" 가 있으면 버그를 찾아 놓고도 기준 아래라 판단한 것은 보고하지 않는다. 조사 깊이는 같은데 보고만 준다. 그래서 정밀도는 오르고 재현율이 떨어진다. 모델이 약해진 것이 아니라 하네스 효과다.
- 처방 : 찾기는 전부 보고하고, 발견마다 신뢰도·추정 심각도를 붙인다. 뒤 단계(검증 · 중복 제거 · 순위)가 거른다. 뒤 단계가 없으면 판정선을 구체적으로 쓴다.
새 컨텍스트
- 코드를 만든 세션은 "왜 그렇게 짰나" 를 들고 있다. 그래서 자기 코드에 치우친다. 새 세션·서브에이전트는 diff 와 넘겨받은 기준만 보고 제 기준으로 평가한다.
"전부 보고" 와 "정확성만 표시" 는 충돌하지 않는다
- 찾기 단계(뒤에 필터가 있다)에서는 전부 보고한다.
- 리뷰 결과를 구현자가 바로 받아 고칠 때(필터가 없다)는 정확성·명시 요구에 영향 주는 공백만 표시한다. 나머지는 선택이다. 그러지 않으면 과설계가 된다.
- 즉 "보고 기준" 은 그 출력을 다음에 누가 받나 로 정한다. (두 공식 문장을 이어 읽은 해석이다. 업계 일반)
관리형 Code Review 는 위 구조의 제품판이다
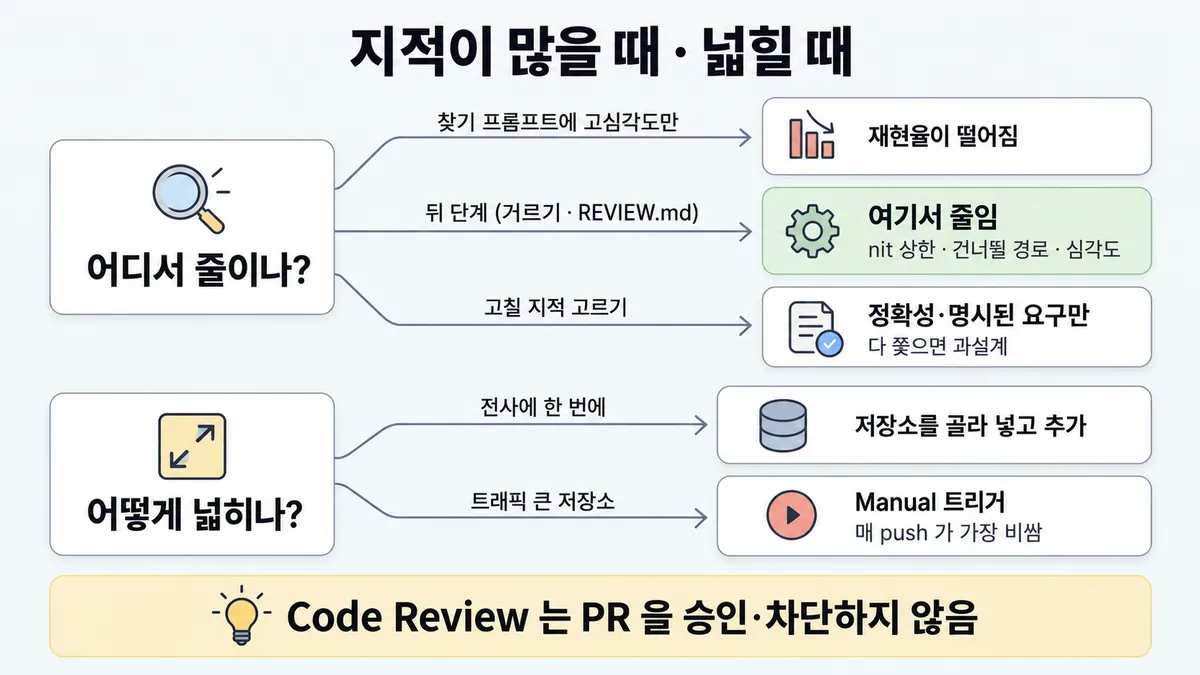
- 흐름은 아래와 같다. 승인·차단은 하지 않는다(사람 몫이다).
- 종류별 에이전트가 병렬로 찾는다
- 실제 코드 동작과 대조해 검증한다
- 중복을 뺀다
- 심각도 순위를 매긴다
- 인라인 코멘트를 단다
- 기본은 정확성이다.
REVIEW.md로 심각도·nit 상한·건너뛸 경로·검증 기준을 저장소마다 조정한다.
넓히기
- Owner 가 저장소를 골라 넣고 나중에 추가한다. 저장소별로 on/off 한다. 트리거는 3가지다(1회 / 매 push / Manual).
- 비용은 리뷰 수에 비례한다. 그래서 트리거와 저장소 수가 비용 lever(조절 수단)다.
규칙과 판단
갈림길
①② 보고 지시 [7.2③]
전부 보고한다
불확실·저심각도까지 전부 보고하고, 발견마다 신뢰도·추정 심각도를 붙인다. 찾기의 일은 커버리지다. 두 번째 단계가 실제로 없어도 도움이 된다
판정선을 구체적으로 쓴다
'중요한' 같은 두루뭉술한 말 대신 "잘못된 동작 · 테스트 실패 · 오해 부르는 결과는 전부, 순수 스타일·네이밍만 생략" 처럼 쓴다
①④⑤ 지적이 너무 많다 [7.2③]
재현율이 떨어진다
조사는 똑같이 하고 기준 아래 발견은 보고하지 않는다
REVIEW.md)
여기서 줄인다
nit 개수 상한 · 건너뛸 경로 · 심각도 재정의 · 검증 기준으로 줄인다
정확성·명시된 요구만 고친다
나머지는 선택이다. 다 쫓으면 과설계가 된다
⑥ 넓히기 [7.2③]
골라 넣고 추가한다
Owner 가 저장소를 골라 넣고 나중에 추가한다. 저장소별로 on/off 한다. 리뷰당 평균은 $15~25 다 (시범, 측정, 확대 순서 자체는 업계 일반)
Manual
매 push 가 가장 비싸다. 트래픽 큰 저장소는 Manual 로 둔다
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 작성 → 찾기 → 거르기 → PR
규칙 (찾기) : 찾기의 일은 커버리지다
규칙 (거르기) : 검증 · 중복 제거 · 순위
질문 : 지적은 어디서 걸러야 할까?
① 전부 보고하고 뒤에서 거르기 ✓
- 시작 : 작성 — 쪽지 : diff:
retry.ts+12 −3 - 넘기기 : 작성 → 찾기 : diff 와 넘겨받은 기준만 간다 — 쪽지 : diff + 기준: 정확성 / (만든 추론은 안 감)
- 찾기 : 찾기 → 거르기 : 전부 보고하고 신뢰도·심각도를 붙인다 — 쪽지 : #1 무한 재시도 · 높음 · 0.9 / #2 타임아웃 누락 · 중간 · 0.6 / #3 #1 과 같음 · 0.4 / #4 변수명 · 낮음 · 0.3
- 거르기 : 거르기 → PR : 검증하고 중복을 빼고 순위를 매긴다 — 쪽지 : Important #1 무한 재시도 / Important #2 타임아웃 누락 / Nit #4 변수명 / #3 중복 → 뺌
- 끝 : 커버리지는 찾기에서 챙긴다. 거르기는 뒤 단계에서 한다. #2 도 PR 에 남는다
② 찾기에 "고심각도만" ≠
- 시작 : 작성 — 쪽지 : diff:
retry.ts+12 −3 - 넘기기 : 작성 → 찾기 : 기준에 "고심각도만" 을 넣는다 — 쪽지 : diff + 기준: / "only report / high-severity issues"
- 찾기 : 찾기 : 기준 아래는 보고하지 않는다 — 쪽지 : 조사: 4건 찾음 / 보고: #1 만
- 넘기기 : 찾기 → 거르기 : 보고가 줄어든다 — 쪽지 : #1 무한 재시도 · 높음
- 거르기 : 거르기 → PR : 거를 것이 1건뿐이다 — 쪽지 : Important #1 무한 재시도
- 끝 : 정밀도는 오르고 재현율은 떨어진다. #2 타임아웃 누락은 PR 에 없다
③ 만든 세션의 자기 리뷰 ≠
- 시작 : 작성 — 쪽지 : diff:
retry.ts+12 −3 / + 방금 쓴 추론 - 리뷰 : 작성 : 방금 쓴 코드에 치우친다 — 말 : “제가 쓴 대로 잘 동작해요.”
- 건너뜀 : 찾기
- 끝 : 새 컨텍스트(다른 세션·서브에이전트)가 리뷰해야 방금 쓴 코드에 치우치지 않는다
나머지 규칙
-
새 컨텍스트 : 방금 쓴 코드에 치우치지 않게 다른 세션(Writer/Reviewer)이나 서브에이전트가 리뷰한다
리뷰어는 diff 와 넘겨받은 기준만 본다. 변경을 만든 추론(reasoning)은 보지 못한다. 그래서 결과를 제 기준으로 평가한다
리뷰 지시에는 아래를 넣는다
- 점검할 작업
- 대조할 계획
- 무엇이 finding 인지
규칙 원문 ①②④⑤⑥ (갈림길로 그린 규칙)
-
찾기 = 커버리지 : 리뷰 프롬프트에 "only report high-severity issues" · "be conservative" · "don't nitpick" 이 있으면, Opus 4.8 은 이전 모델보다 더 충실히 따를 수 있다. 그러면 조사는 똑같이 하고도 기준 아래 발견은 보고하지 않는다. 그래서 정밀도는 오르고 재현율은 떨어진다
처방은 불확실·저심각도까지 전부 보고하는 것이다. 발견마다 신뢰도·추정 심각도를 붙이고, 뒤 필터가 순위를 매긴다. 두 번째 단계가 실제로 없어도 도움이 된다. 두 번째 단계가 있으면 "찾기의 일은 커버리지" 라고 명시한다 (Opus 4.8 프롬프트 가이드) [7.2③]
-
한 번에 거를 때 : 판정선을 구체적으로 쓴다. '중요한' 같은 두루뭉술한 말은 쓰지 않는다. "잘못된 동작 · 테스트 실패 · 오해 부르는 결과는 전부, 순수 스타일·네이밍만 생략" 처럼 쓴다
고친 프롬프트는 eval·테스트 케이스 일부로 돌린다. 그래서 재현율·F1 이 실제로 올랐는지 본다
-
리뷰어는 찾으라면 찾는다 : 멀쩡해도 무언가를 보고한다. 그것을 전부 쫓으면 과설계가 된다(추상화 층 · 방어 코드 · 일어날 수 없는 경우의 테스트). 정확성·명시된 요구에 영향 주는 공백만 표시한다. 나머지는 선택이다
-
관리형 Code Review : 이 구조를 그대로 쓴다
- 여러 에이전트가 종류별로 병렬로 찾는다
- 검증 단계가 실제 코드 동작과 대조해 오탐(false positive)을 거른다
- 중복을 뺀다
- 심각도 순위를 매긴다(🔴 Important = 머지 전 고칠 버그 · 🟡 Nit)
- 인라인 코멘트를 단다
기본은 정확성(프로덕션을 깨는 버그) 중심이다. 스타일·테스트 커버리지 중심이 아니다. PR 을 승인하거나 차단하지 않는다. check run 은 늘 neutral 이다. 게이트는 내 CI 가 check run 출력을 읽어서 만든다
조정은 리뷰 전용 파일
REVIEW.md로 한다. 아래를 정할 수 있다- 심각도 재정의
- nit 개수 상한
- 건너뛸 경로
- 저장소 고유 검사
- 검증 기준
- 재리뷰 때 nit 억제
CLAUDE.md위반은 nit 로 본다로컬
/code-review의 effort 는 둘로 나뉜다.low·medium은 확신 높은 것만 낸다(오탐↓).high~max는 커버리지를 올린다(커버리지↑) (2026-09-28 조회) -
넓히기 : Owner 가 조직에 한 번 켜고 저장소를 골라 넣는다. 나중에 추가한다. 저장소별로 on/off 한다
트리거는 셋이다
- PR 생성 1회
- 매 push
- Manual(
@claude review)
매 push 가 가장 비싸다. 트래픽 큰 저장소는 Manual 로 둔다
리뷰당 평균은 $15~25 다. 월 지출 상한을 설정할 수 있다 (2026-09-28 조회)
가치 높은 흐름 몇 개로 시범을 한다. 그다음 측정하고 확대한다 업계 일반 공식은 저장소 선택·추가·트리거 lever 만, 시범 개수 없음
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
| 찾기 단계 뒤에 검증·중복 제거·순위가 있다 | 불확실·저심각도까지 전부 보고하고 신뢰도·추정 심각도를 붙인다 | prompting-claude-opus-4-8 "Report every issue you find, including ones you are uncertain about or consider low-severity." |
| 한 번에 거르기를 원한다 | '중요한' 대신 판정선을 구체적으로 쓴다 | prompting-claude-opus-4-8 "be concrete about where the bar is rather than using qualitative terms like "important"" |
| 리뷰 프롬프트를 고쳤다 | eval·테스트 케이스 일부로 재현율·F1 을 확인한다 | prompting-claude-opus-4-8 |
| 방금 쓴 코드를 리뷰한다 | 다른 세션·서브에이전트(새 컨텍스트)가 리뷰한다 | best-practices "A fresh context improves code review since Claude won’t be biased toward code it just wrote." |
| 리뷰어 지적을 받아 고칠 차례다 | 정확성·명시 요구에 영향 주는 것만 고친다. 나머지는 선택이다 | best-practices |
| PR 마다 자동 리뷰하고, 워크플로는 유지하지 않는다 | 관리형 Code Review 를 쓴다 | code-review · github-actions |
| 저장소마다 기준이 다르다(문서·설정·프로토타입) | REVIEW. 로 심각도 재정의·nit 상한·건너뛸 경로를 정한다 | code-review |
| 리뷰로 머지를 막고 싶다 | check run 출력을 내 CI 가 읽어 게이트로 쓴다 | code-review |
| 트래픽 큰 저장소다 | Manual 트리거(@claude review)로 골라 리뷰한다 | code-review |
상황 변수
| 변수 | 값 | 답 쪽 | 근거 |
|---|---|---|---|
| 뒤 단계 | 있다 | 찾기는 커버리지를 맡는다 | prompting-claude-opus-4-8 |
| 뒤 단계 | 없다 · 결과가 곧장 사람에게 간다 | 구체적 판정선과 nit 개수 상한을 쓴다 | prompting-claude-opus-4-8 · code-review |
| 모델 | 옛 모델용 하네스에 새 모델을 쓴다 | 재현율이 처음엔 낮아 보일 수 있다. 보수적 문구를 걷어낸다 | prompting-claude-opus-4-8 |
로컬 /code- effort | low·medium | 확신 높은 것만 낸다(오탐(false positive)↓) | code-review |
로컬 /code- effort | high~max | 커버리지↑ · 덜 확실한 것도 낸다 | code-review |
| 트리거 | 매 push | 리뷰 수 = push 수다. 그래서 가장 비싸다 | code-review |
| 트리거 | PR 생성 1회 · Manual | 비용이 작다. Manual 은 요청한 것만 리뷰한다 | code-review |
| 조직 | ZDR 을 켰다 · Team·Enterprise 가 아니다 | 관리형 Code Review 를 쓸 수 없다. Actions 워크플로나 로컬 /code- 를 쓴다 | code-review · github-actions |
| 규칙 위치 | CLAUDE. 에만 있다 | 관리형 리뷰는 위반을 nit 로만 본다. 로컬 /code- 는 REVIEW. 를 읽지 않는다 | code-review |
연습 문제
결제팀 리뷰 파이프라인은 찾기 에이전트 뒤에 검증 · 중복 제거 · 심각도 순위를 매기는 단계뒤 거르기 가 따로 있다. "PR 코멘트가 너무 많다" 는 불평에 팀장은 찾기 프롬프트에 "only report high-severity issues" 를 넣자고 한다. 찾기 에이전트에게는 무엇을 지시해야 하나?
시험 대비
함정
- "지적이 많으니 찾기 프롬프트를 '고심각도만' 으로 바꾼다" 는 함정이다. 재현율이 떨어진다. 거르기는 뒤 단계에서 한다
- "'중요한 것만' 보고한다" 는 함정이다. 두루뭉술한 말이다. 판정선을 구체적으로 쓴다
- "코드를 쓴 세션에 '스스로 다시 검토해' 라고 한다" 는 함정이다. 방금 쓴 코드에 치우친다. 새 컨텍스트가 리뷰한다
- "리뷰어 지적은 전부 고친다" 는 함정이다. 과설계가 된다. 정확성·명시된 요구만 고친다
- "Code Review 로 머지를 막는다" 는 함정이다. Code Review 는 승인·차단을 하지 않는다. 게이트는 내 CI 가 check run 출력을 읽어서 만든다
- "새 모델로 바꿨더니 지적이 줄었으니 모델이 퇴보했다" 는 함정이다. 옛 모델용 '보수적' 지시를 더 충실히 따른 하네스 효과일 가능성이 있다
- "전사에 한 번에 켠다" 는 함정이다. 저장소를 골라 넣고 추가한다 (업계 일반 + 비용)
신호
"Report every issue you find, including ones you are uncertain about or consider low-severity."
"Do not filter for importance or confidence at this stage - a separate verification step will do that."
"be concrete about where the bar is rather than using qualitative terms like "important""
"A fresh context improves code review since Claude won’t be biased toward code it just wrote."
"Tell the reviewer to flag only gaps that affect correctness or the stated requirements, and treat the rest as optional."
"a verification step checks candidates against actual code behavior to filter out false positives."
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
1. "전부 보고" 가 오히려 틀릴 때
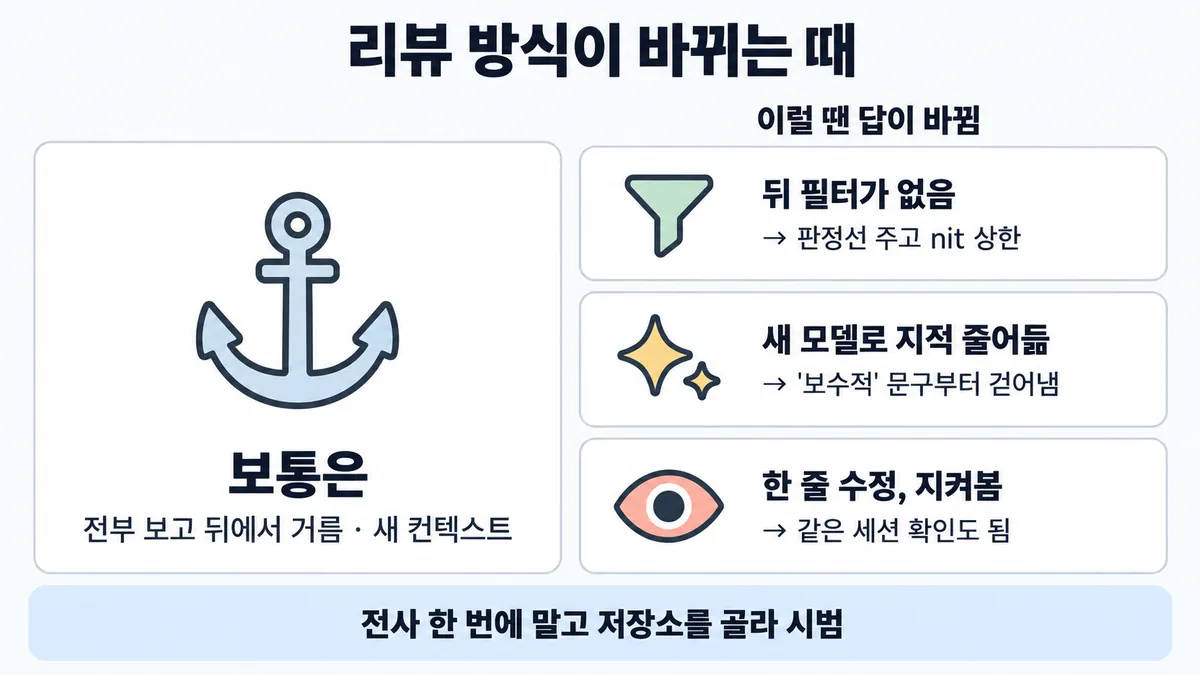
- 조건 : 거르기 단계가 없다. 리뷰 결과가 PR 코멘트로 곧장 작성자에게 간다.
- 판단 : 뒤 필터가 없으면 전부 보고는 코멘트 홍수가 된다. 공식도 "두 번째 단계 없이도 쓸 수 있다" 고 했다. 하지만 같은 글의 다음 문장은 한 번에 거를 거면 판정선을 구체적으로 주라고 한다. 관리형 Code Review 를 쓰면 필터가 제품 안에 있다. 그래서
REVIEW.md로 nit 상한(예 "많아야 5개, 나머지는 개수만")을 건다. - 근거 : prompting-claude-opus-4-8 · code-review
2. 모델을 올렸더니 지적이 줄었음
- 조건 : 리뷰 봇을 새 모델로 바꾼 뒤 주당 지적 수가 크게 줄었다. 팀은 "새 모델이 버그를 덜 찾는다" 고 본다.
- 판단 : 옛 모델에 맞춘 "보수적으로" · "고심각도만" 을 새 모델이 더 충실히 따른 하네스 효과일 가능성이 있다. 먼저 그 문구를 걷어내고 전부 보고와 뒤 필터로 바꾼다. 그 뒤 같은 eval 부분집합으로 재현율을 다시 잰다. 모델 되돌리기가 첫 수가 아니다.
- 근거 : prompting-claude-opus-4-8
3. 한꺼번에 켜면 얼마나 드나 — 시범이 이기는 계산
- 조건 : 두 안을 비교한다.
- 시범 : 저장소 3개 · 저장소당 월 PR 60건 · "PR 생성 1회" 트리거
- 전사 : 저장소 25개 · 같은 PR 수 · "매 push" 트리거 · PR 당 평균 push 4회
- 계산 : 시범은 3 × 60 = 180 리뷰 × $15~25 = 월 $2,700~4,500 이다. 전사는 25 × 60 × 4 = 6,000 리뷰 × $15~25 = 월 $90,000~150,000 이다(약 33배).
- 전제 : 아래를 가정한다.
- 리뷰당 비용을 공식 평균 $15~25 로 고정한다. 실제는 PR 크기·복잡도·검증할 이슈 수에 비례한다. push 뒤 리뷰는 더 작을 수 있다
- 저장소별 PR 수는 같다
- 가격은 2026-09-28 조회값이다
- 판단 : 저장소를 골라 넣고 트리거를 싸게 시작한다. 그다음 저장소별 평균 리뷰 비용 칸과 주간 비용 차트로 잰다. 그 뒤 저장소를 추가한다. 월 지출 상한도 걸 수 있다.
- 등급 : 계산 (비용·lever 는 확인이다. "시범 후 확대" 순서는 업계 일반이다)
- 근거 : code-review
4. 같은 세션 리뷰가 괜찮을 때?
- 조건 : 한 줄 수정 뒤 같은 세션에서 "방금 고친 거 한번 봐" 라고 한다.
- 판단 : 공식은 새 컨텍스트가 더 낫다(improves)고 했다. 같은 세션 확인을 금지하지는 않았다. 공식 방향은 오래 무인으로 돈 작업일수록 독립 검사가 중요하다는 것이다. 그래서 작고 지켜본 변경이면 같은 세션 확인도 설 자리가 있다. 무인·큰 변경이면 새 컨텍스트가 리뷰한다.
- 등급 : 업계 일반 (공식 두 문장 "improves" · "The longer Claude works unattended, the more an independent check matters" 을 이어 읽은 해석)
- 근거 : best-practices · Skilljar cci 486938 ("The less you watched, the more you verify.")
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "지적이 많으니 '고심각도만 보고' 로 바꾼다" | 알림 수가 바로 준다 | 찾아 놓고 보고하지 않는다. 그래서 재현율이 떨어진다. 거르기는 뒤 단계에서 한다 | prompting-claude-opus-4-8 | |
| "'보수적으로' 같은 말은 아무 효과가 없다" | 막연한 말이라 무시될 것 같다 | 효과가 있다. 보고를 줄여 정밀도↑·재현율↓ 가 된다. 효과의 방향이 문제다 | prompting-claude-opus-4-8 | |
| "'중요한 것만' 으로 한 번에 거른다" | 짧고 명확해 보인다 | 두루뭉술한 말이다. 판정선을 구체적으로 쓴다 | prompting-claude-opus-4-8 | |
| "쓴 세션에 '스스로 다시 검토해'" | 맥락을 가장 잘 알고 있다 | 자기 코드에 치우친다. 새 컨텍스트가 리뷰한다 | best-practices | |
| "리뷰어 지적을 전부 고친다" | 꼼꼼해 보인다 | 과설계가 된다(추상화·방어 코드·불가능한 경우 테스트) | best-practices | |
| "Code Review 로 머지를 차단" | 리뷰를 게이트로 생각한다 | 승인·차단을 하지 않는다. check run 은 늘 neutral 이다. 게이트는 내 CI 가 만든다 | code-review | |
| "새 모델이 버그를 덜 찾으니 되돌린다" | 수치가 떨어진다 | 하네스 효과일 가능성이 있다. 보수적 문구를 먼저 걷어낸다 | prompting-claude-opus-4-8 | |
| "전사 저장소에 매 push 트리거로 한 번에" | 빨리 효과를 본다 | 리뷰 수 = push 수라 비용이 곱으로 늘어난다. 골라 넣고 추가한다 | 계산 | 뒤집히는 때 3 |
| "팀 리뷰 규칙은 CLAUDE.md 에 길게" | 늘 읽히는 파일이다 | 관리형 리뷰는 CLAUDE.md 위반을 nit 로만 본다. 리뷰 전용 규칙은 REVIEW. 가 더 확실히 닿는다 | code-review |
참고
더 깊이 : CCA-F · 출처 · 상태 · 미해결 (참고)
CCA-F
겹침 (4.6 다중 인스턴스·다중 패스 리뷰, 만든 쪽에게 채점을 맡기지 않는다 · 4.1 명시적 기준으로 오탐 줄이기, '보수적으로' 같은 말은 기준이 아니다). 여기서는 팀이 리뷰봇을 운영하는 상황을 묻는다. "지적이 많다" 는 불만에 어디서 거르나(찾기 vs 뒤 단계)를 묻는다. 어떻게 넓히나(저장소 · 트리거 · 비용)도 묻는다
출처
- 가이드 목표 7.2 공식 시험 가이드 v1.0
- prompting-claude-opus-4-8
- best-practices
- code-review
- github-actions
- Skilljar cci 486936 — 전부 2026-09-28 조회
상태
- 업계 일반 1줄(⑥ 시범 순서)
미해결
- 목록 7.2③ 의 "3~5개로 시범" 수치를 원문에서 못 찾았다. code-review · github-actions · best-practices · common-workflows · prompting-claude-opus-4-8 (en)에서
pilot|roll ?out|start small|3-5|3 to 5|a few repositor를 검색해 0건이었다. 같은 식이 best-practices "Test on a few files" 는 잡았다(양성 대조 통과). 가장 가까운 공식 문장은 대량 fan-out 을 "처음 2~3개 파일로 프롬프트를 다듬고 전체로" 하라는 것이다(best-practices). 이것은 리뷰 도입이 아니라 배치 마이그레이션 얘기다. 시범, 측정, 확대 순서를 말하는 문장은 없다. 그래서 카드에는 업계 일반으로만 둔다. (제외 = routines·analytics 문서는 받지 않았다) - "전부 보고하고 뒤에서 거르기" 원문은 Opus 4.8 전용 프롬프트 가이드(2026-05-28 출시 모델)에 있다. 일반 prompting-best-practices(en)에는
severity·review로 검색해도 같은 문장이 없었다. 그래서 다른 모델에도 같은 권고인지는 공식 문장이 없다. 원리(찾기/거르기 분리)는 관리형 Code Review 구조(code-review)와 같은 방향이다. - Code Review 는 research preview 다. 가격($15~25), 트리거,
REVIEW.md동작이 바뀔 수 있다 (Skilljar cci 486936 도 "expect the behavior to keep moving"). - 목록 영상 근거(Part 16 [10:58]·[12:00])는 유튜브 원문과 대조하지 않았다.