◆ 검색 실패 vs grounding 실패
표시가 없는 문장은 공식 문서에서 확인한 내용이에요. 다른 표시는 읽는 법
왜 배우나 — 시험이 요구하는 것
시험 목표 4.4 문제 진단 · D4 평가 16%Diagnose system issues (prompt failure, hallucinations, model mismatch)
이 개념으로 푸는 판단 (할 수 있어야 하는 것)
- 4.4② 정답 근거가 검색됐는데 답이 그걸 무시한다 — 검색 실패 vs 생성 단계(근거 충실도) 실패를 가르고 대책 고르기
- 4.4① 문서 갱신 뒤 자신 있게 틀린다 — 모델·지연은 그대로 — 어느 계층부터 조사하나 (첫 질문 = 증상 직전에 무엇이 바뀌었나)
한눈에
ELI5
친구에게 책을 펼쳐 주고 질문했는데 틀리게 답했어요.
- 먼저 봐요. 내가 펼쳐 준 쪽에 답이 있었나?
- 없었다면 친구 잘못이 아니라, 쪽을 잘못 펼친 거예요.
- 있었는데 틀렸다면, "책에 있는 말만 해" 하고 약속을 받아요.
- 목소리를 낮추라고(설정 바꾸기) 해도 답이 맞아지진 않아요.
개념 설명
원리
두 단계, 두 가지 실패
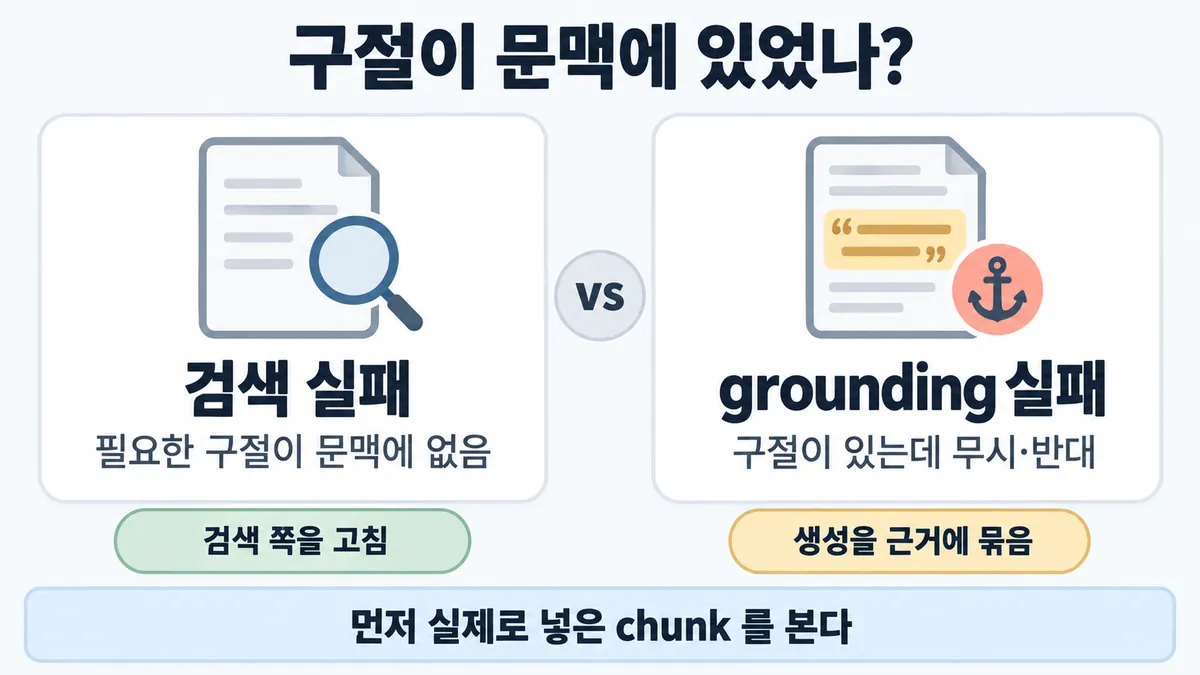
- RAG 는 두 단계다. 먼저 검색(retrieval)이 관련 chunk 를 찾아 문맥에 넣는다. 그다음 생성이 문맥을 읽고 답한다.
- 검색 실패는 필요한 구절이 문맥에 없는 것이다(또는 낡은 버전이 들어간 것이다). 모델은 없는 것을 못 본다.
- 생성 실패는 필요한 구절이 문맥에 있는데 답이 그것을 무시하거나 반대로 말하는 것이다.
- 둘을 가르는 것은 "실제로 넣은 문맥"을 보는 것 하나다. 여기서 갈리면 대책이 정반대가 된다.
검색은 따로 잴 수 있다
- 공식 실험은 검색만 따로 잰다. 지표는 상위 20개 chunk 에 정답 chunk 가 없는 비율(1 − recall@20)이다.
- 그래서 "검색이 성공했나"는 생성과 분리해 확인할 수 있는 질문이다.
생성을 근거에 묶는 수단 (환각 줄이기 문서)
- 기본 수단은 '모른다' 허용, 긴 문서(2만 토큰 초과)는 원문 그대로 인용 먼저, 주장마다 인용하고 못 찾으면 철회다.
- 고급 수단은 단계별 추론(reasoning) 검증, Best-of-N, 반복 다듬기, 넣어 준 문서만 쓰기다.
- 이 문서에는 temperature 가 없다. temperature 는 샘플링의 무작위를 조절할 뿐이다. 근거에 묶는 장치가 아니다. 게다가 폐기 예정이다. Opus 4.6 뒤에 나온 모델은 1.0 외 값을 400 으로 거절한다. 0.0 이어도 완전히 결정적이진 않다.
그 사이에 있는 것
- chunk 를 너무 많이 넣으면 모델이 산만해질 수 있다. 그러면 구절은 "있는데" 묻힌다. lever(조절 수단)는 검색 쪽(chunk 수·리랭킹)이지만 증상은 생성 실패처럼 보인다.
규칙과 판단
갈림길
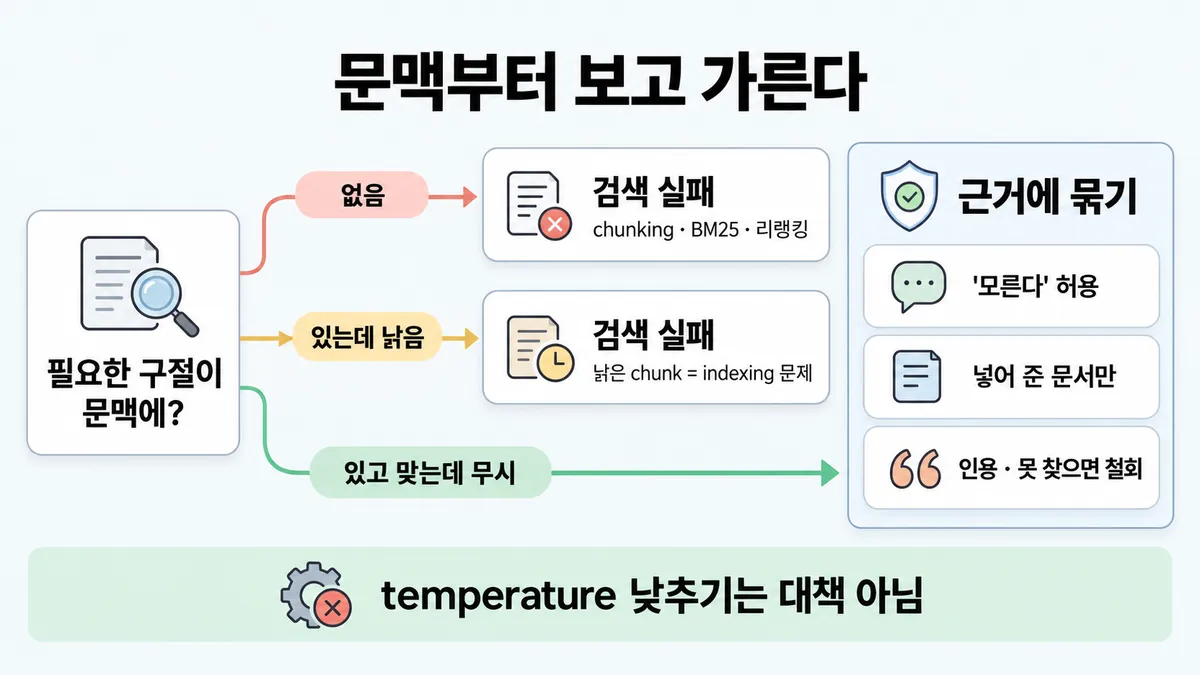
문맥부터 보기 [4.4②]
검색 실패
검색(retrieval) 쪽을 고친다. 자세한 것은 ■ RAG 파이프라인 · ◆ 임베딩 vs BM25 vs hybrid 에 있다
검색 실패
낡은 chunk 는 indexing(색인) 문제다. 자세한 것은 ■ 변경부터 묻는 진단 에 있다
개수는 실험으로 정한다
더 넣으면 모델이 산만해질 수 있다
다음 물음 — 무엇이 보이나?
grounding 강화 [4.4②]
'모른다' 를 허용한다
불확실을 인정해도 된다고 명시한다
인용 먼저
원문 그대로 인용을 먼저 뽑고 작업한다
넣어 준 문서만
넣어 준 문서의 정보만 쓰고, 일반 지식은 쓰지 말라고 명시한다
인용으로 검증한다
주장마다 인용·출처를 단다. 못 찾으면 철회한다
추론 검증 · Best-of-N · 반복 다듬기
고급 수단은 셋이다. 단계별 추론(reasoning) 검증, Best-of-N(같은 프롬프트를 여러 번 돌려 서로 다르면 환각 신호), 반복 다듬기다
흐름
그림 속 이름·금액·시간·토큰 수는 예시예요. 공식 한도·동작은 카드 본문 값이 기준.
장면 글로 보기
칸 : 질문 → 검색 → 문맥 → 모델
규칙 (문맥) : 필요한 구절이 실제로 들어갔나 먼저 본다
질문 : 필요한 구절이 문맥에 들어갔을까?
① 구절이 없으면 검색을 고친다 ✓
- 시작 : 질문 — 말 : “소파도 반품되나요?”
- 찾기 : 질문 → 검색 : 관련 chunk 를 찾는다 — 쪽지 : query : 소파 반품
- 넣기 : 검색 → 문맥 : 필요한 구절이 없다 — 쪽지 : chunk 1 : 의류 반품 30일 / chunk 2 : 배송비 안내 / (가구 조항 없음)
- 진단 : 문맥 : 검색 실패다 — 쪽지 : → 검색 쪽을 고침 / chunking / BM25 · 리랭킹
- 끝 : 필요한 구절이 문맥에 없으면 검색 실패다. 검색 쪽을 고친다
② 있는데 무시하면 grounding 강화 ✓
- 시작 : 질문 — 말 : “소파도 반품되나요?”
- 찾기 : 질문 → 검색 : 관련 chunk 를 찾는다 — 쪽지 : query : 소파 반품
- 넣기 : 검색 → 문맥 : 필요한 구절이 있다 — 쪽지 : chunk 3 : "가구는 / 배송 후 7일 안 반품"
- 읽기 : 문맥 → 모델 : 답이 근거와 반대다 — 말 : “30일 안에 반품돼요.”
- 강화 : 모델 : 넣어 준 문서만 쓰고 주장마다 인용한다 — 쪽지 : 인용 : chunk 3 "7일" / 답 : 7일 안에 반품돼요
- 끝 : 구절이 문맥에 있으면 생성 실패다. 검색은 이미 성공했다. 생성을 넣어 준 근거에 맞춘다
③ temperature 를 낮춘다 ≠
- 시작 : 질문 — 말 : “소파도 반품되나요?”
- 찾기 : 질문 → 검색 : 관련 chunk 를 찾는다 — 쪽지 : query : 소파 반품
- 넣기 : 검색 → 문맥 : 필요한 구절이 있다 — 쪽지 : chunk 3 : "가구는 / 배송 후 7일 안 반품"
- 설정 : 모델 : temperature 를 낮춘다 — 쪽지 : temperature : 0.2 / → 400 (Opus 4.6 뒤 모델)
- 끝 : temperature 는 환각 줄이기 문서에 없는 수단이다. Opus 4.6 뒤에 나온 모델은 400 으로 거절한다
규칙 원문 갈림 기준 (갈림길로 그린 규칙)
갈림 기준
필요한 구절이 문맥에 실제로 들어갔나? 이것을 먼저 본다
- 필요한 구절이 문맥에 없으면 검색 실패다. 검색 쪽에서 고칠 곳은 아래와 같다
- chunking
- chunk 앞 문맥 붙이기
- 임베딩 + BM25
- 리랭킹
- 넣는 chunk 수
- 자세한 것은 ■ RAG 파이프라인 · ◆ 임베딩 vs BM25 vs hybrid 에 있다
- 검색은 따로 잰다. 공식 실험 지표는 상위 20개에 정답 chunk 가 없는 비율이다. 자세한 것은 ■ RAG 파이프라인 에 있다
- 구절이 있는데 낡았으면(문서 갱신 뒤) 역시 검색 실패다. 낡은 chunk 는 indexing 문제다. 자세한 것은 ■ 변경부터 묻는 진단 에 있다
- 구절이 너무 많은 chunk 에 묻혔으면 개수를 실험으로 정한다. 더 넣으면 모델이 산만해질 수 있다. 공식 실험에서는 5·10·20 중 20 이 최선이었다
- 구절이 있고 맞는데 답이 무시하거나 반대로 말하면 생성(근거 충실) 실패다. 검색은 이미 성공했다. 그래서 재임베딩·리랭킹이 아니라 생성을 넣어 준 근거에 맞춘다
- 기본 수단은 셋이다
- '모른다' 를 허용한다(불확실을 인정해도 된다고 명시한다)
- 긴 문서(2만 토큰 초과)는 원문 그대로 인용을 먼저 뽑고 작업한다
- 주장마다 인용·출처를 단다. 답한 뒤 인용을 찾아 검증하고, 못 찾으면 철회한다
- 고급 수단은 넷이다
- 단계별 추론을 검증한다
- Best-of-N : 같은 프롬프트를 여러 번 돌린다. 서로 다르면 환각(hallucination) 신호다
- 반복해서 다듬는다
- 넣어 준 문서의 정보만 쓰고, 일반 지식은 쓰지 말라고 명시한다
- 긴 문서면 놓는 순서도 본다. 문서는 맨 위에 두고, 질문·지시는 그 아래에 둔다. 자세한 것은 ◆ RAG vs full context 에 있다
- temperature 는 대책이 아니다. 환각 줄이기 문서(reduce-hallucinations)에 없다. 폐기 예정(Deprecated)이다. Opus 4.6 뒤에 나온 모델은 1.0 외 값을 400 으로 거절한다. 0.0 이어도 완전히 결정적이진 않다
- Python SDK v1.0 은 Messages 메서드에서
temperature·top_p·top_k자체를 뺐다 (2026-08-20 — 시험 뒤 변경) - 구절이 없는데 "인용하게·넣어 준 문서만" 으로 대응하면 안 된다. 없는 근거에는 묶을 수 없다. 검색부터 고친다 업계 일반
더 깊이 : 판단 규칙 · 상황 변수 (설명)
판단 규칙
| 조건 | 답 | 근거 |
|---|---|---|
| 필요한 구절이 문맥에 없다 | 검색 쪽을 고친다. ■ RAG 파이프라인 에 있다 | Contextual Retrieval(문맥이 빠지면 관련 정보를 못 찾음) ·(검색 지표) |
| 문서 갱신 뒤 낡은 chunk 가 들어갔다 | 검색·indexing(색인) 문제다 | 가이드 샘플 3 정답 B "irrelevant or stale chunks" |
| 구절이 있는데 답이 무시하거나 반대로 말한다 | 생성을 근거에 묶는다 (재임베딩·리랭킹이 아니다) | reduce-hallucinations |
| 긴 문서(2만 토큰 초과)다 | 원문 그대로 인용을 먼저 뽑고 작업한다 | reduce-hallucinations |
| 주장을 검증한다 | 주장마다 인용한다. 못 찾으면 철회한다 | reduce-hallucinations |
| 일반 지식이 섞인다 | 넣어 준 문서의 정보만 쓰라고 명시한다 | reduce-hallucinations |
| 긴 문서를 full context(문서 전체를 넣기)로 넣는다 | 문서는 맨 위, 질문·지시는 아래에 둔다. 관련 부분을 먼저 인용하게 한다 | prompting-best-practices |
| "temperature 를 낮추자" 고 한다 | 대책이 아니다. 새 모델은 400 을 낸다 | messages-create · 환각 줄이기 문서에 없다(전문 18줄 확인) |
| chunk 가 너무 많다 | chunk 수를 실험으로 정한다 (공식 실험은 20) | Contextual Retrieval |
상황 변수
| 변수 | 값 | 답 쪽 | 등급 | 근거 |
|---|---|---|---|---|
| 필요한 구절 | 문맥에 없다 | 검색 | 판단 규칙 1 | |
| 필요한 구절 | 있는데 구버전이다 | 검색·indexing | 판단 규칙 2 | |
| 필요한 구절 | 있고 맞다 | 생성 | 판단 규칙 3 | |
| 문맥 길이 | 2만 토큰 초과다 | 인용 먼저 기법이 조건에 맞는다 | reduce-hallucinations | |
| 문맥 길이 | 2만 토큰 미만이다 | 인용 먼저는 조건 밖이다. '모른다' 허용 · 넣어 준 문서만 · 인용 검증을 쓴다 | 같은 문서 | |
| 넣은 chunk 수 | 아주 많다 | 산만해진다. chunk 수·리랭킹을 본다 | Contextual Retrieval | |
| 모델 세대 | Opus 4.6 뒤에 나온 모델이다 (Opus 4.7·4.8 · Sonnet 5 등) | temperature 1.0 외 값은 400 이다 | messages-create · 릴리스 노트 | |
| 모델 세대 | 그 이전 모델이다 | temperature 설정은 되지만 환각 대책은 아니다 | reduce-hallucinations 전문(temperature 가 없다) | |
| SDK | Python SDK v1.0 이상이다 | temperature 파라미터 자체가 없다 | 시험 뒤 변경 | 릴리스 노트(2026-08-20) |
| 답의 흔들림 | 같은 질문에 답이 매번 다르다 | Best-of-N 비교로 환각(hallucination) 신호를 잡는다 | reduce-hallucinations |
연습 문제
소파 반품 문의에 넣은 문맥 chunk 에 "가구는 배송 후 7일 안 반품" 구절이 그대로 들어 있다구절 있음. 그런데 답은 흔한 30일 반품 규칙을 섞어일반 지식 "30일 안에 반품돼요" 라고 한다. 팀원은 temperature 를 낮추자고 한다. 무엇을 할까?
시험 대비
함정
- "temperature 를 낮춘다" 는 함정이다. 환각 줄이기 문서에 없다. Opus 4.6 뒤에 나온 모델은 400 을 낸다
- 구절이 문맥에 있는데 "재임베딩·리랭킹" 을 하는 것은 함정이다. 검색은 이미 성공했다. 생성을 넣어 준 근거에 맞춘다
- 낡은 chunk 가 들어갔는데 "grounding 실패(근거 무시)"로 보는 것은 함정이다. 낡은 chunk 는 indexing 문제다
- "인용만 뽑게 하면 끝" 은 함정이다. 인용을 못 찾으면 그 주장을 철회까지 한다
- "chunk 를 많이 넣을수록 안전" 은 함정이다. 더 넣으면 모델이 산만해질 수 있다
- "더 큰 모델로 바꾸면 근거를 지킨다" 는 함정이다. 근거에 묶는 기법이 먼저다 업계 일반
- Skilljar API 강의(2025 제작 추정)는 "사실 답·일관성엔 낮은 temperature · 0.0 = 완전 결정적" 이라고 한다. 지금 docs 는 폐기 예정이라고 한다. 0.0 이어도 완전히 결정적이진 않다
신호
"For tasks involving long documents (>20k tokens), ask Claude to extract word-for-word quotes first before performing its task."
"If it can't find a quote, it must retract the claim."
"Explicitly instruct Claude to only use information from provided documents and not its general knowledge."
"Inconsistencies across outputs could indicate hallucinations."
"However, more information can be distracting for models so there's a limit to this."
"Deprecated. Models released after Claude Opus 4.6 do not support setting temperature."
"Note that even with temperature of 0.0, the results will not be fully deterministic."
더 깊이 : 뒤집히는 때 · 오답 재료 (설명)
뒤집히는 때
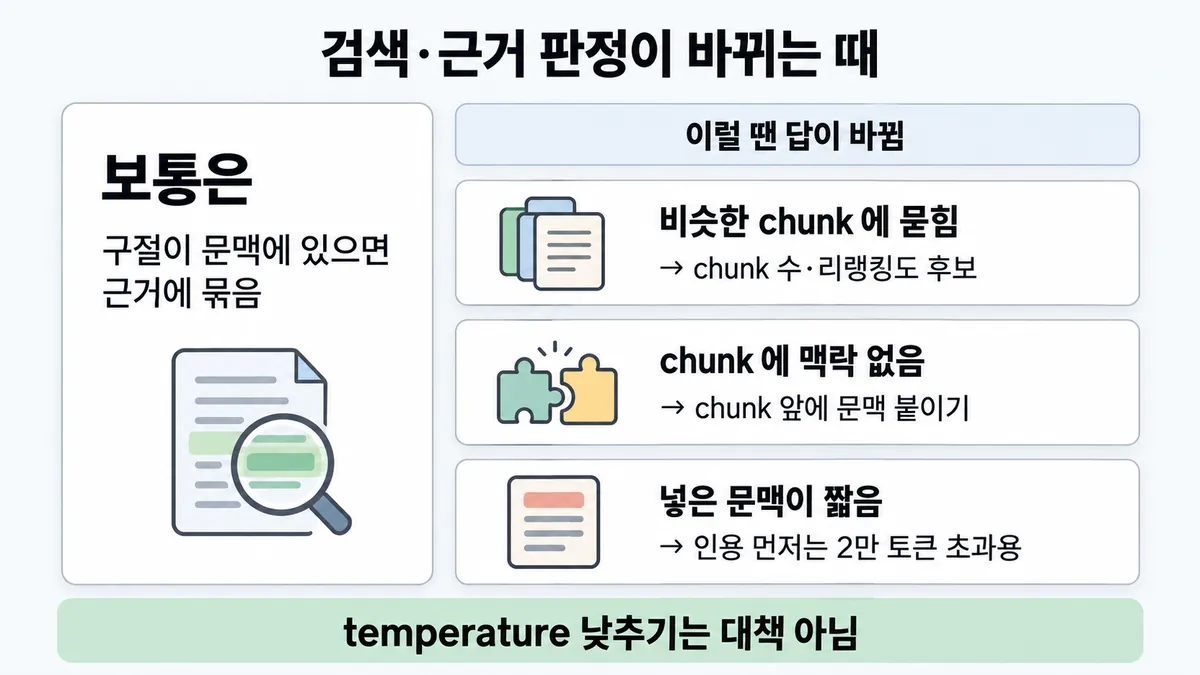
1. 구절은 있는데 25개 chunk 속에 묻힌 때
- 조건 : 환불 규정 chunk 가 문맥에 있다. 다만 비슷한 chunk 25개와 같이 들어갔다. 답이 규정과 어긋난다.
- 판단 : 겉으로는 "grounding 실패(근거 무시)"다. 그러나 공식 글은 chunk 가 많으면 모델이 산만해질 수 있다고 한다. 그래서 인용 지시와 함께 chunk 수·리랭킹(검색 쪽 lever)도 후보다.
- 등급 : (산만해짐) · 25개 예시는 새로 고른 값
- 근거 : Contextual Retrieval(5·10·20 중 20 이 최선, 사례마다 실험)
2. 구절은 있는데 chunk 에 맥락이 없어 못 쓴 때
- 조건 : chunk 에 "매출이 3% 늘었다"만 있다. 어느 회사의 어느 분기인지는 없다.
- 판단 : 모델이 근거를 무시한 게 아니다. 근거가 불완전한 것이다. 공식 글은 chunk 앞에 문맥을 붙이는 Contextual Retrieval 이 검색뿐 아니라 생성도 도울 수 있다고 적는다.
- 근거 : Contextual Retrieval
3. temperature 를 여전히 받는 옛 모델
- 조건 : Haiku 4.5 는 Opus 4.6 전에 나온 모델이다. 그래서 temperature 를 0.2 로 넣어도 400 이 안 난다.
- 판단 : 설정은 되지만 환각 줄이기 문서가 드는 수단이 아니다. 0.0 이어도 완전히 결정적이진 않다. 답은 여전히 grounding 강화다.
- 등급 : (Haiku 4.5 출시 2025-10-15 는 Opus 4.6(2026-02-05) 전이다)
- 근거 : messages-create · reduce-hallucinations 전문 · 릴리스 노트
4. 문맥이 짧아 "인용 먼저"가 조건 밖인 때
- 조건 : 넣는 chunk 합계가 약 7천 토큰이다.
- 판단 : "원문 인용 먼저"는 2만 토큰 초과 긴 문서용으로 적혀 있다. 짧으면 '모른다' 허용 · 넣어 준 문서만 · 주장마다 인용 검증이 먼저 드는 수단이다.
- 등급 : (조건 문구) · 짧은 문서에 인용 먼저가 해롭다는 공식 문장은 없다. 그래서 보기로 나오면 약한 오답일 뿐이다
- 근거 : reduce-hallucinations
오답 재료
| 오답 | 왜 끌리나 | 왜 틀리나 | 등급 | 근거 |
|---|---|---|---|---|
| "temperature 를 낮춘다" | 옛 강의가 "낮으면 사실적" 이라고 설명했다 | 환각 줄이기 문서에 없다. 폐기 예정이다. 새 모델은 400 을 낸다. 0.0 도 완전히 결정적이지 않다 | messages-create · Skilljar 287728(옛 설명) | |
| 구절이 있는데 "재임베딩·리랭킹" | 검색이 늘 범인 같다 | 검색은 이미 성공했다. 생성을 근거에 묶는다 | reduce-hallucinations | |
| 구절이 없는데 "인용하게·넣어 준 문서만" | 환각 대책처럼 보인다 | 없는 근거에는 묶을 수 없다. 검색부터 고친다 | 업계 일반 | — |
| "더 큰 모델로 바꾼다" | 큰 모델이 더 성실할 것 같다 | 환각 줄이기 문서의 수단은 모델 교체가 아니다 | 업계 일반 | reduce-hallucinations 전문 |
| "chunk 를 더 많이 넣는다" | 많이 넣으면 빠질 일이 없을 것 같다 | 더 넣으면 모델이 산만해질 수 있다 | Contextual Retrieval | |
| "인용만 뽑게 하면 된다" | 인용이 곧 근거 같다 | 인용을 못 찾으면 철회까지 해야 검증이다 | reduce-hallucinations | |
| "0.0 이면 매번 같은 답" | 옛 강의가 "completely deterministic" 이라고 했다 | 0.0 도 완전히 결정적이진 않다 | messages-create · Skilljar 287728 |
참고
함께 보기
더 깊이 : 출처 · 상태 · 미해결 (참고)
출처
- 가이드 목표 4.4 공식 시험 가이드 v1.0
- 샘플 3 공식 시험 가이드 v1.0
- docs reduce-hallucinations
- messages-create
- prompting-best-practices
- Contextual Retrieval 글
- 릴리스 노트
- Skilljar API 287728
상태
- 업계 일반 2줄
- 시험 뒤 변경 1곳(Python SDK v1.0 temperature 제거)
미해결
- 목록 4.4② 의 "context recall · faithfulness" 는 RAGAS 용어다. 받아 둔 Anthropic 원문에는 없다(
ccarp/raw/official-docs전체 grep 0 · 제외 = 안 받은 문서). 보기 표현이 다를 수 있다. - 목록 4.4② 는 temperature 폐기를 "Opus 4.6 이후 출시 모델"로 적었다. 원문은 "Models released after Claude Opus 4.6"(Opus 4.6 뒤에 나온 모델, 4.6 자체는 아님)이다. 카드에는 원문대로 적었다.
- Citations API(인용 기능) 원문은 받지 않았다. 인용 검증을 API 기능으로 묻는 보기가 나오면 확인해야 한다.
- 실제로 넣은 문맥을 보려면 요청 내용을 기록해야 한다. 기록 범위는 ■ 텔레메트리 기록 범위 쪽에서 판단한다. 여기서는 다루지 않는다.